
别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
一个本可直接推理的问题,Agent 却连续搜索网页、调用多个工具。任务虽然完成了,时间和费用也多花了不少。另一种情况是,问题需要实时信息,Agent 却一直在模型内部推理,最后给出流畅但没有依据的答案。
前一种情况属于过度行动(overacting);后一种往往同时涉及过度思考(overthinking)和行动不足(underacting)。要避免这类决策失误,Agent 需要判断哪些问题可以自行解决,哪些必须向外部世界寻求信息或执行能力。
这篇综述梳理了约 600 项近期研究,用内化(internalization)与外化(externalization)这一统一视角,分析 Agent 从设计到学习、对齐、演化和评测的全过程。
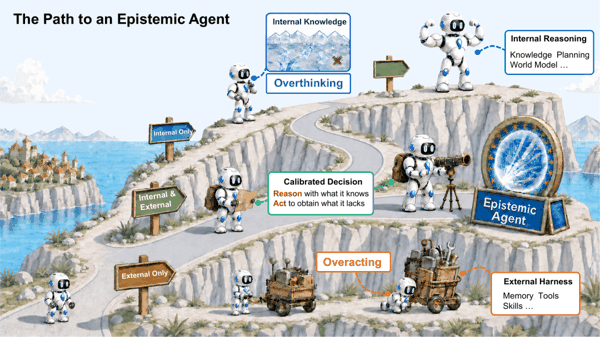 通往认知型智能体(Epistemic Agent)的路径。Agent 根据模型内部知识与外部 harness 的能力,校准思考和工具调用的决策。
 论文题目: Theory of Agent: The Science of Internalization and Externalization for LLM-based Agents
作者: Zihao Cheng*, Yixia Li*, Shengbin Yue*, Yuheng Lu*, Yuli Qiu, Yanzhi Tian, Haohuinan Zhang, Cheng Qian, Hongru Wang, Guanhua Chen, Zeming Liu†, Yuhang Guo, Zhongyu Wei, Ke Gu, Liang Li, Jeff Z. Pan, Amos Storkey, Yunhong Wang, Haifeng Wang
作者单位: 北京航空航天大学、南方科技大学、复旦大学、北京理工大学、爱丁堡大学、北京工业大学、中国科学院计算技术研究所、百度
论文链接: https://www.preprints.org/manuscript/202609.0308
GitHub: https://github.com/BUAA-IRIP-LLM/Awesome-LLM-Powered-Agent
作者标记:* 共同一作,† 通讯作者。
模型与 Harness,能力放在哪一侧?
LLM Agent 通常由模型和外部 Harness 两个紧密耦合的部分组成:
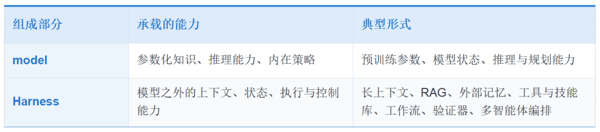 过去数年的 Agent 进展,大体围绕这两个部分展开:基础模型与推理模型的能力在增强,外部 harness 也在持续扩展。
稳定、反复使用的知识和程序适合内化进模型。这样可以减少重复检索和工具调用,降低延迟,让能力在训练中持续积累,并被后续任务复用。
实时事实、精确计算、可验证执行、可编辑记忆和环境状态则适合外化在 harness 中,以便更新信息、追溯来源和控制执行过程。
设计这样的系统时,需要同时考虑两个问题:知识、技能和控制分别放在模型参数还是外部系统;在具体步骤上,内部推理与外部行动各投入多少。
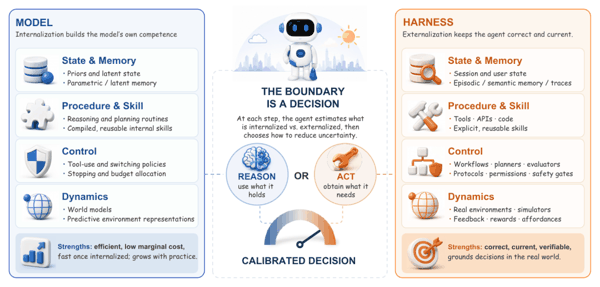 图 1:模型与 Harness 之间的能力配置。模型侧适合承载稳定、高复用、可摊销的能力;Harness 侧适合承载实时、可编辑、可验证、需要治理的能力。两者之间的边界决定 Agent 应继续推理还是采取外部行动。
这些配置问题也出现在几组常见的技术选择中:
长上下文还是 RAG;
参数化记忆还是外部记忆;
工具集成推理(TIR)还是工具内化推理(TInR);
单模型能力还是多智能体工作流;
更长的思维链还是更及时的搜索、执行与验证。
综述的四个研究问题
论文围绕内化与外化的边界,依次讨论学习、对齐、演化与评测:
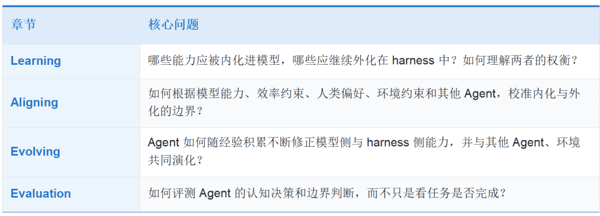
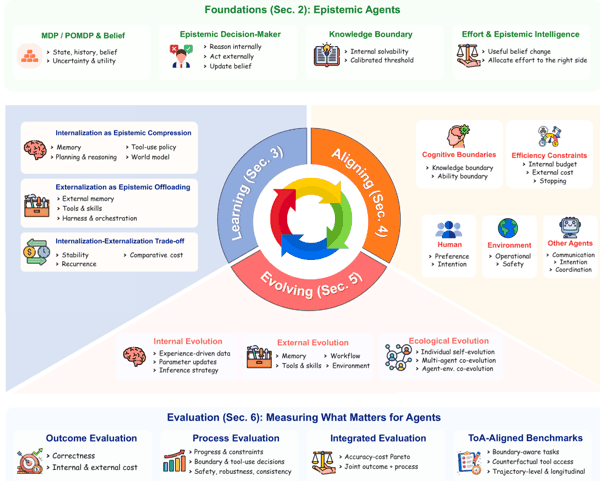 图 2:论文整体结构。Foundations 给出统一概念与形式化基础,随后依次讨论 Learning、Aligning、Evolving 和 Evaluation,最后讨论开放问题。
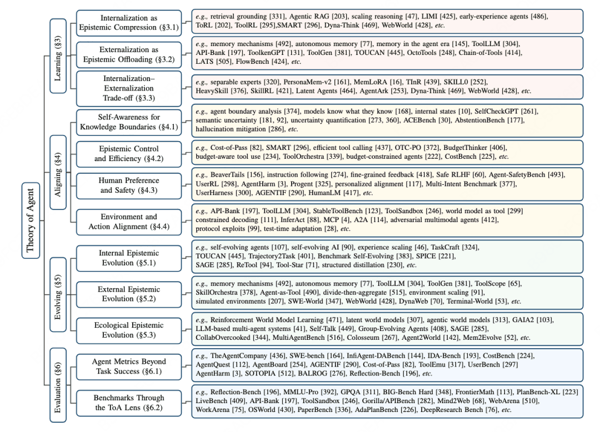 图 3:AI Agent 研究分类。相关工作按 Learning、Aligning、Evolving 与 Evaluation 四个研究问题组织,并映射到内化与外化的边界。
Foundations:Agent 如何判断下一步该做什么
传统视角通常把 Agent 描述为从状态或交互历史映射到动作的策略,重点考察任务是否完成。
这篇综述关注决策过程:Agent 在每个时刻都持有关于任务答案、下一步动作或环境状态的某种信念,并据此判断:
1. 当前信念是否已经足以作出决策;
2. 如果仍有不确定性,应该通过内部推理继续处理,还是通过外部行动获取新信息;
3. 这一步带来的信息增益,是否值得其成本与风险。
论文将 Agent 的动作空间分为两类:
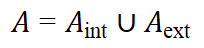 内部动作 : 思维链、反思、自洽投票、内部模拟等。它们只调用模型参数和当前上下文,不接触外部世界。
外部动作 : 检索、搜索、工具调用、代码执行、环境交互、与其他 Agent 通信等。它们从模型外部获取信息,部分动作还会改变环境状态。
推理与行动都属于减少不确定性的 “知识操作”。内部推理利用模型参数和当前上下文,外部行动则从外部世界获取信息。
知识边界会随模型、任务和环境变化
论文定义了两个任务集合:
内部任务集: 当前 Agent 仅依靠内部推理就能可靠完成的任务;
世界任务集: 在允许适当外部交互时,原则上可以在环境中完成的任务。
两者之间的分界就是 Agent 的知识边界(knowledge boundary)。不同模型的边界不同;同一模型的边界也会随任务、上下文、工具可用性、信息时效性和训练进程变化。
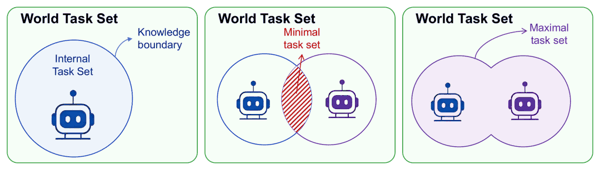 图 4:不同模型或 Agent 拥有不同的内部任务集。能力增强会扩大内部可解区域;多个 Agent 的能力也可能互补,形成更大的联合任务集。
工具的可用性与必要性需要分开判断。任务位于内部任务集时,调用工具可能有帮助,但并非必需;当任务超出内部能力时,外部行动才具有认知必要性。
四种常见失误,如何对应边界误判?
论文从边界估计和行为表现两个维度解释常见失败:Agent 可能高估或低估自身能力,相应的失误则出现在推理侧或行动侧。
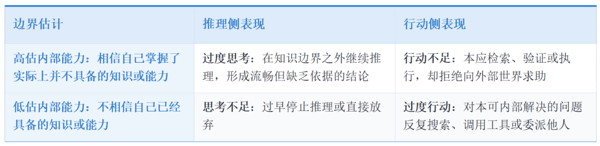 工具调用次数和推理长度都不能单独用来判断决策好坏。Agent 需要根据自身能力、任务要求和外部成本,找到合适的 operating point。
认知努力:推理与行动各投入多少?
论文将任务中的认知努力分解为:
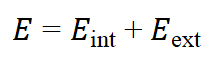 其中,
是外部行动成本,例如 API 调用、网络等待、货币费用、权限暴露和不可逆副作用。
是内部推理成本,例如推理 token、搜索深度和延迟;
切换策略会改变任务信息负担的承担方式,却不会让它消失。更强的模型可以在内部处理更多工作,较弱的模型可能更依赖外部 harness。两者都需要合理分配内部推理与外部行动,避免无效投入。
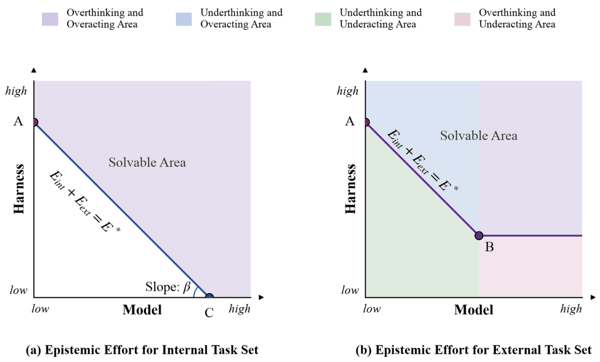 图 5:内部任务与外部任务对应不同的理想努力分配点。过度思考、思考不足、过度行动和行动不足,都是偏离理想点的边界失准。 论文用认知智能比率(epistemic intelligence ratio)衡量单位努力带来的有效信息增益:
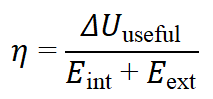 其中,
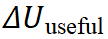
表示有助于下游决策的不确定性减少。在四类失准行为中,分母所代表的成本持续增加,分子所代表的有用信息增益却没有相应增长。
论文将 η 作为认知智能的可观测指标,但它无法完整定义认知智能。Agent 还需要识别自身边界,合理分配内外部努力,在两侧都无法解决问题时合理拒绝,并通过学习扩大内部能力边界。
Learning:如何配置模型与 Harness 的能力
在这一框架中,学习要决定哪些能力通过训练进入模型,哪些继续由外部系统提供。
对应的两条路线是内化与外化:
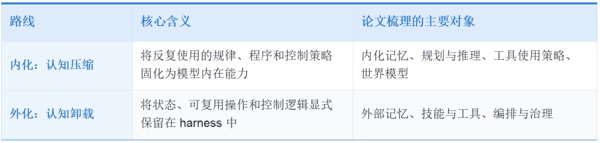
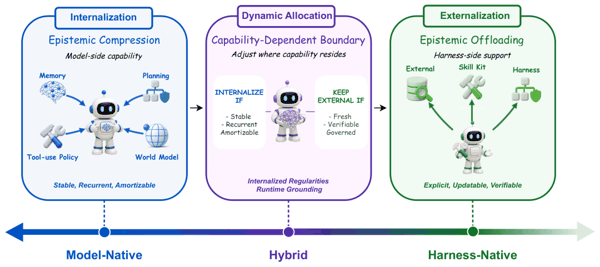 图 6:从 model-native 到 harness-native 的能力配置连续谱。动态配置层依据当前能力边界,决定哪些能力进入模型,哪些留在外部系统。
内化:将反复使用的过程转为模型能力
论文从四个方面梳理内化研究:
1. 内化记忆通过保存和学习历史信息,影响模型后续行为。稳定的用户规律、反复出现的任务模式和高频经验,可以逐步进入模型状态、适配器或参数。
2. 内化规划与推理,把任务分解、搜索、反思和验证等临时生成的过程,转化为较稳定的程序性能力。
3. 内化工具使用策略,既学习工具调用格式,也学习何时调用、选择哪个工具、如何构造参数,以及如何根据返回结果继续决策。
4. 内化世界模型,通过学习环境动力学和动作后果,在执行前进行内部模拟,减少昂贵或不可逆的试错。
外化:让能力保持显式、可编辑、可验证
外部支持包括记忆、技能和编排三类:
1. 外部记忆保存不断变化的状态、交互历史和证据,并通过写入、检索、合并、遗忘等操作管理信息生命周期。
2. 外部技能将程序性知识封装为可检查、可复用、可组合的操作单元,避免每次从头生成流程。
3. 外部编排把控制流、权限、验证、回滚、Agent 协作和工具协议放在 harness 中,使执行过程可观察、可恢复、可治理。
什么时候应该内化,什么时候应该外化?
选择内化或外化时,论文建议考虑以下维度:
稳定性:是否长期不变;
复现频率:是否会高频重复;
摊销价值:训练一次后能否在大量任务中降低成本;
新鲜度:是否必须实时更新;
可验证性与可回滚性:是否需要保留来源、审计和撤销能力;
用户控制与安全治理:是否应允许用户编辑,或必须由外部权限系统约束。
长期稳定、经常复现且有摊销价值的规律,适合内化;实时变化、高风险或需要审计的证据与操作,适合保留在外部。许多实际系统最终会采用混合配置:模型内化通用策略,harness 提供实时证据、执行接口和安全边界。
Aligning:校准思考、行动、委派与停止的时机
传统 LLM 对齐主要关注输出是否符合人类偏好。Agent 进入真实环境后,还需要决定是否检索、调用工具、执行动作、与其他 Agent 协作,以及何时停止。对齐因此也要覆盖这些决策。
论文将这些决策纳入统一规则,并依据五类约束进行校准: