
全行业两年攒下百万小时数据,影溯想1个月生产完:全国首个具身仿真数采中心落地杭州
产能公式从“人×小时”,变成“环境配置数×并行算力”。
作者丨 幸丽娟
编辑丨 岑 峰
训练一个可用的具身智能模型, 需 要千 万小时 的多模态交互数据;而 现实仅有百万小时 ,剔除低质部分后,真正可用的更少。
缺数据,是具身智能行业的共识。
但只盯着“数据”这两个字,会错过更关键的问题:
一台机器人在固定货架前抓取,成功率可以很高。货架挪个方向,目标前多放一排饮料,换一侧伸手,成功率就往下掉。练过的,它能一遍遍做对;没练过的,它连手该从哪边伸都不知道。
行业缺的不只是数据量,还有“数据里的变化”。
过去两年,补缺口的主流办法是建场地、加采集人手。
据中国信息通信研究院,截至今年6月底,全国共建成启用超过70家训练场,另有40 余家在建或规划。
然而,大量训练场集中在叠衣服、收拾桌面、分拣搬运这类易展示任务上,复杂长程任务挖掘严重不足。数据小时数在涨,模型见过的空间布局没涨。
问题出在扩容的对象上。加场地,加采集人手,扩的是同一批场景的采集次数——货架还是那个货架,只是多采了几遍。
多样性要涨,靠的是条件变多 : 布局、遮挡、物体组合、接近路径,每多一种都是一次重新排列。
而一个训练场里能有多少种排列,取决于它被布置成什么样;改一次布置,采集流程就得跟着重走一遍。采集的人力、时间成本数倍往上叠。
产能越加越大,多样性原地踏步。行业真正卡住的地方,不是“采得不够多”,而是 “变一次太贵” 。
来自空间智能赛道的影溯,给出了另一种解法:不只采得多,还要穷尽空间的各种排列组合,采得“不一样”。
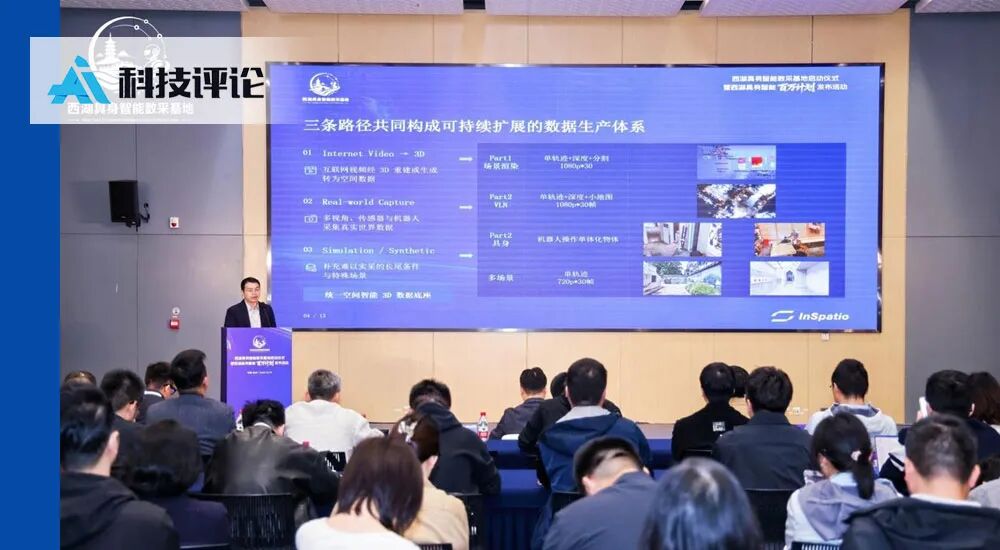
10月29日, 影溯 在杭州正式落地 全国首家以仿真为主的具身智能数采中心 ,目标将产能拉升至 月产百万小时级数据。
它以三维场景重建与生成为核心,把真实空间、生成式模型与仿真能力接到一起,做一套 可编辑、可复用、可扩展 的环境与数据供给体系。
在“真实数据为王”的共识里打出“仿真”的旗号,需要底气。
这种底气,源自影溯直接变革数采方式,同时解开数据多样性和产能两大“卡点”;更源自,它自己作为一家空间智能基模公司,最知道模型需要什么数据,以及什么才叫真正的高质量数据。
01
数据产能和多样性,
卡在“每加一种变化就重来一遍”
要看懂影溯的选择,得先看清楚它要替代的数采流程,成本到底花在哪。
EGO第一视角采集与遥操作,是具身智能获取真实行为数据的两种主要方式。EGO需要人员进入环境、完成操作;遥操需要操作者持续参与,并适应具体设备和任务。两者方式不同,但都绕不开“人”。
绕不开人,就绕不开组织。新增一种空间布局,补充一类操作条件,流程就得再走一遍:找场地,约档期,把人凑齐,设备调好,采完拆掉。
此外,采集人员的任务熟练度、操作习惯,以及对不同设备的适配程度,也会直接影响采集效率和数据一致性。
重组流程不仅繁琐,而且还没法并行。场地要一个一个谈,人要凑齐了才能开工,采完的场景拆掉就没了。
于是每增加一种变化,就要重付一次全额的组织成本。
这就是多样性涨不上去的真正原因:不是行业不想加条件,是每加一种,就得从头组织一遍,成本线性叠加。
影溯要做的,就是把这个成本降下去,同时把数据多样性拉上来。
在仿真环境里,空间布局、物体位置、遮挡关系和任务条件可以通过生成、编辑与组合来扩展,不必为每一种变化重新安排实体场地和人员操作。 同一项任务可以被放进不同的环境条件里,覆盖那些真实采集中很难穷尽的变化 。
对算法团队来说,它是扩展训练分布、复现失败条件的空间;对机器人本体厂商而言,它是一套能够反复配置和验证的环境基础。
数据多样性与产能的同步提升,还来自数据生产全流程的并行计算。
基于少量真机或遥操示范种子,系统结合运动规划、策略驱动与自动化物理质检,在 数百个并行环境 中自动批量合成对齐了 RGB、深度、分割、6D 位姿与动作指令的闭环轨迹。环境能重复使用,条件能批量调整,数据生产的规模由此随算力和任务系统扩展,而不再只随人数线性增长。
两种范式的分野就在这里:过去两年行业比的是谁的场地多、采集员多, 产能公式是“人×小时” ,小时数在涨,条件空间并没有涨; 影溯数采中心的公式是“环境配置数×并行算力” ,每多一种配置,就多一组条件覆盖,多样性跟着算力一起扩。
基于这套体系,影溯数采中心有望实现月产百万小时(或日产十万小时)的数据生产能力——这意味着 单中心短期运转的有效产出 ,就能跨越全行业过去两年攒下的 数百万小时存量总和 。
而比这些数字更关键的,是它指向的工作方式的革新: 模型在哪类遮挡、布局或操作条件下出问题,就针对这些条件扩展环境、补充样本、开展回归测试,把从发现问题到再次验证的周期压短。
数据生产与研发贴得越紧,“如何生产出高质量高需求数据”才有了方向可依,也能 少走“采了大量、却用不上”的弯路。