
被投企业「铭芯启睿」完成超4亿元A轮融资,宣布战略升级
被投企业「铭芯启睿」完成超4亿元A轮融资,宣布战略升级 | LCIG Portfolio
2026年10月20日 10:19
联想创投
10月19日,联想创投被投企业——铭芯启睿(MemSilicon)宣布完成超4亿元A轮融资。本轮融资由博原资本领投,博世创投、创领资本、米哈游、中关村科学城公司、兆易创新等跟投,老股东复容投资、国开科创、恒裕资本、锦秋基金、顺禧基金、小米战投、中科创星持续加注。本轮融资将主要用于RRAM的产业化与商业化,以及新产品LPU的研发。
MemSilicon同时宣布, 前Graphcore总裁兼大中华区总经理卢涛加入团队,担任CEO和联合创始人。 公司战略全面升级:在继续推进阻变存储器(RRAM)产品化的基础上,启动面向大模型推理的第一代LPU研发,打造“满血模型、高速Token、越级性价比”的新一代推理引擎。
随着Agentic AI时代的到来,AI落地已经从问答,转向完成复杂、长程的任务,下一步竞争的关键指标,会从峰值算力转向任务完成效率。
一次任务包含多轮推理、工具调用和上下文复用,还可能启动多个Agent并行工作。客户需要的,不只是更多Token,而是在保证质量的前提下,更快地解码和输出、更多任务能并行,并降低单次任务成本。
这要求推理系统从架构层面进行创新,同时优化计算、存储、互联和调度。因此,存算协同被视为核心破局路径之一。
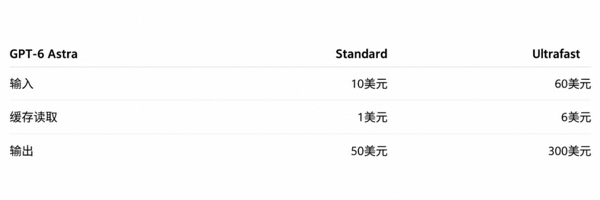 ▲ 图1|低延迟已是独立售卖的服务档位。数据来源:OpenAI
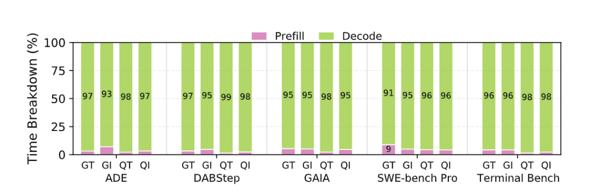 ▲ 图2|高速解码决定Agent每一步走多快。在缓存能够有效保留的条件下,输入缓存命中率为 84.6%-99.5%,解码占 LLM执行时间的91.0%-98.6%。数据来源:arxiv2605.26297v2, Agentic AI Workload Characterization
01
为什么是现在:
大模型推理进入架构创新关键期
加入MemSilicon之前,卢涛已在芯片行业深耕 20 余年。
他历任曦智科技副总裁、Graphcore总裁兼大中华区总经理、Cavium中国区总经理,长期聚焦AI基础设施核心组件,覆盖Arm架构服务器CPU、DPU、RDMA网卡、数据中心交换芯片、大SRAM架构的AI处理器IPU、基于3D堆叠DRAM的NPU,及硅光芯片等多个领域,兼具技术、产品与市场的复合视角。
卢涛对AI时代的技术演进、产品逻辑、商业模式和客户需求有深刻洞察。他认为, 大模型推理正在进入架构创新的关键期,单纯依赖单一维度的算力提升,已难以满足“低延迟、长上下文、高吞吐”的综合需求,存算协同是破局的核心路径之一。
卢涛表示:
“ MemSilicon的定位很明确,不与GPU内卷,聚焦满血模型的高速Token体验,用越级性价比,服务高端推理市场。
大模型推理提出了新课题,既要运行能力完整的模型,又要在可承受的成本下及时响应。这是当前通用GPU架构和纯SRAM架构的无人区。
探索新大陆,就不能依靠单向度增加计算单元、存储密度、通信带宽的老地图,必须重新思考算什么、在哪里算、权重怎么存、数据怎么传的系统级问题。
依托中国领先的存储战略纵深,结合我们在AI芯片产品定义与产业落地上的积累,MemSilicon正同步推进RRAM产品化和下一代LPU研发,加速存算协同落地。 ”
MemSilicon团队源自中国科学院刘明院士团队,在材料、器件、工艺、芯片设计等底层技术上,拥有二十多年的深耕积累。从材料与器件物理出发,团队的工作延伸至可靠性、工艺集成、IP和芯片设计,再推进到流片验证与应用;除RRAM外,团队在三维集成、近存计算及混合存算一体架构方面也具备深厚科研积累。
打破冯·诺依曼体系的枷锁、突破存储与数据搬运瓶颈,是MemSilicon不变的初心。 而卢涛带来的系统架构视野、产业生态资源和商业化落地经验,恰好与团队的底层技术积累形成优势互补。二者的叠加,将加速存算协同产品从技术验证走向商业交付。