
从展品走向产品,王兴兴预判人形机器人的下一个十年
在 2026 世界机器人大会主论坛上,宇树科技王兴兴集中展示了企业多款新一代机器人硬件成果,同时直面行业现实困境,围绕具身智能泛化短板、模型与实体对齐难题、物理 AI 自进化等议题输出判断。行业舆论大多聚焦 “具身智能 ChatGPT 时刻或将 2~10 年到来” 这一标志性预判。而完整演讲里,既包含多款样机性能、落地尝试,也清晰点明当下机器人从 “展品” 真正变成规模化 “产品” 面前的重重约束。
【编者梳理:硬件多点突破,但规模化落地仍遇现实门槛】
宇树 2016 年 8 月成立,至今已有 10 年时间,企业早期深耕四足机器人,近年发力人形机器人。2024 年推出 Unitree G1,这款机器人推出以后基本上成为全球标杆性的产品,目前市面上很多机器人产品,都是跟它同一款产品,或者跟它长得非常类似的产品。
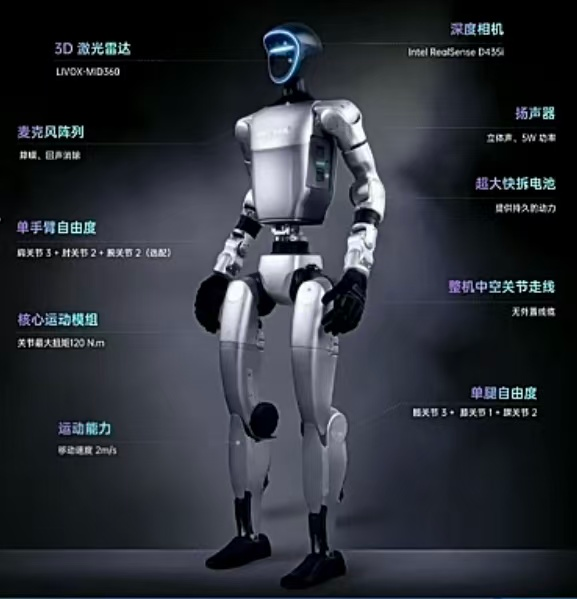 图 2024年推出的Unitree G1 今年年初比较有代表性的是武 BOT,融合了中国经典的传统功夫文化,把几十个中国功夫动作提前采集做 AI 训练,把精彩的动作放到舞台上。这个节目最大的亮点,是结合了当前全世界最顶尖的人形机器人技术以及中国传统的功夫武术文化。这个视频在海外传播得非常好,在海外有几百亿次的播放量,这是非常好的科技和文化交融的例子。
宇树 2 月在北京天坛完成演示,现场约有 49 台机器人进行全自动表演。
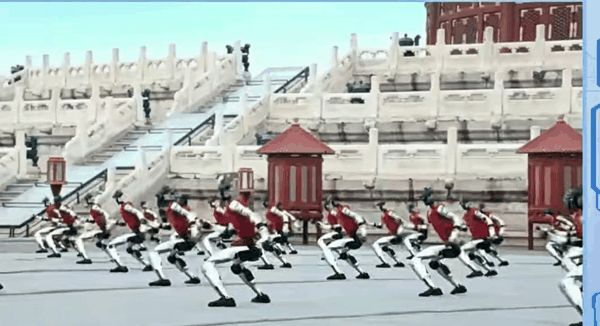 图 在北京天坛的机器人表演 宇树在过去几年一直在推动机器人真正走进生活、去工厂干活,例如2024 年与汽车工厂合作做落地应用,宇树也在自己的工厂部署机器人做简单测试和落地应用。宇树公司里绝大部分 AI 团队都在做机器人在家庭或者在工厂里干活。但为什么现在没有大规模推广呢?主要原因是目前的效率和泛用性不够高。简单来说,虽然目前机器人能做一些简单的装配,但效率跟人比起来还是低一些。另外,每次有一些新任务过来时要重新进行训练。
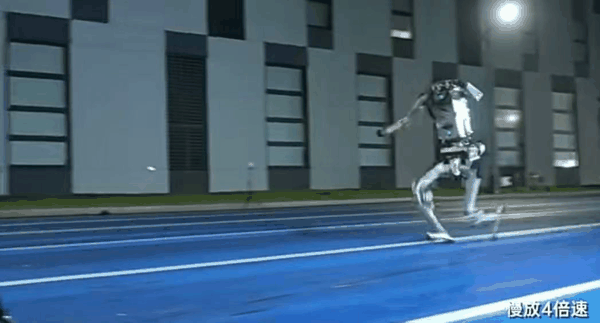
宇树今年 4 月刷新了一个记录,是人形机器人当时奔跑的最快记录,超越了 10 米 / 秒的奔跑速度。这款机器人是在 2023 年第一代人形机器人上改进的。下一步可以在上面装轮子,这样可以更灵活。
编者视角:从表演级集群展示,到工厂内部小范围试点,硬件性能指标不断被刷新,但效率不足、新任务需要重新训练,仍是横亘在样机和商用之间的两道现实障碍。性能参数好看不等于产品可用,这也是整个行业普遍面临的矛盾。
【编者梳理:数据驱动,多款新产品拓展应用边界】
众所周知,目前机器人都是 AI 驱动的,AI 基本是数据驱动的,有多少数据 —— 尤其是高质量的数据 —— 就有多少 AI。宇树在自己采集,或者和第三方公司合作采集更多数据,给大家用,也给宇树自己用。
目前,真正的 AI 机器人训练数据,包含海量真人数据或者互联网数据作为主要的预训练数据,再加上部分真机数据,这是非常刚需的两部分数据。如果从量的角度来说,还是真人的数据会更加重要。实际物理场景数据也非常重要,我们需要把机器人跟物理世界进行匹配。
(图:宇树 GD01 载人机甲) 宇树今年 5 月发布了全球第一款量产级的载人机甲(编者注:GD01,定价 390 万元起),有 3 米多高,载人后重量大概 500 千克左右。关于这款机器人的应用,有点像越野车,并不是给人们在家庭或城市里使用,可以用于户外徒步或复杂环境下的运输。另外它可以变形成四条腿模式,这样稳定性、越障能力更好。
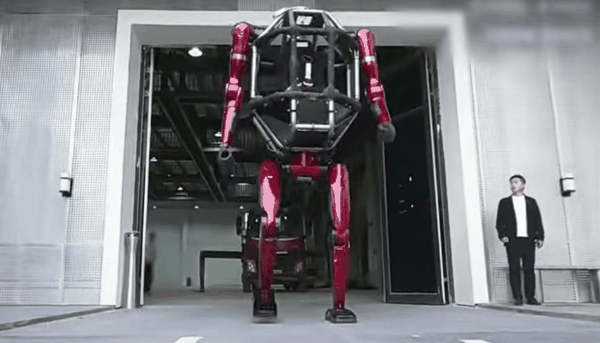 图 宇树GD01载人机甲 前几个月演示了基于多模态端到端自动 AI 动作生成。众所周知,常规的动作演示是提前训练好的,而这些动作是基于实时的语义生成。因为基于实时语义生成,所以会有延迟:每句话说完以后要语义识别,识别后上传云端,云端做 AI 动作生成,动作生成后做动作验证,验证好没有问题再下发给机器人,所以整个过程需要几秒的延迟。因为人们希望未来机器人应用落地时,它的动作是完全实时生成,而不是提前做编程的,因为有语义处理的过程所以有点延迟。
这种自动生成的方式有一个不太好的地方,因为它自动生成时每次动作有点差异性,你跟它说同一句话,它可能今天和明天做的动作有略微差异。
宇树也在推动机器人在会议室里真正干活。宇树采集和训练了一个会议室,如果把它任意打乱后都可以恢复到干净整洁的状态。因为完全是端到端实现的,所以运动效率相对慢一些。而且是多任务的 —— 在这个场景里大概布置了 7 到 8 个不同的任务,而且用一个模型切换不同任务可以完全实现,并且是抗干扰的。
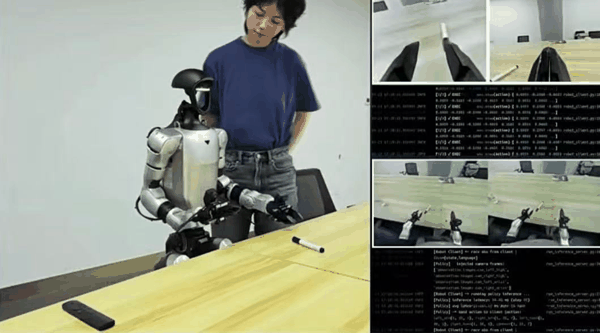 图 宇树在训练机器人在会议室干活 正因为是 AI 实时生成和识别,所以可以看到它动作没有那么流畅。最主要是如果有干扰也可以实现。宇树最近一直在开发这个功能,认为在会议室整理有实用价值,并且难度不是特别大。
宇树在语义自动生成基础上重新做了一个演示。之前的动作生成是不带交互、不带干活能力的,只是动作。新的演示是在语音驱动情况下可以干活,它本身搭载了多模态模型。也是可以抗干扰的,并不是固定动作。
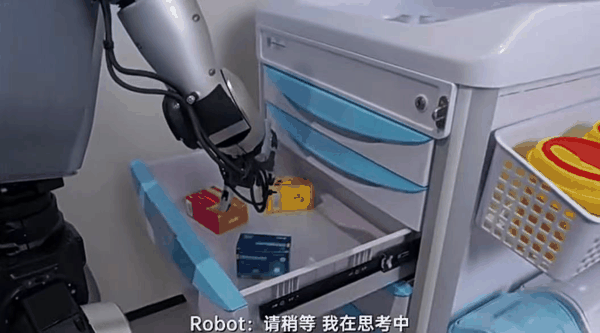 图 在语义自动生成基础上的新演示,有交互与干活能力 宇树前段时间发布了最新一代轮足 As2‑W 机器人,属于轻量化产品,自重只有 20 千克,但它的负载能力和续航非常强劲,防雨水,室内和室外都可以使用。之所以做成轻量级,因为在日常生活或者一些工业场景中使用都会非常方便。而且把人形机器人的技术重新放到四足机器人上,让四足机器人的灵活性有所提升,并且它的负载能力非常强劲,希望这款机器人真正落地应用到户外徒步场景。
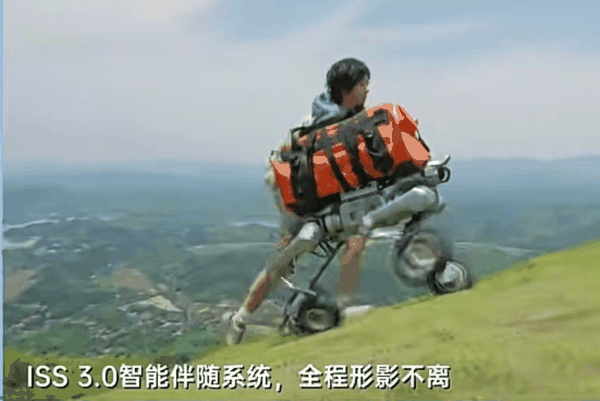 图 宇树As2‑W轮足机器人 宇树前段时间还升级了 2025 年小的 As2 机器人的灵活性,这款机器人目前性价比非常高,在京东、淘宝上有预售或零售。
前段时间还预览了一款新机器人,其开发时间较短,到 2026 年 8 月只花了 3 个多月的时间,它的速度达到 12.65 米 / 秒,已经超越世界历史上以来最快的人类奔跑速度,它的跳高能力已经超越了人类历史上最高的跳跃高度。
 编者视角: 从巨型载人装备、高速人形,再到轻量化轮足、会议室多任务实操演示,宇树在同时探索多条产品路线。实时语义生成动作已经跑通,但云端链路带来延迟、动作输出存在随机性,距离稳定可靠的商用还有优化空间。
【编者梳理:具身智能的核心卡点:泛化不足,模型与物理世界存在偏差】
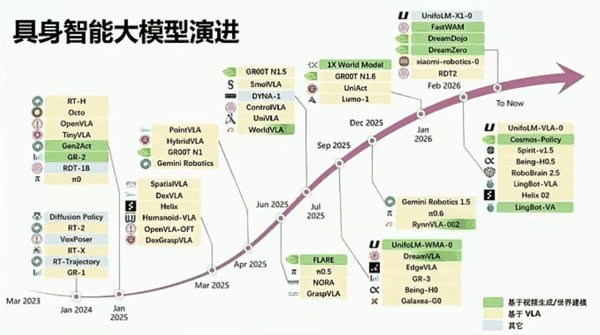
回顾近几年具身智能 AI 模型的发展(下图),最主要的流派主要是 VLA 模型和世界模型。今年大家听到的主要是世界模型这个方向。宇树对 AI 模型的投入一直非常大,这是宇树目前资金和人力投入最大的方向。宇树在 2024 年初开始做基于视频生成的世界模型方向,但到 2024 年底时做的效果不是特别理想,中间稍微搁置了一段时间,但在 2025 年又大力发展了基于视频生成的世界模型的方向。
 最典型的一个问题是: 真正通用的机器人,无论是人形机器人或者半人形机器人,什么时候真正走进生活、走进家庭?目前最大的瓶颈是具身智能的泛化能力不太够。目前很多 AI 模型,在全世界范围内,在固定场景做足够的采集、训练后,成功率可以做到接近 100%,但是如果操作的物品或者是环境稍微变换一下,它的成功率下降是非常严重的一件事情。
希望未来快的话 2 到 3 年,慢的话 5 或 10 年,如果能看到把一台机器人带到任意陌生环境、带到家庭,基本可以实现 80% 左右的任务,就差不多已经实现了具身智能的 ChatGPT 时刻,这就是未来产业的临界爆发点。
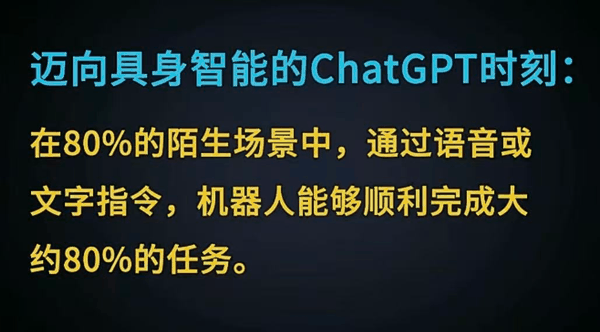 目前要达到这个时刻的最大瓶颈是什么?是目前的 AI 模型输入和输出跟机器人对齐程度不够。目前机器人的模型,如果你吩咐让它移动,或者把什么东西装配在一起,或者把一个物体搬到哪儿,整个趋势是没有问题的,大差不差能执行你的任务,但是最后几厘米或者最后几毫米的成功率或者偏差,没办法很好地跟真实世界匹配。例如我去拿这个东西的时候,我看到已经快要拿住了,最后一点点触觉或者误差没办法很好地修正它,导致成功率暴跌得很严重。这是目前全世界具身智能最大的瓶颈,就是 AI 模型输入和输出跟真实世界有偏差。
为什么机器人上会有这个问题,而一般的语言模型或者多模态模型上没有这个问题呢?因为语言模型完全是数字编码的,一个文字输入后,它的输出是严格限制在向量空间里,所以基本不会有大的偏差。简单来说没有损失,它输入、输出,再把它倒回来输入、输出,没有任何损失。但是对于机器人来说,它每输入输出一次,都会产生偏差和损失,导致目前全世界的模型,真正的泛化能力和成功率稍微差一些。这是未来几年内必然能够解决、只是需要一些时间的问题。
编者视角:这也是整场演讲最核心的判断。大语言模型运行于纯数字空间,不存在物理损耗;但机器人要对接真实物理世界,每一轮执行都会引入误差累积。哪怕仿真效果再好,落到实体硬件上毫米‑厘米级的偏差,就会直接造成任务失败。这不是某一家企业的难题,是全球具身智能共同的底层矛盾。
【编者梳理:探索物理 AI 自进化,试图加快机器人迭代效率】
宇树正在预研的事情:过去很多年,人们用 AI 做编程或开发,但对于 AI 在机器人领域的开发和使用还是相对比较欠缺的。宇树最近一段时间在推出的一件事,是直接让物理 AI 机器人模型自进化:让使用最前沿的顶尖 AI 大模型来驱动,我们自己定一些规则、经验、约束和工具,让它自己去网上搜索最新的论文、最好的研究成果、最好的各种开源方案,让它自己编程生成自己的机器人控制代码,控制代码生成后可以在仿真环境里运行,或者去调用一些大模型状态去控制实物机器人。
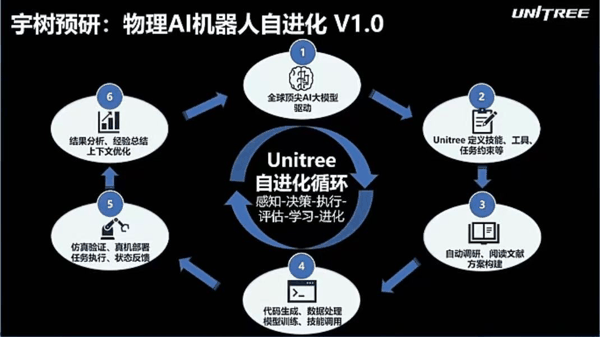 如果我们在实物机器人做部署测试,进行评价和打分,评价和打分一部分是机器人AI模型自己实现的,也可以人肉去参与评价和打分,人的经验非常重要,人非常容易判断出这是好的和坏的,这是非常重要的。这套逻辑一旦运行起来,整个机器人开发效率会高很多,而且迭代速度也会非常快,一旦流程运行一段时间后,可以真正实现机器人自我进化能力的提升。
有一个简单的示例,下图的左下角是 Copilot 的智能体,机器人可以编程 Copilot 代码。目前很多简单的深度强化学习算法其实让很多 Copilot 程序自动编程的效果不错了,把这些编程效果放到仿真环境里去验证,训练后再放到实物机器人上做测试,测试好我们做 AI 模型包括人肉打分评价确定这个效果怎么样,再反馈给编程智能体,形成一个正向循环。
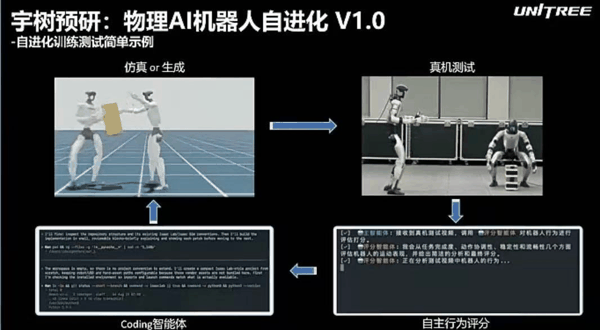 这里是简单示例,真正使用时会比这更加复杂。这是当下以及未来几年全球非常值得做的一件事情。
为什么要这么做呢?有几个简单的原因。 第一,随着每月、每年基础模型能力的提升,自进化训练本身能力就会进一步提升,它是非常良性的,某种意义上可以达到跟随全球 AI 技术进步的。 第二,可以使用多源的数据。人肉地使用数据效率是非常低的,使用自循环可以把各种数据、训练数据包括真实世界、包括人的数据都使用起来,这样使用效率会更高一些,而且可以有更多的真机部署。随着真机部署越来越多,有更多测试数据和评价指标在里面,这样整个数据利用率和增长率是可以保证的,能达到数据的规模化。我们每天每月可以累加技能,不是今天开发了一个技能、明天把这个技能浪费掉了,这是非常重要的一件事情,让真正使用 AI,把机器人开发效率和机器人进化效率大幅提升,未来是非常值得做的一件事情。这可以开启物理 AI 自进化新的纪元,这个方向是未来很多人都会推动的。
过去十年,宇树最早是 2017 年和 2018 年第一次参加世界机器人大会,感受也是非常深刻。未来十年,在当下新的时期,尤其是 AI 大爆发、全球关注度非常高的时间,整个机器人进化速度大幅提升,未来发展速度比我预估的还会更快一点,我觉得是全新的起点、全新的开始。
编者小结
综合整场演讲可以看出,宇树一边持续刷新硬件性能指标,拓展载人、轮足、高速人形等多元产品形态,一边也清醒地直面行业共性痛点。
样机已经可以完成不少酷炫的演示,但泛化能力不足、模型输出与物理实体之间毫米‑厘米级偏差,是阻碍机器人从展品走向规模化产品的核心卡点。
王兴兴提出的物理 AI 自进化构想,希望依靠大模型自主检索、写控制代码、仿真‑真机测试、人机联合打分形成闭环,以此抬升机器人迭代效率。但这套模式同样绕不开真机部署成本、高质量物理数据供给、评价体系构建等现实挑战。
而被广泛传播的 “具身智能 ChatGPT 时刻”,并不是一个确定到来的时间点,其成立的前提恰恰是解决模型与真实物理世界对齐的难题,这也是整个具身机器人行业未来数年共同攻坚的方向。
(本文述评素材来源:2026 世界机器人大会 8 月 20 日主论坛王兴兴现场演讲)