
该如何评测大模型的探索能力?复旦、混元发布新基准ExplorationBench
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
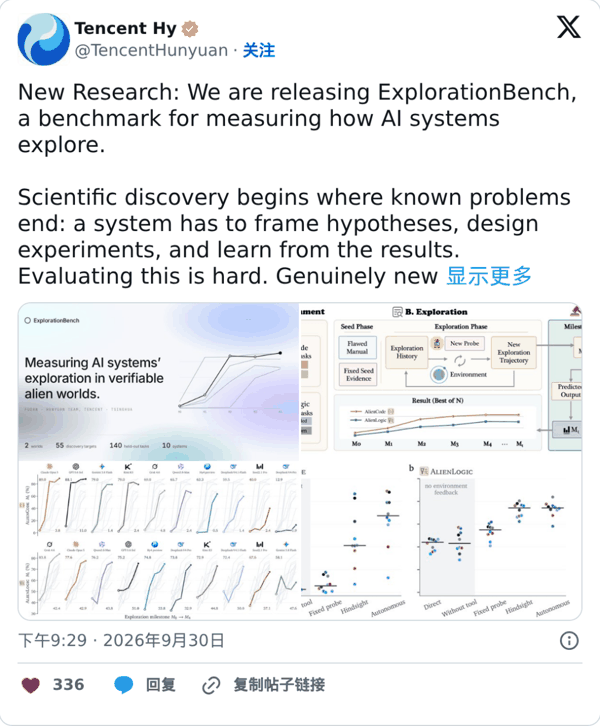 这项工作由此前推出 CL-bench 的复旦大学与腾讯混元团队,联合清华大学共同完成。腾讯混元在推文中这样概括它和 CL-bench 的关系:「CL-bench 问的是模型能否从上下文中学习,ExplorationBench 问的是模型能否自己发现规则。」
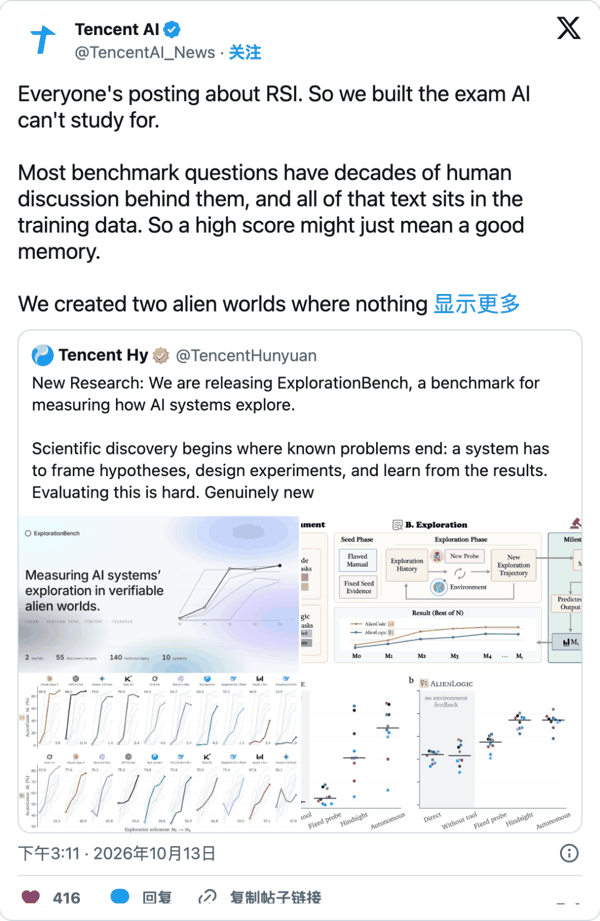
腾讯 AI 官方账号(@TencentAI_News)在推介中则把 ExplorationBench 称为一场「AI 无法提前备考的测试」(the exam AI can't study for):「大多数基准测试的问题背后都有几十年的公开讨论,所有这些文本都已在训练数据里,因此高分可能只是意味着好记性。我们造了两个模型过往所学完全失效的异星世界……榜单上的每一个分数,测量的都是真正的发现能力。」
 过去几年,大模型的成绩单越来越漂亮:奥数难题、复杂编程、专业资格考试,前沿模型几乎都能拿下。但这些成绩单测的,大多是模型已经知道什么。换一个问法,会更接近真实世界:如果把模型放进一个它完全没见过的环境,规则陌生,手里只有一份写错了的说明书,它能不能像人一样边试边学,自己把规律摸清楚?
为此,研究团队搭了两个规则被悄悄改过的「异星世界」:编程语言 AlienCode 和逻辑证明系统 AlienLogic。在 AlienCode 里,SHATTER 做的是乘法,EMIT(100) 打印出 127,整门语言里还没有加法。Claude Opus 5、GPT-5.6 Sol、Gemini 3.8 Flash、Grok 4.6、Kimi K3、Qwen3.8-Max、Hy4 preview 等 10 个前沿 AI 系统被放进去,只能靠自己写程序、做证明、看反馈,一点点摸索规则。
结果相当有意思。读完示例时,AlienCode 上没有一条轨迹超过 15.7%;四轮探索后,最好的轨迹达到 89.0%;可如果只让模型多想、不给环境反馈,成绩最高只有 11.0%。更反直觉的是,在 AlienCode 里,GPT-5.6 Sol 靠自主探索拿到 88.1%,探索前直接把完整规则告诉它,反而只有 69.5%。
 论文题目:ExplorationBench: Measuring AI Systems' Exploration in Verifiable Alien Worlds
论文链接:https://arxiv.org/abs/2609.30199
项目主页:https://explorationbench.com
代码仓库:https://github.com/Tencent-Hunyuan/ExplorationBench
博客:https://explorationbench.com/blog/
下面结合研究团队发布的技术博客,看看 ExplorationBench 是如何评测「探索」的,以及十个前沿 AI 系统在其中的表现。
谈到探索,到底在评测什么?
过往的基准测试大多在测量模型的「能力存量」;但一个更重要的问题是,当大模型置身于完全未知的陌生规则中,它能否通过与环境的交互与探索获得新的能力?
从实践中学习是人类面对现实生活中复杂任务的一种有效方法论。 当一名工程师排查到第十个 Bug 时,对系统架构的理解必然远深于修第一个 Bug 的时候;一名科学研究者也要经历检索文献、提出假设、动手做实验、迭代假设的过程,才有可能攻克一个科学难题。前者靠的是经验的积累,后者靠的是对未知的探索。一个长期可靠的智能体同样需要这种能力,它必须把已经做过的事和得到的反馈,变成下一次的能力。
除了关注模型此刻知道什么,还有一个更本质的问题: 在不断和环境交互的过程中,大模型在冻结参数的情况下能不能自己变得更聪明?
研究团队早期围绕静态评测做了大量研究,越来越意识到静态评测的本质就是测量模型已有的 能力存量 ,这往往是模型权重的显化;而一个模型能不能在真实世界里长期可靠地工作,取决于它能不能在测试时获得更强的能力,也就是 能力增量 。
在过去两年里,团队把目光转向能力增量,先后推出了 EvaLearn、CL-bench 两个当时颇为前卫的 benchmark。现在,团队又在此基础上推出了 ExplorationBench。
从 experience 到 context
先简单做个回顾。
EvaLearn 是团队发表在 NeurIPS 2025 上的一篇工作,它想打破的是评测中的独立同分布(i.i.d.)假设。研究者将 648 道题组织成 182 条连续的任务序列,允许模型参考先前的解题历史与环境反馈。评测发现了一个反直觉的现象:静态跑分拔尖的模型,在线学习能力未必同步领先;部分模型能够随序列推进逐步提升,另一些模型却 在历史噪音与错误经验的干扰下越做越差,表现出明显的负向迁移 。
可见,这种序列学习能力值得单独拿出来评测。但这一工作仍留下了一个谜团: 模型究竟是真正理解了规律,还是仅仅记住了题型套路?
要回答这个问题,就得把模型该学的知识明确地摆出来。在年初发布的 CL-bench 中,研究团队把需要学习的内容直接放进模型的上下文,其中包括虚构的法律法规体系、复杂的专业操作规范,乃至隐藏在实验观测数据中的客观规律。 完全剥离上下文时 ,顶尖模型的解题率跌破 1% ;而即使提供了详尽且自包含的完整上下文,十款前沿大模型的平均解题率也仅有 17.2%,最强模型也仅仅达到 23.7%。
CL-bench 的评测结果其实打破了大家对 Context Engineering 的乐观预期。很多人花费大量精力打磨检索、重排与文本压缩,下意识地认定只要把信息塞进窗口,模型就理所应当能「学会」。但研究团队发现,信息进了上下文窗口,和模型学会并用上这些知识,完全是两码事。
CL-bench 上下文里的所有规律与知识,都是人类专家预先整理好的正确、完备的现成材料。然而,真实世界也是这样的吗? 不妨把视角转向「科学研究」 :面对未知问题时,科学工作者通常没有一本写满标准答案的手册,也不知道应该收集哪些数据、观测哪些指标, 只能不断提出假设、通过实验试错,再从现象中总结规律 。那如果模型面对的也是这样的情况呢?
从 context learner 到 explorer
ExplorationBench 就是为这种情况设计的。模型拿到的只有一个能交互的沙盒和内置的特殊系统,没有现成知识可以直接供它使用。它需要自己提出假设、设计实验、读执行反馈,再从中推出特殊系统的规则并加以验证。
评测「探索能力」会遇到两个让人纠结的问题。其一,假如选定成熟学科作为探索目标,题目再难,模型也能靠预训练语料直接背出答案,数据污染防不胜防;其二,若是选择真实科学前沿的未知命题来进行探索,又无法及时判断对错,因为检验一项全新的物理或生物学假设往往要花费高昂的实验成本,甚至要等上好几年的同行检验。
为此, 研究团队构造了两套规则反常、却能完全形式化判定的「异星世界」(Alien Worlds),也就是上文提到的特殊系统。大模型从未见过里面的规则,评测程序却能精确执行这些规则,并准确判断每个答案的对错 。
在 AlienCode 中,语法看似常规,底层却有 31 处规则被悄悄改掉了,论文称之为「发现目标」。SHATTER 字面像是破坏操作,实际执行的却是乘法;EMIT(100) 打印出 127,因为整数字面量会被悄悄地与 27 做一次异或运算;手册说 PLUCK 从 0 开始计位置,它实际却从 1 开始。语言里还故意抹去了加法原语,模型若想做加法,必须用其他反直觉的操作组合出来。
在 AlienLogic 中,研究团队修改了 24 条自然演绎推理规则。某些传统逻辑中被视为常理的推导步骤在此失效,原本不合规的变换反而成立;在 70 道留出题中,还嵌入了 23 道指定为不可证的定理,模型唯有识别出死胡同并主动拒绝证明才能得分。
两个世界一共有 55 个发现目标和 140 道留出题。AlienCode 的程序由解释器执行判分,AlienLogic 的证明由证明检查器和有界判定器检查,全程无需 LLM 作为裁判。