
刚刚,李飞飞掀桌!全球首个多模态世界模型发布,几张照片省掉几百个机位
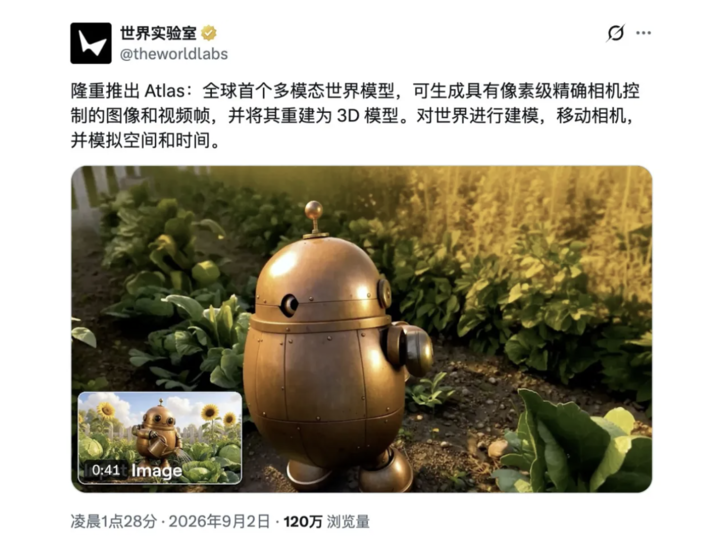
前脚友商还在为你追我赶生成几秒钟的「电子榨菜」视频卷到头秃;后脚李飞飞创办的 World Labs 微微一笑,把桌子掀了——
就在刚刚,全球首个多模态世界模型 Atlas 正式登场!
▲官方博客🔗 https://www.worldlabs.ai/blog/atlas
按照官方定义,Atlas 是一款面向空间智能的 omni world model,从零开始完成预训练,可以原生处理文本、图像、视频、相机位姿与 3D 深度信息,并在同一套模型中完成世界生成、空间重建和时空模拟。
先来看最直观的炸场操作:
Camera Controlled Generation(相机控制生成)。
以前大家玩视频生成模型,多少有点玄学抽奖。我们在 Prompt 框里卑微敲下:「镜头缓慢向左拉升、绕着人物微仰角旋转」,回车之后全凭老天保佑。
对比之下,Atlas 的做法是:直接把「相机位姿参数」当作底层原生输入。
你要什么角度、什么轨迹、走多快?
直接给坐标!
只要丢进去 1 到 6 张普通照片,定好运镜轨迹,Atlas 就能生成最长达 1 分钟、1440p 分辨率 的大片。
画面不崩,空间几何丝滑一致,堪称外挂级运镜。
更夸张的是它的空间「脑补力」。
输入一张只拍到机器人正面的照片?Atlas 能把人家背影完完整整脑补出来;
给一张泳池边角照?它靠着脑子里的「世界常识」,默默帮你把隔壁没拍到的草坪和远山给修好了。
从官方放出的 Demo 来看,Atlas 在镜头运动和空间一致性上确实比普通视频生成模型更进一大步。
不过,镜头一旦进入原图没有拍到的区域,Atlas 实际上仍然需要依赖模型先验去猜,视角跨度越大、生成路径越长,局部几何漂移、物体形状变化和纹理闪烁也越容易暴露出来。
换句话说,它生成的更像是一个视觉上合理的三维世界,未必就是原来那个世界的精确数字复刻。
而种种操作的背后,也绕不开一个名为 Spatial Context(空间上下文)的行业术语。
大语言模型看上文接下文,Atlas 则是给每张图片绑死三维坐标和深度,在脑子里搭出一个带轴网的房间。
说得更直白一点,Atlas 很多能力的底层,其实都绕不开多视角合成。
它会把来自不同角度、不同机位的图片和视频,一起塞进同一个三维空间里,先判断它们彼此之间的相对位置,再补足没拍到的区域,继续生成新的视角。
单张图输入时,它更多依赖模型先验去「脑补」世界;输入视角一旦变多,它就更像是在做一次带空间约束的多视角融合,把零散画面慢慢拼成一个连续、可漫游的三维场景。
甚至你随便抓两张八竿子打不着的照片往空间里一扔,Atlas 都能强行给你脑补出走廊、大门和房间,把俩场景无缝焊在一起。
导演系同学看到这里,战术沉默,缓缓打出一个问号:合着以后运镜不用实拍,直接在电脑里「云开机」就完事了?
除此之外,Atlas 还有第二张王牌:Spatial Reconstruction(空间重建)。
传统的 3D 高斯泼溅(3D GS)或者点云扫描,得扛着专业设备围着目标转几十圈,拍几百上千张照片,费钱又费腿。
但 Atlas 再次露出神秘的微笑:一边去,哪来这么多的规矩。
官方直接甩出了一个斯坦福大学 Main Quad 案例,只需把 2 到 25 张游客视角的地面平拍照片塞进去,就能轻松还原草坪、拱廊以及纪念教堂外墙的全部细节。
主题:照片