
GPT-6缓存输入最高省九成,你的账单为啥没打一折?
新智元
你有没有碰到过这种场景:
把一堆资料交给AI,让它写报告、核对出处,再做成PPT。
第一版出来后,你觉得结构不对,在对话框里打了几个字:「把结论提到最前面」;
第二版出来后,你又来了一个想法,补上一句:「再补一页竞品对比」。
在你的界面上,你不过是多打了两句话。
但在后台,你每追加一次要求,应用都可能再次把原始材料、任务说明和聊天历史交给模型。如果这些旧内容没有命中缓存,就需要重新处理。
你只改了两句话,后台却可能又算了一遍早已读过的材料。每一次重新阅读,都在烧掉你的计算费用与等待时间。
这笔藏在后台的重复开支,正是OpenAI最近一次升级瞄准的问题。
9月22日,OpenAI公布了GPT-6提示缓存(Prompt Caching)的重磅升级,提高默认缓存命中率,并提供更细的监测、诊断和控制手段。
 能省多少?
按官方公布的费率计算,同一段材料连续使用10次,如果首次写入后,后续9次全部命中缓存,仅这段重复输入的成本,理论上就能省下78.5%。
其中,命中缓存的输入,读取价格只有普通输入的十分之一。
当AI开始替我们承担耗时几小时的复杂工作时,挑选工具就多了一道考量:除了「能不能做完」,还要看「等多久」和「花多少钱」。
但缓存输入打一折,我们的总账单也能跟着打一折吗?
缓存到底存了什么?
把「算过的草稿」留下来
要搞懂它怎么省钱,先得明白AI是怎么「阅读」的。
当模型读取大段文字时,它并不会像人类一样纯粹靠肉眼看,而是会在内部计算出一组复杂的中间状态,业界称为KV状态。
在生成接下来的回答时,模型需要时刻回看这些状态,以保持前后逻辑一致。
所谓提示缓存,保存的正是这部分已经计算好的中间结果。
你可以把它形象地理解为:上一次解题时留下的「计算草稿」。
下一轮对话时,只要题目开头没变,AI就不需要重新在草稿纸上算一遍,直接拿过草稿继续往下写就行。
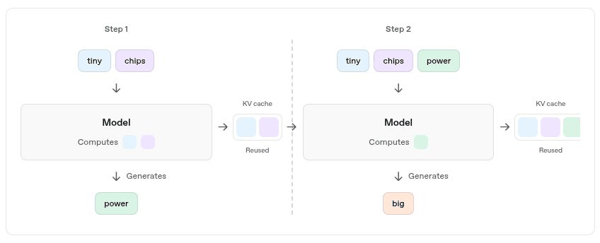 官方文档展示KV状态复用,已算内容可供后续步骤使用。 这里有两个非常关键的前提:
第一,缓存不等于记忆。
它不是给AI装上了永久记忆库,也不是直接把上一次的答案复制粘贴给你。
面对你的新提问,AI依然要认真思考并生成新回答,它只是省去了「重读旧资料」的重复劳动。
第二,复用必须满足精确匹配。
两次请求的前半部分必须一模一样,这段完全相同的内容,就被称为「共享前缀」。
这个前缀不仅包括你打出的聊天文字,还涵盖了系统的隐性指令、工具定义,以及图片、文档和音频等上下文。
对于GPT-5.6及之后的模型,能触发缓存的共享前缀至少需要达到1024个可见输入token。
而且缓存是有保鲜期的:最近一次写入或使用后,它会在服务器上保留至少30分钟。
只要在这期间再次调用,保鲜期就会重新刷新,不用再交一次写入费。
但待在同一个聊天窗口里,并不意味着100%能命中缓存。
如果请求被分配到了不同的服务器机器,或者跨越了不同区域,缓存依然可能失效。
读取打一折
为什么总账单不能直接除以十?
OpenAI宣称命中缓存的输入最高打一折,那为什么整体账单不能照这个比例削减?
因为天下没有免费的午餐,要把资料第一次写入缓存,本身需要先付一笔「开房费」。
根据最新的开发文档,对于GPT-5.6及之后的模型,首次将材料写入缓存的价格是普通输入的1.25倍;而后续如果成功命中缓存,读取价格则是普通输入的十分之一。
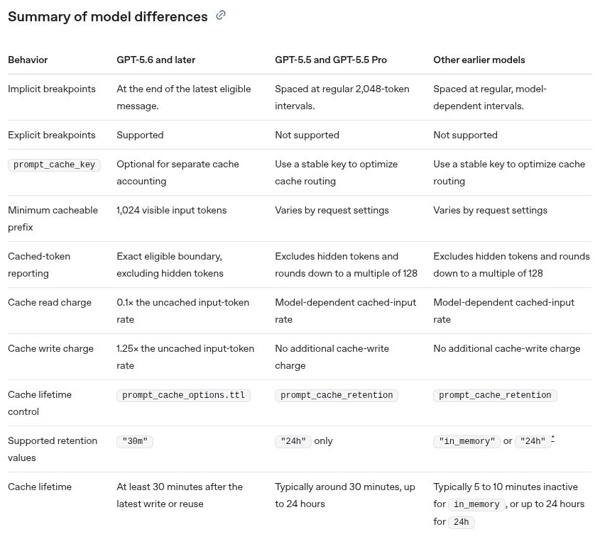 官方费率表:GPT-5.6及之后模型缓存读取0.1倍、写入1.25倍。
我们来算一笔最直观的账:
设你有一段庞大的资料,按普通输入处理一次算1份钱。如果连续使用10次,原本总共需要支付10份钱。
如果采用缓存机制,第一次写入,支付1.25份;后续9次全部命中缓存,每次支付0.1份,9次就是0.9份。
加在一起:1.25+0.9=2.15份。
相比原来的10份,费用直接从10份降到了2.15份,整整省下了78.5%。
这就是文章开头那个高达78.5%降幅的神奇数字的由来。
但请注意,这个高达78.5%的降幅,仅仅覆盖了那段「被重复使用的旧材料」。
在实际使用中,你的新提问、AI生成的输出内容,以及其他额外的计算,依然要按正常价格计费。
更现实的情况是:如果一段材料高价写入缓存后,你只用了一次就再也没理过它,你反而要承担更高的首次写入成本。
所以,优惠看单价,真正能不能省钱,全看复用率高不高。
为什么只改了一点
优惠就突然「断了」?
前面提到,缓存靠的是「精确匹配」。
AI是非常死板的,它无法理解「这两句话意思差不多」,只要开头有一丁点变化,缓存就会瞬间失效。
比如,有些应用为了记录时间,每次都会把当前的精准时间写在提示词的最最开头。这就导致后面的参考资料虽然一字未改,但因为开头的变化,整个前缀都无法匹配旧缓存了。
为了不让优惠断掉,开发者们总结出一条黄金法则:固定不变的内容永远往前放,经常变化的内容统一追加在后面。
在这次升级中,OpenAI还推出了几个非常实用的控制工具和方法:
一个是显式断点。
它就像是在文章里插入书签,明确告诉AI:「这段开头到这里为止是固定的,请帮我留待复用。」
它标记的是缓存的边界,而不是让AI暂停思考。