
给ChatGPT打水印的人,是「统计学诺奖」得主苏炜杰
编辑|Panda
今天,OpenAI 宣布正式启用 文 本水 印 。从当天起,全球 API 客户可以为部分模型自行开启水印,默认仍保持关闭。未来几周内,欧盟地区符合条件的 ChatGPT 与 Codex 文本输出将被加上肉眼不可见的水印,覆盖所有付费档位。检测器则只向通过审核的研究者和专业机构开放申请,暂不面向公众。
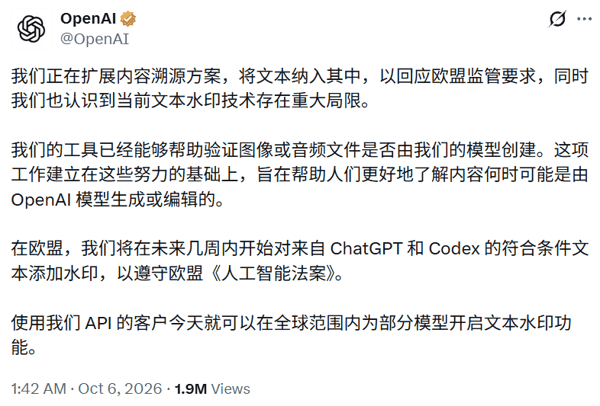 这次上线的直接推手是欧盟。《人工智能法》(EU AI Act)第 50 条自 2026 年 8 月 2 日起适用,要求生成式 AI 提供方以机器可读的方式标记输出内容。欧盟委员会 6 月发布的《AI 生成内容透明度行为准则》进一步把「不可感知的水印」列为基本要求,并指出自由文本无法像图片文件那样携带元数据,水印几乎是唯一可行的标记手段。
文本水印对 OpenAI 来说并不是新课题。早在 2023 年,时任 OpenAI 客座研究员的计算机科学家 Scott Aaronson 就公开介绍过一套基于 Gumbel-max 技巧的水印方案。此后数年,外界多次传出 OpenAI 内部早已具备文本水印能力、却迟迟没有推出的消息。
拖延的原因之一,是文本水印在工程上的两难。它真正的难题不在于「能不能打上」,而在于能否精确计量: 为了换取 可检测的信号 ,模型究竟让出了多少生成自由。
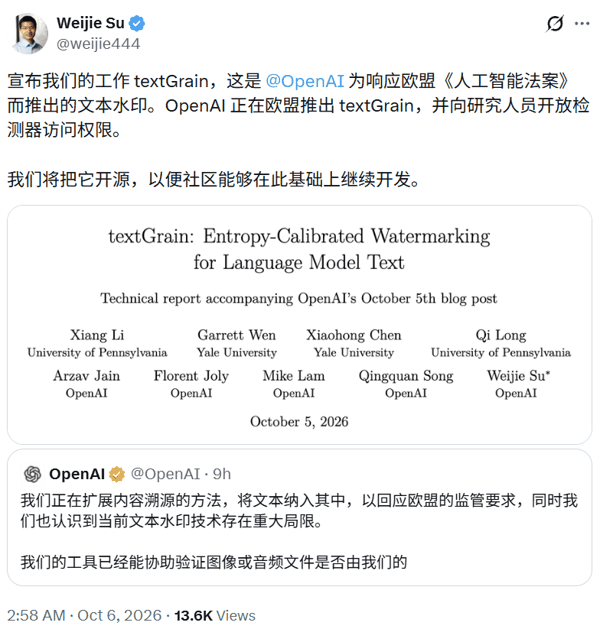
一同发布的,还有一份题为《 textGrain: Entropy-Calibrated Watermarking for Language Model Text 》的技术报告,详细交代了这套水印如何在两难之间取舍。
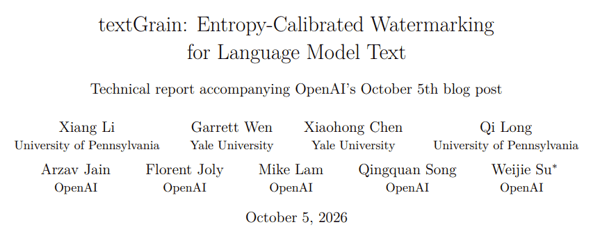 报告标题:textGrain: Entropy-Calibrated Watermarking for Language Model Text
报告地址:https://cdn.openai.com/pdf/e9508624-d767-41b6-a26d-e34ca798ada6/textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf
报告的通讯作者一栏,写着一个中国统计学界熟悉的名字:今年的 考普斯会长奖(COPSS Presidents' Award) 得主 苏炜杰 。
 从研究 OpenAI 的水印,到设计 OpenAI 的水印
苏炜杰(Weijie Su)与 OpenAI 水印的缘分,比他入职 OpenAI 早得多。
大语言模型水印是他近几年的核心研究方向之一。他与合作者 2025 年发表在《统计年鉴》(The Annals of Statistics)上的论文,为水印检测建立了一套统计框架,研究对象正是 OpenAI 此前的 Gumbel-max 方案,并为其推导出了优于已有做法的检测规则。
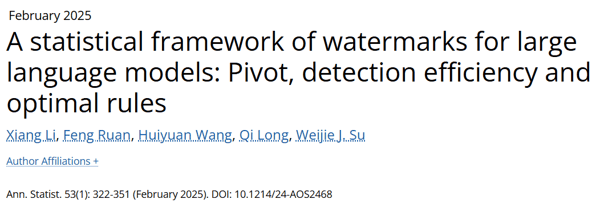 此后,这条研究线又延伸到人类编辑下的稳健检测、拟合优度检验、混合文本中水印比例的估计等问题。换句话说,在加入 OpenAI 之前,他已经花了几年时间从外部研究「OpenAI 的水印该怎么测才最准」。
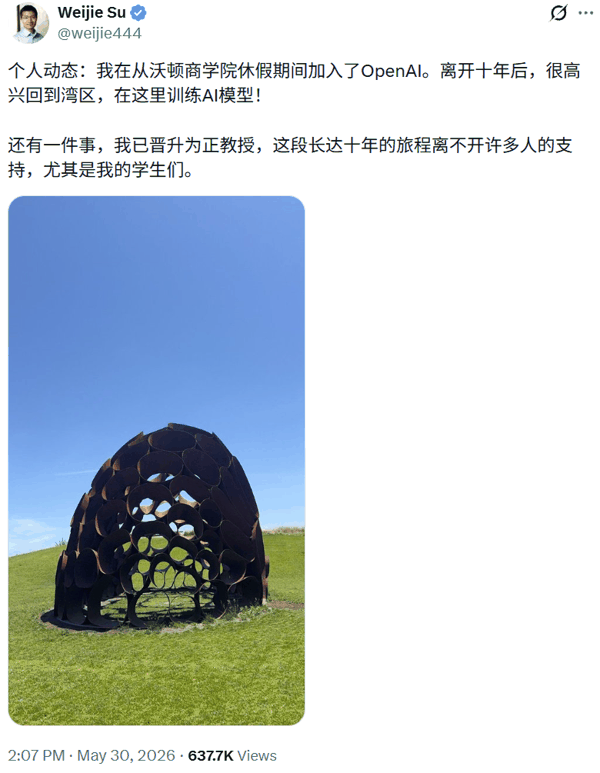
今年 5 月底,苏炜杰在 𝕏 上宣布以学术休假身份加入 OpenAI,参与模型训练,同时晋升为宾夕法尼亚大学沃顿商学院统计与数据科学系正教授。
 8 月 5 日,他在波士顿举行的联合统计会议上领取了 2026 年考普斯奖 。
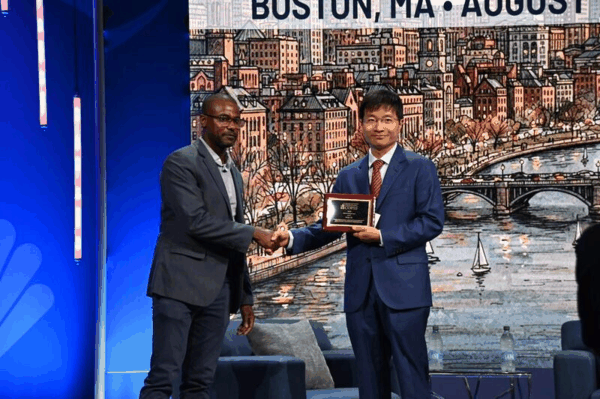 这一奖项由五个主要统计学会于 1976 年设立,每年只授予一位青年统计学家,常被称作统计学界的「诺贝尔奖」。
他是 2012 年以来首位获此奖项的华人统计学家 ,评奖委员会列举的贡献中,第一项就是生成式 AI 的统计基础。
在此之前,他的履历是一条数学精英路线:北京大学数学科学学院 2007 级,2011 年本科毕业,2016 年在斯坦福大学获统计学博士学位,师从 Emmanuel Candès,随后在沃顿任教至今。
textGrain 是一项九人合作的成果,作者团队同样延续了这条学术脉络。除苏炜杰外,作者还包括宾夕法尼亚大学的 Xiang Li、Qi Long,耶鲁大学的 Garrett Wen、Xiaohong Chen,以及 OpenAI 的 Arzav Jain、Florent Joly、Mike Lam 和 Qingquan Song。其中 Xiang Li 是报告第一作者,也是上述《统计年鉴》论文的第一作者,与苏炜杰合作水印研究多年。
 「无偏」不等于「自由」
要理解 textGrain 在解决什么问题,先要看水印是怎么工作的。
LLM 逐词生成文本,每一步都从一个「下一词预测分布」中抽样。水印的做法是用一把密钥和前文生成一串伪随机数,再让抽样过程依赖这串数字。检测时,只要拿着密钥重建同一串数字,就能检验文字与它之间是否存在统计关联。
学术界此前追求的一个重要性质叫「无偏」:在任意固定的前文下,如果把密钥看作随机抽取的,那么对所有密钥取平均后,水印模型的输出分布与原模型完全一致。听上去,这已经意味着水印「不影响」模型。
问题在于,实际部署时密钥是固定的。以 Aaronson 的 Gumbel-max 方案为例,也就是苏炜杰团队此前研究过的那套方案,它在固定前文和固定密钥下,总是选中同一个词。
这就像一位按暗号配菜的厨师:从所有可能的暗号平均来看,各道菜出现的比例与菜单完全吻合;可只要暗号不换,同一桌客人每次点同一道菜,端上来的永远是同一盘。
落到大模型上,就是同一个提示词反复生成,得到的回答一字不差。对于需要多次采样再择优、或者希望得到多个不同方案的应用,这是实打实的损失。
另一个极端同样不可取:如果生成过程与密钥毫无关联,模型的随机性完好无损,但水印信号也就不存在了。
textGrain 要回答的问题是,在这两个极端之间,能否用一个可解释的旋钮来精确控制位置。
把水印写成一道最优传输题
技术报告的第一个关键观察是,任何无偏水印都可以看作生成词与密钥随机数之间的一个「耦合」,也就是一个两侧边缘分布都被固定的联合分布。在这个视角下,耦合偏离「相互独立」的程度可以用 KL 散度衡量,而这个 KL 散度恰好等于两者的互信息,也等于固定密钥之后平均丢失的抽样熵。
这一恒等式把一个抽象的正则项变成了有明确信息论含义的量。研究团队据此引入 「熵预算」β ,取值在 0 到 1 之间,表示允许损失的熵占原始预测分布熵的比例。
β 等于 0 时水印退化为普通抽样;β 越大,密钥对生成的支配越强,信号也越强。可以把它理解成一本账:模型每一步原本有若干「选词自由」,β 规定其中最多拿出多大比例交给密钥。报告也特意强调,这一预算约束的是对密钥取平均后的熵损失,并不保证每个具体密钥、每个位置都恰好损失这么多。