
Agent推理快10倍是怎么做到的?苹果×CMU:把「生成」改成「做选择题」
在智能体的典型工作流程中,模型每执行一个动作之前,都要先生成一段自由形式推理(free-form thinking):分析当前观察、评估已有证据、再决定下一步行动。这一 “思考” 过程是 ReAct 范式的核心环节,但也带来了实打实的推理开销。
来自苹果与卡内基梅隆大学的研究团队近期提出了一种新框架 SSR(Selection-based Structured Reasoning),对这一环节进行了重新设计:与其逐 token 生成推理,不如让模型从一组预定义的推理选项中 "做选择题"。实验结果显示,这一方法在 7 个多模态搜索 benchmark 上将每轮推理延迟降低超过 90%,同时保持了与 free-form thinking 相当的任务成功率。
 论文标题:Selection-Based Structured Reasoning: Toward Efficient Multimodal Search Agents
作者单位:Apple,Carnegie Mellon University
论文地址:https://arxiv.org/abs/2610.01892
项目主页:https://zfy0314.github.io/ssr-webpage/
一、动机:小模型的 "废话文学" 值得吗?
如今,多数搜索 Agent 都遵循类似 ReAct 的交互范式:观察(Observation)→ 推理(Reasoning)→ 动作(Action),如此循环往复,直到任务完成。
以一道多模态搜索题为例:模型看到一张建筑的照片,问题是 "这栋建筑里接下来会举办什么展览"。一个典型的 Agent 会先生成一段 free-form thinking:"这张图片看起来像某个博物馆…… 我需要先判断建筑是什么…… 然后搜索它最近的展览……",随后据此构造搜索 query 并调用工具。
然而,这种 "先想后做" 的模式在小模型上暴露出明显的性价比问题。研究人员观察到,2B、4B 这类端侧小模型有时会生成相当长的推理内容,但这些内容对生成下一步动作和最终决策却未必有帮助。
更关键的是,研究团队通过分析大量搜索轨迹发现:尽管每道题的实体、查询和观察结果千差万别,但决定下一步动作的高层推理逻辑却是反复出现的。比如 “某场 AI 会议在哪里举办” 和 “LEGO 是哪年成立的” 这两道看似无关的题目,背后共享的是同一条推理逻辑:“实体已知但目标信息缺失,用实体名加目标属性去搜索”。
这意味着,搜索 Agent 的推理空间不必覆盖整个自然语言空间。与其每次从头开始生成,不如预定义一组可复用的推理选项,让模型像做选择题一样完成推理。
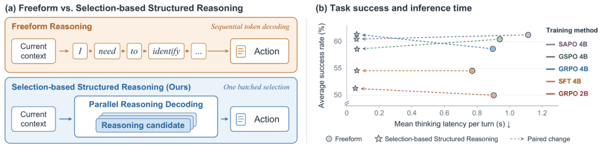 将Reasoning改成做选择题后,推理速度明显提升 二、方法:Selection-Based Structured Reasoning
2.1 推理库与选择式推理
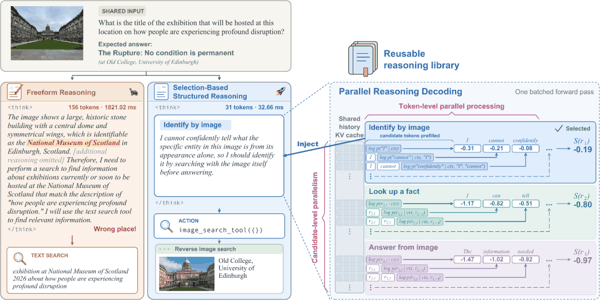
SSR 的核心是一个包含 6 条推理选项的推理库:不确定图中实体时用以图搜图识别;需要具体事实时用文本搜索查询;需要查看细节时裁剪或放大图像局部区域;证据已收集时基于证据作答;图中就有答案时直接读图作答;常识可答时直接回答。
每轮交互时,Agent 不再逐字生成推理,而是从推理库中选择一条作为当前轮的推理,再基于选中的推理去生成具体的动作,比如这次搜索该用什么 query、裁剪哪个框。这一设计将可复用的推理选项与实例相关的执行细节解耦:选项提供 "为什么这么做" 的 rationale,动作生成负责 "具体怎么做"。
2.2 用模型自己打分,不需要额外的分类头
关键问题是:怎么选?研究团队的做法是直接让 LLM 本身充当分类器。对每个推理选项,计算它基于当前 context 的概率平均值;再经过 softmax 得到推理库上的类别分布,采样即完成推理选择。整个选择过程不需要任何额外的任务头,也不需要 SFT warm start,打分与动作生成共享同一套模型参数和 system prompt。这相当于把基座模型自带的语义先验直接用作推理选择器:利用模型的 “理解能力”,根据当前上下文选择最合适的推理选项。
2.3 Parallel Reasoning Decoding:推理的 "并行解码"
这是 SSR 效率优势的直接来源。由于所有推理选项都是预定义的,打分可以完全并行:在 token 层面,通过 teacher forcing 一次性 prefill 整条选项,所有 token 的似然在一个 batched forward pass 中算完;在推理选项层面,所有选项共享同一份上下文 KV cache,同时打分。也就是说,整个推理过程模型不需要自回归生成任何新 token。
论文中有一个直观例子:给一张爱丁堡大学的建筑照片,要求找出 “人们正在经历深刻变革” 主题的展览名称,一个 4B 模型生成了 156 个 token 的冗长思考,耗时 1821.92 毫秒,却将建筑误判为苏格兰国家博物馆,最终导向了错误的搜索方向。而 SSR 仅用 32.66 毫秒,就精准选择了 “通过图像识别实体” 的推理选项,并直接触发了图片搜索行为。
2.4 训练:SFT 与 RL 都可直接接入
SSR 是一个通用的推理接口替代方案,可接入现有 SFT、RL 训练管线。SSR 的一个额外好处是:由于推理被约束在推理库内,SSR 可以直接用 RL 训练,不需要 SFT warm start。而很多现有工作需要先用 SFT 教会模型 "特定的思考方式" 才能上 RL。SSR 不仅省去了 SFT 阶段的数据构造与训练时间,也让模型行为更可预测、更可控。
 三、实验:精度基本持平,推理快 10 倍
研究团队在 Qwen3-VL 2B/4B 模型、H100 + SGLang 推理引擎上,于 MMSearch、HR-MMSearch、FVQA-test、InfoSeek、SimpleVQA、LiveVQA、MAT-Search 共 7 个多模态搜索 benchmark 上进行了评估:
搜索精度持平:4B SSR(GRPO)平均成功率 61.37%,与同规模 SOTA 持平;2B SSR 达 51.26%,堪比零样本 8B 模型。在 GRPO / GSPO / SAPO / SFT 四种训练方法下,SSR 与 free-form thinking 版本的成功率相当。
推理速度大幅提升:每轮推理延迟降低超 90%,每题模型总推理延迟降低 28–54%。与 Chain-of-Draft、Sketch-of-Thought、效率奖励 RL、Probe & Prefill 等 baseline 相比,SSR 成功率最高,p95 推理延迟仅 0.07 秒(baseline 为 0.8–1.9 秒)且更加稳定。
消融实验的几个发现:
语义很重要。若只让模型选择编号(如 "[1]")而非完整文本,平均成功率下降 3.9%,且 7 个 benchmark 全面受损。这说明基于自然语言打分确实在使用模型的语义理解能力做上下文匹配,而非学一个纯索引分类器。
推理库规模有单调收益。选项从 1 条通用选项增加到 6 条,平均成功率从 37.24% 单调提升至 61.37%;其中从 1 条增加到 2 条(区分 "作答" 与 "调用工具")即带来 17.27 个百分点的跃升,证明更多样、更细粒度的推理选项能更好地指导动作生成。
选择是自适应的。同一个 checkpoint 在不同 benchmark 上呈现不同的选择分布:偏简单事实问答的 SimpleVQA 上 "基于图片作答" 占比最高,高分辨率图片为主的 HR-MMSearch 上 "检查图片细节" 占比最高。
与自回归版本的对比。实验中发现,如果用自回归方式训练模型逐字生成推理库中的选项,必须依赖 SFT 先教会其遵守格式;仅靠 prompt 加格式奖励的 RL 无法约束模型不 "乱想",而 SSR 从机制上直接保证了推理结果必须来自预定义推理库。
四、总结:重新定义推理空间
在研究团队看来,这项工作的意义或许不止于 "让 CoT 更短",而是提出了一个更基础的问题:推理的表示方式是否一定要依赖不受限的自然语言生成?
对于开放式数学推理、定理证明或代码设计,free-form thinking 带来的表达能力至关重要;但在多轮搜索与工具使用场景中,Agent 每步面临的往往只是少数几类高层决策:当前信息是否足够、是否需要识别图中实体、是否继续搜索、是否需要放大局部区域。真正高度依赖具体输入的部分,如 search query、tool arguments、crop 坐标与最终答案,仍由模型自由生成;而策略层面的推理,未必需要每次在完整语言空间中重新生成。
因此,SSR 更应被理解为一次推理空间的重新组织:从一个完全开放的语言空间,转化为一个紧凑、可复用、语义明确的策略空间。模型并没有停止思考,只是将一部分靠逐 token 生成的推理,换成了在结构化推理空间中的选择与推断。