
算力荒近在眼前,微软准备用玩家的显卡跑AI
一周前,OpenAI CEO萨姆·奥尔特曼曾在播客节目中吐槽道,“当我们审视全球有限的内存供应链时,会发现资源分配非常糟糕。全球数以亿计的个人电脑中,囤积了海量的内存,但在绝大多数时间里,这些内存的使用率仅仅只有5%左右”。
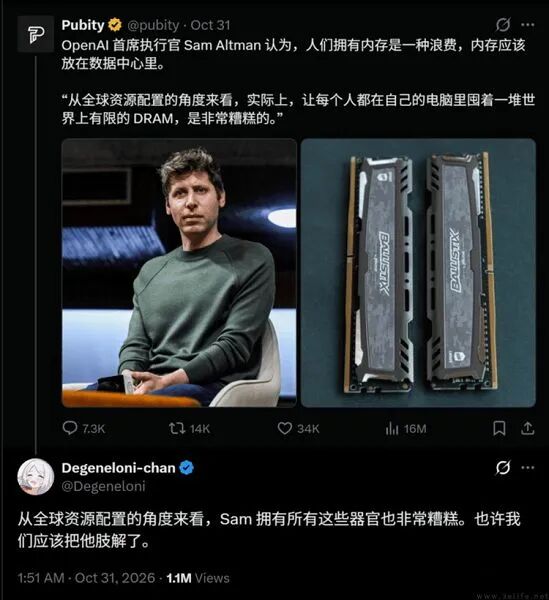
普通PC用户买内存是浪费,OpenAI用才是正途,奥尔特曼这番傲慢的“地图炮”很快就一石激起千层浪。然而,他随口说出的却是硅谷的共识,算力闲置在个人电脑里简直是浪费。
几乎在同一时间,微软的一份新专利浮出水面,核心是“共享计算”,他们准备将用户闲置的算力纳入一张大网。
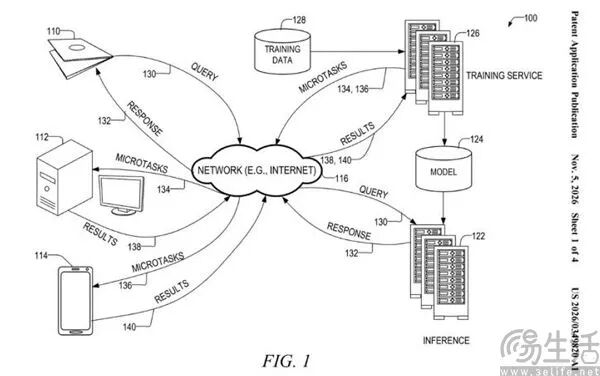
这一专利显示,微软提出建立一个分布式计算网络,将大型AI模型训练任务拆分成大量小型任务,分配给处于空闲状态的游戏电脑、笔记本电脑,甚至是智能手机。愿意向这一网络提供算力的用户,则会获得积分、免费软件、AI模型使用权限,甚至是现金报酬。
事实上,微软这个想法并非空穴来风。如今数据中心的扩张与民生矛盾早已积累到了一定的地步,最终演化成美国各地掀起的反数据中心浪潮,并且AI巨头和数据中心开发商未来大概率要面对更为严厉的监管。所以他们的“算力焦虑”已经不再是杞人忧天,而是成为近在眼前的危机。
过去两年间,AI模型对算力的需求增长速度远超供给,使得这些巨头不得不在美国、欧洲、中东大规模兴建数据中心。现在随着数据中心的建设极有可能会被按下暂停键,就让算力短缺变得更为紧迫。可是相关厂商已经为AI投入了海量资金,没人敢无视这笔庞大的沉没成本。
微软试图让用户电脑里的显卡参与训练AI模型,算得上是一个不是办法的办法。
众所周知,AI模型的训练往往关联着一个词,那就是“万卡集群”,动辄千万亿参数规模的AI模型训练,通常需要数千甚至数万张计算卡协同工作。
为此,微软从边缘计算这一概念中汲取到了灵感,通过建立不同计算任务之间的依赖关系,再将整个训练过程拆分成多个相对独立的小型任务,也就是所谓的微型任务(Micro-tasks)。 系统根据不同设备的GPU性能、显存容量以及可用时间,将这些任务分配给参与网络的个人终端。完成计算后,个人终端再将结果上传,由服务器进行验证、整合,并继续推进后续的训练工作。
简单来说,微软是要建立一个围绕AI模型训练的承包体系,他们作为总包商将任务拆解成一个个零散片段,用户则在“任务公告栏”里领取适合自己设备的散单。