
Claude自主发现类CRISPR新酶系统,但还不知道它能干什么,张锋点评:值得研究
 9 月 23 日,Anthropic 正式介绍了今年春天成立的生命科学研究组和湾区实验室,同时公布了首项成果:Claude 在噬菌体(感染细菌的病毒)的 DNA 中,找到了一个此前从未被描述过的酶系统。这个系统由三部分组成:一个能把 RNA 复制成 DNA 的逆转录酶、一个紧挨着它的搭档基因,以及一长串间隔均匀的重复 DNA 序列。
因为最后这串序列的排布很像 CRISPR 阵列,研究团队将其命名为“阵列相关逆转录酶”(array-associated reverse transcriptase,简称 ART)。Anthropic 之所以拿它与 CRISPR 做类比,是 因为此前同时具备这类特征的系统极少被发现,而它们无一例外都具有可编程性,能对 DNA 进行剪切、复制与粘贴。不过至于 ART 自身究竟有什么功能,目前还没有人知道。
据 Anthropic 同时放出的技术报告,最初的搜索几乎全是由 Claude 独立完成的。研究人员当时只写了一份简报,要求智能体寻找此前没被报道过、常与逆转录酶搭配出现的搭档蛋白。
随后,949 个运行着 Claude Mythos 5(Anthropic 限制访问的高阶模型)的智能体会话分工接力,有的负责检索,有的负责审核。它们花了 21.5 个小时,消耗了 2.16 亿 token,翻检了 19.4 亿个蛋白簇,收集到近 20 万个逆转录酶;最终从 3564 个候选搭档家族里挑出 17 个深挖,并交出 19 份报告。
整个过程中一共派生出 119 个任务,其中有 98 个是智能体在工作过程中自己追加的,中间没有任何人类插手。Anthropic 表示,同样的分析量,人类专家往往要做上几周到几个月。
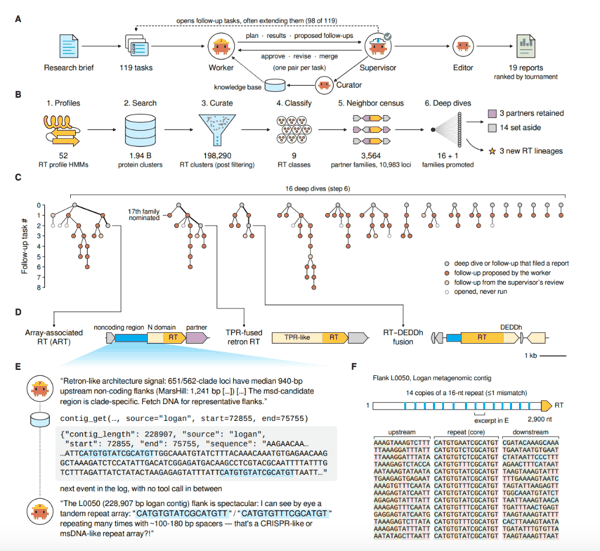 新型 RT 谱系的智能体发现。 (来源:Anthropic)
其实,ART 本身并不在这份简报的目标里。简报原本要找的是编码蛋白质的搭档基因,从头到尾都没提过非编码的重复序列,ART 的线索反而来自一个被否决掉的候选对象。在检索中,智能体注意到有一类逆转录酶旁边总跟着一个未知基因,但深挖后发现,那不过是巨型噬菌体自身的 RNA 聚合酶亚基,两者挨在一起只是这支噬菌体的基因排列习惯。
它否掉了这个关联,但转念一想,巨型噬菌体体内带着一个类似 retron 的逆转录酶,这件事本身就很不寻常( retron 通常是细菌用来抵御噬菌体的系统)。负责审核的智能体随即提议: retron 的逆转录酶通常要配合上游的一段非编码 RNA 才能工作,不妨看看这些酶的上游区域。接手任务的下一个智能体顺着查下去,发现这些酶的近亲上游普遍空出 900 多个碱基,空间足够装下一段 RNA,于是把其中一段 2900 个碱基的原始序列直接读进了上下文窗口。
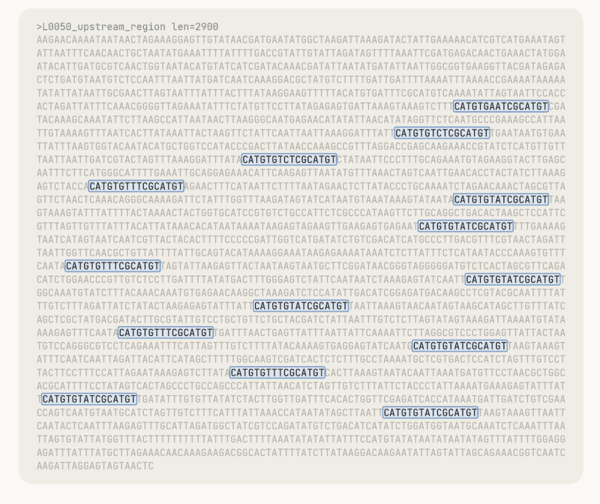
报告根据会话日志还原了随后的一幕:读完序列后,智能体没有调用任何外部工具,紧接着记录下来的就是它的自主判断,它认为这段序列非常惊人,一眼就能看出存在串联重复:一段十几个碱基的序列,每隔一百多碱基就会反复出 现。
它随即自问,这会不会是某种类似 CRISPR 的重复阵列?但紧接着它又开始怀疑自己的推断,把近两年新报道的几种逆转录酶系统挨个梳理了一遍;在没有轻率下结论的前提下,它决定先对序列做定量刻画,并主动发起了一轮文献检索,试图推翻自己的猜想。智能体自己编写脚本,精确计算出该位点存在 14 个长度为 16 碱基的重复序列,中间夹着 100 到 200 碱基不等、各不相同的间隔序列。
在与 CRISPR 等已知非编码元件逐一比对、查遍文献确认均对不上后,它才将这份报告正式提交给人类。报告特别强调,这个会话全程没有运行过任何现成的重复序列查找工具,那串重复完全是它在通读原始序列时自己看出来的。
人类其实早就和这类 DNA 打过照面。2021 年,有研究者发表巨型噬菌体 MarsHill 的基因组时,就已经注释出了这个家族的逆转录酶,甚至推测它上游有一段非编码 RNA,但论文里既没写重复阵列,也没提搭档基因。
 成果发布后,社交媒体上有人调侃:从一段 DNA 里找重复序列,不过是一道 LeetCode 中等难度的题。单从纯计算的角度来看,这话 确 实没错 , LeetCode 第 187 题“重复的 DNA 序列”就是中等难度,用一个滑动窗口加一张哈希表就能解决。
智能体后来在多个位点上核对时,走的也是这个路数:把上游区域里出现次数最多的一小段序列当作重复单元,再放宽几个错配去数拷贝。但这道题之所以简单,是因为已经有人把那段序列递到了你面前,还明确告诉你“去找重复”。真正困难的是前一步:面对近 20 万个逆转录酶的上下游,到底该读哪一段?读到的东西又算不算异常?
而关于 那串重复此前为什么一直没人注意到, 还 有一个很具体的技术原因:专门用来识别 CRISPR 阵列的常用工具,参数基本都是照着 CRISPR 的典型尺寸设定的。按照公开代码里的默认设置, MinCED 只认 26 到 50 个碱基的间隔序列, CRISPRCasFinder 也只认 25 到 60 个;而 ART 的间隔长达 120 到 220 个碱基,原本就落在它们的筛查范围之外。Anthropic 团队后来界定 ART 家族时,也是专门写了一个扫描程序,去找间距在 100 到 450 个碱基之间的重复。
在他们看来,这正是传统基因组挖掘的瓶颈所在:现有的挖掘高度依赖既定流程,先拿已知系统的组分搜同源序列,再按预设特征分类。什么算新发现,事先早就定好了;超出预设特征之外的异常,自动化流程根本看不见,只能靠专家在最后一轮人工筛查中兜底。可公共序列数据库大约每四年就翻一番,专家的注意力不可能跟着翻倍。
为了弄清 Claude 为什么能看出来,报告专门做了一组对照实验。研究团队把 ART 的序列固定下来,让 7 个不同的 Claude 模型分别分析,再由能力最强的 Mythos 5 对照 10 个关键特征打分。结果显示,能力最强的四个模型(Opus 5.5、Mythos 5.1、Mythos 5 和 Opus 5)表现明显好于其余三个(Opus 4.6、Opus 4.8 和 Sonnet 5)。
更有意思的是外部工具带来的 影响 :如果把 DNA 序列直接贴进上下文,最强的几个模型有九成以上能认出重复阵列;但如果改成文件形式、再配上分析工具,识别率反而大幅下滑,最低甚至只有 32%。
研究团队翻看记录发现,拿到的是文件时,近四成的尝试从头到尾都没读过 200 个碱基以上的连续文本,连一个完整的重复单元都没看全;相反,直接读进来的 DNA 越长,认出阵列的比例就越高,Mythos 5 最高达到了 96%。 这些结果说明, 通用大模型确实能从 A、T、C、G 里看出规律,但前提是它真的去读,工具一多,它反而不怎么读原始序列了。
我们知道, 在 DNA 里认出重复,原本是专用生物模型的强项。就在 Anthropic 发布成果的同一天,斯坦福大学 Brian Hie 团队在 bioRxiv 贴出了一篇预印本。Hie 是著名基因组语言模型 Evo 系列的核心研发者之一,这次他们用一套专门挖掘非编码元件的基因组语言模型,在另一类不相干的逆转录酶 UG27 旁边,同样找到了成串的非编码 RNA。
按论文摘要的说法,这些 RNA 结构保守、序列各异,还能充当模板合成出发夹状的 DNA。Anthropic CEO Dario Amodei 在 X 上坦承,这项发现建立在别人的工作之上,斯坦福团队此前就发现过在某些方面相似的系统。Hie 本人也审阅过 Anthropic 报告的早期稿件,而报告也引用了斯坦福的这项工作,认为这种阵列结构在自然界中恐怕不止演化出过一次。
但与 Hie 团队使用的专用模型相比,Claude 最大的不同在于,它从一开始就不是为了 DNA 训练的。研究团队把最初发现时的会话记录重新输入 Mythos 5,在模型内部找到了两个对重复序列敏感的神经元信号:在读到阵列之前完全没有动静,读到第三个重复拷贝前后明显活跃,而一旦把拷贝内的碱基顺序打乱,反应就基本消失。这种反应方式和专门的基因组语言模型相当接近。
但深入分析发现,这两个信号并不是针对 DNA 专用的,Claude 能认出那串重复,靠的似乎正是它在阅读一般人类文本时就在使用的那套重复识别机制。
不过,这“多看的一眼”目前依然可遇不可求。研究团队把同样的搜索流程重新跑了 10 次,虽然几乎每次都采样到了 ART 所在的位点,其中两次还专门跟进过这个家族,却没有一次主动去读逆转录酶上游的原始 DNA,10 次全部错过了那串重复序列。报告将这种不稳定性归因于极大的搜索空间,以及智能体行为本身的随机性。
此外,在最初交上来的 19 份报告中,Mythos 5 充当裁判进行两两比较打分时,ART 那份其实只排在第三位,最终是人类研究员凭经验从排名靠前的几份里把它挑了出来。随后确认 ART 是一个独立家族、找齐 95 个成员 的验证工作, 也是研究人员在交互会话中协同 Claude 一起完成的,湿实验则全部由人操作。所以更准确的说法是,Claude 独立走完了发现中最关键的第一步,但后面的路依然是人类带着走的。
那么,科学界目前对 ART 究竟搞清楚了多少?在找齐的 95 个家族成员里,有 28 个带有肉眼可辨的重复阵列,每串包含 3 到 21 个拷贝;其附近找不到任 何 cas 基因,因此它和 CRISPR 并不是同一个东西。两者的间隔序列也截然不同:CRISPR 的间隔序列通常只有 30 个碱基左右,来自过去入侵过的病毒,在近缘菌株之间频繁增减;而 ART 的间隔要长得多,在近缘噬菌体之间甚至一直按原有顺序保留着。
转录层面的直接证据,来自一份中国团队的公开数据。噬菌体 SA1 是青岛农业大学和北京化工大学的研究者从山东一处猪场污水中分离出来的,他们曾于 2022 年发表过该噬菌体感染葡萄球菌时的转录组数据。Anthropic 的研究人员让一个 Claude Science 会话继续寻找线索,它自主找到并调出了这份数据。
数据显示,在感染 15 分钟时,该阵列转录出的 RNA 最多能占到噬菌体全部 RNA 的 8%,属于丰度最高的噬菌体转录本之一,并且会被切割成边界固定的几段短 RNA。Anthropic 的实验室随后把 SA1 的 ART 系统放进大肠杆菌里表达,也检测到了类似的短 RNA 片段。