
陶哲轩启动“开放数学模型计划”:不依附大厂,为数学界打造自己的AI
 9 月 18 日,菲尔兹奖得主陶哲轩在个人博客上发布声明,宣布由他参与创立的非营利机构 SAIR 基金会(Foundation for Science and AI Research)正式启动“开放数学模型计划”(Open Math Model Initiative)。
这项计划希望联合数学界、科研机构和产业伙伴,共同研发面向数学及基础科学研究的开源、开放权重模型;同时搭建一套科研工具链,让研究者能够根据不同任务调用开源或闭源大语言模型。
一项被提前公布的计划
SAIR 基金会成 立于 2025 年,由陶哲轩与诺贝尔奖、图灵奖、菲尔兹奖得主等科学家共同发起,主要 关注 AI 与基础科学研究的结合,并强调由科学界参与决定相关工具如何开发、验证和使用。开放数学模型计划,也是这一思路下的一项最新尝试。
 不过,和科技公司 发布新模型的惯常方式不同,SAIR 暂时没有公布模型架构、参数规模,也没有给出 明确的训练时间表。
陶哲轩坦言,团队原本计划在未来几个月里先进行若干小规模试验,再逐渐扩大项目。 但考虑到“近期发生的一系列事件”,以及学界对于开放科学模型越来越强烈的需求,他们决定提前公布整个计划,并立即向全球学术界和产业界征集合作伙伴,希望获得资金、算力、专业知识和社区建设等方面的支持。
这里所说的“近期事件”,与过去几个月 AI 在数学领域突飞猛进的表现密切相关。
今年以来,OpenAI、Anthropic、Google 等前沿 AI 实验室都在加速进入高级数学研究。从埃尔德什相关问题、费马大定理的形式化证明,到数学和理论计算机科学中的多个长期开放问题,再到近期引发广泛讨论的纳维-斯托克斯方程存在性与光滑性问题,AI 已经开始参与过去主要由专业数学家推进的研究任务。OpenAI 此后还透露,其模型在另一道千禧年难题上也取得了重要进展。
这些成果展示了 AI 在大规模数学搜索、形式化证明和复杂推理上的潜力,也引发了数学共同体内部的讨论。
就在一周前,陶哲轩、邓煜等 25 位菲尔兹奖得主联合签署了一份题为 《数学领域中人工智能的严重失衡》 (A Severe Misalignment of AI in Mathematics)的声明。 签名者还包括皮埃尔·德利涅、彼得·舒尔茨、塞德里克·维拉尼和玛丽娜·维亚佐夫斯卡等数学家。
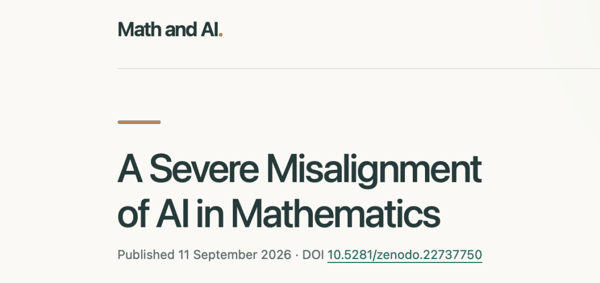 (来 源:Math and AI)
这份声明并没有反对 AI 进入数学研究,而是担心,当商业实验室越来越倾向于用“解决了多少著名难题”衡量模型能力时,数学研究原本重视的理解、解释、知识积累和学术协作可能会被解题速度挤到一旁。
此次的开放数学模型计划,可以说是数学界作出的进一步回应。
数学家开始自己造 AI
SAIR 给这项计划设定的第一阶段目标,并不是挑战最著名、最困难的数学问题,而是先进入数学家日常研究中那些繁琐、耗时,却又高度重复的环节。
例如,检查长篇论文中跳跃过大的证明步骤,追踪和核对跨领域参考文献,寻找特定条件下的算例与反例,辅助编写计算实验代码,以及把数学家使用自然语言写下的证明转化为 Lean 4 等证明助手能够检查的形式化代码。
从这些任务来看,SAIR 首先想做的,是一套真正进入科研流程的数学工具,而不是一台专门用来刷新纪录的“解题机器”。
这也直接影响了 SAIR 对模型能力的评价方式。 按照陶哲轩公布的设想,项目不会只看 Benchma rk 上的正确率,而会重点考虑三个指标:模型在辅助科研时是否足够可靠,输出结果能否留下可重复、可检查的验证过程,以及长期使用成本是否能够被普通大学和研究机 构承担。
在模型本身之外,开放也是整个计划最重要的原则之一。
SAIR 希望尽可能公开模型权重、推理代码、训练方法和评测体系,同时披露模型已经发现的能力边界和失败案例。 研究者不仅能够使用模型,也可以检查模型究竟是如何工作的,并在此基础上继续修改和开发。
数据则是另一项重点。按照目前公布的原则,SAIR 认为数学共同体应该拥有自己的研究数据,并决定这些数据如何被 AI 使用。 未经研究者明确同意、没有提前约定用途的数据,不应直接进入训练集。
这一点与目前大模型普遍依赖大规模互联网抓取的训练方式存在明显区别。数学论文、私人通信、尚未公开的研究笔记和正在推进中的证明,都可能涉及学术优先权和署名问题。一旦模型能够直接参与前沿研究,谁的数据被用来训练模型、模型成果如何追溯来源,就会成为越来越实际的问题。
因此,SAIR 计划让联合研发的工具和代码尽可能采用 MIT、Apache 2.0、CC BY 4.0 等开放许可,同时保留原始研究者对于独立成果的署名和相关权利。
更进一步,SAIR 希望让数学家参与模型本身的治理。 过去,研究者通常只是模型发布后的使用者:科技公司决定训练什么模型、如何收集数据、设置什么 Benchmark,学者再根据已有工具调整自己的研究方式。
开放数学模型计划希望把这个顺序稍微改变一下。数学家可以参与决定模型应该重点学习哪些能力,什么样的 Benchmark 才真正反映科研价值,以及有限的公共算力应该优先用于哪些问题。项目依然可能需要产业界提供计算资源和工程支持,但陶哲轩强调,合作的前提是保留学术共同体对于研究方向的独立判断。
SAIR 此前已经在较小范围内尝试过这种思路。 在其举办的“数学蒸馏挑战赛”(Mathematics Distillation Challenge)中,参赛者的目标不是让 AI 尽可能生成更长、更复杂的推理,而是把机器产生的大量推演结果压缩成数学家真正能够阅读和检查的证明文本。 进入后续阶段后,模型给出的证明和反例还需要通过 Lean 4 等形式化工具验证。
这个比赛的核心目标很简单:AI 给出的结果不仅要正确,还应该能够被人理解、检查,并重新进入现有的数学知识体系。