
高通骁龙峰会发了什么?大杯超大杯并不是真正亮点
文:硅谷观察 郑峻
大杯,超大杯;至尊,超至尊。今年高通一次发布了两款旗舰,但这却并不是今年骁龙峰会最大的亮点。
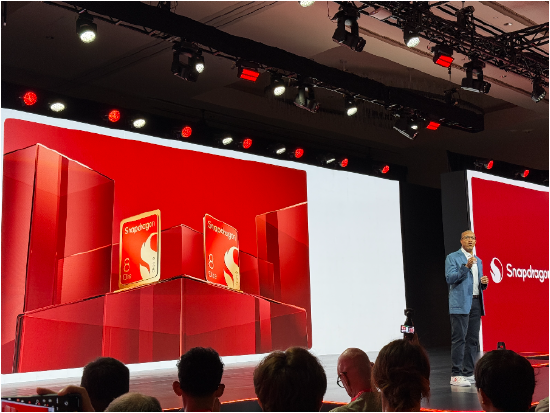
9月22日,高通在夏威夷毛伊岛的年度骁龙峰会上打破了自己保持多年的惯例,同时发布了两颗旗舰芯片:第六代骁龙8至尊版和第六代骁龙8超级至尊版。
高通骁龙移动业务高级副总裁兼总经理克里斯-帕特里克(Chris Patrick)在发布会上说:“今天我们带来的不是一款,而是两款全新旗舰移动平台,让智能体式AI体验变得即时、个性化、且能自我调整。”
两颗芯片差别并不大,同为台积电2纳米制程,Oryon CPU双主核心首次跨过5GHz门槛。高通这次真正想讲的故事,其实是芯片里的那颗Hexagon神经网络处理器(NPU),尤其是一个全新的模块:元件加速器(Element Accelerator)。
高通真正想讲述的故事是,智能体时代已经到来。推理成为关键,边缘侧将发挥重要作用,而骁龙正是面向智能体时代的处理器。一个不需要反复被提示、能记住用户习惯、能在手机本地跑到300亿参数级别大模型的AI引擎。
安蒙定调:智能手机不会被取代
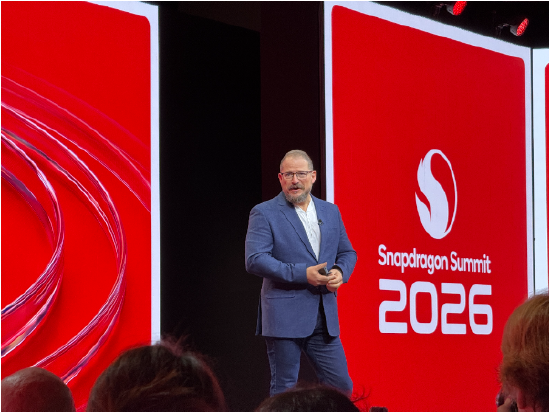
主题演讲开场时,高通CEO安蒙(Cristiano Amon)就确定了基调。针对近期关于AI硬件”下一代终端将取代手机”的猜测,安蒙直接给出了自己的观点:“智能手机的地位不会被取代。”(原文是手机哪儿也不会去。)
在他看来,手机是消费者唯一随身携带、持续在线、且已经积累了最准确私人语境的个人设备。这正是智能体完成任务所必需的基础;在高通看来,新的AI终端形态不会取代手机,只会围绕手机构建。
安蒙给“可用的智能体服务”划了两条硬性门槛:首先要有完整的安全、隐私保护和用户可控权限,其次才是比人工操作更省事。一段优秀的智能体体验,始于信任。所以高通要反复强调本地推理的原因:用户的行为数据和语境记忆存在本地,才能真正获得用户的信任。
他还给新增的AI能力划了一条不能突破的底线:不能牺牲智能手机原本“装进口袋、不发烫、能撑一整天”的基本要求;智能体能力必须是增量,不能是妥协。
两颗芯片差别并不大
高通手机业务负责人帕特里克介绍称,至尊和超级至尊这两颗芯片其实差别并不大,共享同一套全新Oryon CPU架构:8核设计,2个超级内核加6个性能内核,是全球首款主频突破5GHz的移动CPU。
他还特别提到一项新的缓存机制Oryon FlexCache:8个核心共享同一个L2缓存池,按需动态分配,目的是让智能体在CPU上来回调度推理、检索上下文、调用工具这类任务时切换更快,这比单纯的堆频率更贴近“智能体循环”(agent loop)真实的工作负载特征。
两个芯片版本的硬件差异主要体现在GPU和内存上:标准版配Adreno A845 GPU与12MB图形内存,搭配LPDDR5X内存;至强版换装更快的LPDDR6内存,Adreno 850 GPU配18MB专属高性能内存(HPM),图形性能相比上代提升44%、能效提升40%。
散热上,新一代平台还引入了名为Offset PoP的封装方案,通过调整内存与芯片的相对位置,为热量让出更高效的传导路径,官方数据是高负载下持续峰值性能的时长提升到两倍以上,算是用工程手段回应了安蒙那条“不能发烫、不能牺牲续航”的底线。
NPU里多出的“变形金刚”
相对于大杯超大杯,今年真正的技术看点在Hexagon NPU的内部结构调整。高通给两颗芯片的NPU都塞进了一个新硬件模块——元件加速器,专门针对Transformer架构的推理计算做优化。
Transformer正是几乎所有主流大语言模型(包括手机上跑的那些)背后的底层架构,这个专用加速器的意义,类似于当年专门为矩阵运算设计张量核心。
按照高通公布的数字,标准版NPU采用12个标量核心加8个矢量核心加1个张量核心加1个元件加速器的组合,NPU性能提升14%,能效比提升20%。超级至尊版由于共享内存扩大50%,NPU性能提升35%,能效比提升33%。
帕特里克在演讲中给出的另一项数字更直接:新NPU在部分模型上,预填充(prefill)阶段——也就是模型理解用户输入所需的时间——性能提升最高达80%,并首次在手机端确认支持32000个token的上下文长度。
32000个token是什么概念?大致相当于一篇两三万字的中文长文,或者一场持续数十轮的多轮智能体对话所需要的“工作记忆”。这已经不是简单的语音助手能力,而是要在手机本地支撑真正意义上的多轮任务执行。
300亿参数的分水岭
两颗芯片最大的差距,不在跑分,而在能塞进手机里的模型有多大。结合UFS 5.0存储和一套“智能闪存到内存管理”技术,超级至尊版可以直接从闪存运行超过300亿参数的混合专家模型(MoE),不必先把整个模型搬进内存——这类模型过去需要占用远超手机内存容量的空间。
MoE模型的最大优势是,不会一次性激活全部参数,而是每次只调用其中一小部分”专家”子网络处理当前任务,用更低的功耗跑出接近大模型的效果。
相比之下,标准至尊版没有公布对应的MoE参数上限,主打的是常驻的传感器中枢:双Micro NPU架构,性能提升85%、功耗降低20%,支撑“个人记录”(Personal Scribe)功能。按用户授权,实时索引对话、区分发言人,把关键信息整理进专属的个人知识图谱,为智能体持续积累可用的使用情境。
高通2023年首次在手机端演示Stable Diffusion图像生成,同年晚些时候实现了100亿参数级别语言模型的端侧运行;三年之后,300亿参数级别的MoE模型已经可以直接从闪存加载运行。
这些参数究竟有什么实际意义?高通给出了一个具体场景:智能体读取一封会议邀请函,理解其中的日期、航班、地点和日程安排后,调用MoE架构里负责理解、推理、执行的不同”专家”模块并行工作,几秒钟内生成一份完整的多日行程草案,用户确认后直接同步进日历。这些原本要花数小时协调的事,现在直接压缩到“点一下”。
值得一提的是,300亿参数级别的MoE模型,已经足够运行相当一部分开源大模型的手机适配版本,而不只是阉割版的轻量模型。这意味着旗舰机的AI能力和云端服务之间的差距,正在被实质性地拉近,意味着高通所谓的“端侧AI”战略真正落地。
HPC协处理器:数据中心的技术搬进手机
演讲中还有一个细节,是高通计划把源自数据中心的高带宽计算(High-Performance Computing,HPC)架构,以独立协处理器的形式部署进下一代骁龙平台。
这套架构把内存和计算单元集成在一起,思路与高通此前发布的数据中心AI推理芯片AI200、AI250如出一辙,只是这次要塞进手机。按照高通给出的数字,新架构能支撑智能体每天在设备本地处理最多100万个token,同时不影响手机全天候待机。
这意味着,高通”边缘到数据中心”的技术路线,第一次有了具体到芯片架构层面的对应关系,而不只是投资者日上讲的战略叙事。如果数据中心和手机端真的能共享同一套高带宽计算设计思路,此前市场对高通“数据中心与手机是两套独立技术硬凑在一起卖”的疑虑,至少在技术路线上得到了部分回应。当然,这套说法眼下仍停留在发布会PPT层面,具体的芯片实现细节高通还没有公开。
演讲还提到,这套智能体算力支持架构不会只留给手机。高通把这个思路称为”以用户为中心的生态”:PC理解用户如何工作、创作和沟通,XR设备记录用户如何与周围世界互动,音频产品知道用户在听什么、进行过哪些重要对话,可穿戴设备追踪健康数据和日常习惯。
手机是这些理解层汇聚、体验最终变得个性化的地方。智能体任务会根据场景自动在云端、本地设备和周边的个人AI设备之间分配算力,让用户感觉不到具体是哪台设备在干活。
这套算力换来的,是可以指名道姓的场景,而不只是PPT概念。
高通不再秀TOPS了