
并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
然而,并行起草始终面临一个核心悖论: 后一个位置在计算时,根本不知道前一个位置最终会选出哪个词。
这种 “盲猜” 会导致严重的多模态碰撞与后缀衰减(Suffix Decay):每个位置单独看概率都合理,拼在一起却前后矛盾。由于目标大模型按从左到右的严格前缀顺序进行验证,一旦中间某个位置衔接失败被拒,后面算好的所有草稿 token 都会全部作废。
为了补齐并行草稿的因果依赖,近期 DeepSeek 提出的 DSpark 以及 Domino、DFlash2 等工作纷纷给出了改进方案。但现有方法要么把依赖注入留到骨干网络计算完之后(如 Domino、DSpark 的轻量串行头),导致后继位置在特征形成阶段无法感知前驱倾向;要么在骨干内部直接混合相邻隐状态(如 DFlash2 的局部卷积),将上下文信息与预测信号混为一谈。
针对这一瓶颈,来自 腾讯优图实验室 、 上海交通大学 和 厦门大学 的研究团队提出了 DSpine(Draft in Parallel, Condition Through Depth) 。
 DSpine 的核心思想可以用八个字概括: 同时起草,逐层接力 。它不再苦等前一个位置最终选定离散 token,而是从草稿网络的第 1 层开始,就将前驱位置 “正在形成中的预测特征” 提取到统一的词元嵌入空间,逐层注入给紧邻后继;到了网络末端选词时,再通过转移缓存(Transition Cache)并行预计算相邻候选组合分数,用已确定的前驱 token 完成条件修正。
 论文标题:Draft in Parallel, Condition Through Depth: Adjacent Causal Injection for Speculative Decoding
论文链接:https://arxiv.org/abs/2609.36173
开源代码:https://github.com/tencent/dspine
模型权重: https://huggingface.co/collections/tencent/dspine
项目主页:https://dspine-project.github.io
在 Qwen3-4B 和 Qwen3-8B 的接受长度评测与 SGLang 服务吞吐评测中,DSpine 在所有数据、并发场景中取得 SOTA:相比 DSpark,SGLang 服务吞吐平均提升 19.0%(8B)和 20.1%(4B);相比最强基线 DFlash2,平均提升 11.1%(8B);相对标准自回归解码最高实现 4.01 倍加速。
更进一步,团队新训练了面向 Agent 专项优化的 Qwen3.8-27B DSpine 草稿模型:在开源 SWE-bench Pro、τ²-bench 以及真实办公场景 WorkBuddy Bench(Code / Web / Office)的评测中,且开启思考模式下,平均接受长度最高达 5.63,解码吞吐在并发 8 条件下最高达自回归的 3.84 倍。
目前, DSpine 已成功落地服务于腾讯 WorkBuddy 线上推理业务 ,推理代码与开源模型权重(七大基准平均接受长度高达 7.83)均已全面开放。
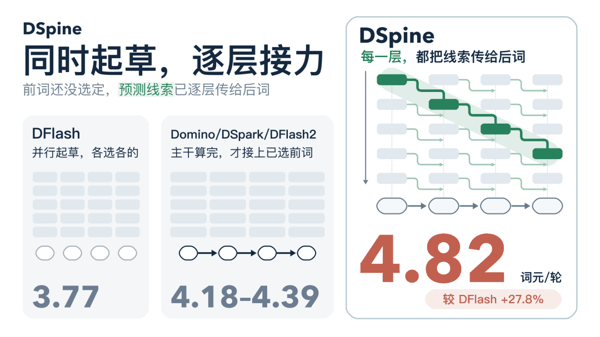 图 1 DSpine:同时起草,逐层接力。图中为 DSpine 与主流投机方案对比,接受长度为 Qwen3-8B 在七个基准上的平均接受长度。
一、两个关键实验洞察:前词线索何时出现?何时注入最有效?
为什么并行草稿会 “各说各话”?举个直观的中文续写例子:给定共同上文 “门口有一……”,位置 1 候选有 “只”、“辆”,位置 2 候选有 “猫”、“车”。“一只猫” 和 “一辆车” 都是高频自然续写,但如果两个位置在一次前向里各自独立选词,就极易拼出 “门口有一辆猫” 的荒谬组合。
要让位置 2 知道位置 1 想选 “辆” 还是 “只”,真的一定要等 5 层骨干网络全部算完、位置 1 吐出最终 token 吗?
研究团队通过对并行草稿模型中间层进行逐层探针与干预实验,得出了两个直接驱动 DSpine 设计的实证发现:
1. 靠前位置的预测信号在浅层就已浮现 :在相同的浅层网络深度下,块内靠前位置的 token 预测准确率远高于靠后位置。这意味着,当后继位置的预测还在缓慢成形时,前驱位置在浅层就已经具备了可读出的预测线索,完全可以在尚未最终选定 token 前就向下游传递信息。
2. 紧邻前驱不仅 “内容” 关键,而且 “注入越早” 收益越大 :即便更早的历史上下文完全正确,只要紧邻前驱变成存在偏差的草稿预测,后继预测准确率就会平均暴跌 31.8 个百分点 —— 说明再好的全局上下文也无法替代紧邻前词的直接约束。更关键的是,注入相同的可靠前驱特征时,在浅层提前注入比延后注入准确率平均高出 14.8 个百分点 。
结论非常明确:相邻位置的因果依赖不应该拖到骨干网络结束才做 “事后补救”,而应该 从第 1 层起就进入后继位置的表征计算 。
二、DSpine 方法解析:把因果链折进网络深度
基于上述洞察,DSpine 在保持单次前向、同层全位置并行更新的前提下,通过四项核心设计将因果依赖构建在网络深度(Depth)之上。
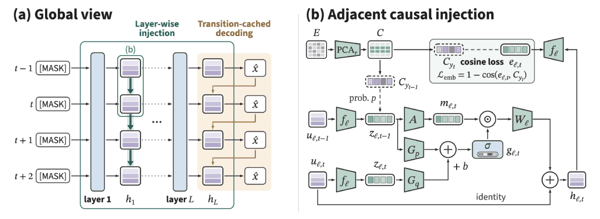 图 2 DSpine 整体架构:草稿网络逐层将前驱预测特征传给后继,最终选词时再使用已经确定的前驱 token;同一层内仍并行更新。图源:DSpine 论文。
1. 统一传递空间(Unified Transfer Space):只传 “选词倾向”,不传混杂隐状态
如果直接把前驱位置的 Transformer 隐状态传给后继,由于隐状态中混杂了大量上下文聚集信息,后继位置很难从中剥离出 “前驱到底想选哪个词”。而如果要在中间层直接做词表解码,十几万词表的计算开销又不可接受。
DSpine 巧妙地利用目标大模型冻结的 LM Head 输出嵌入矩阵来构造统一传递空间:对 LM Head 做归一化与 PCA 白化(去除所有 token 共享的共性分量,保留核心主方向),得到紧凑词元表。在骨干网络内部,每一层将隐状态通过轻量投影映射为预测特征;在末端选词阶段,已确定的离散前驱 token 则直接查表映射为对应的词元向量。
由于 “预测中的特征” 与 “已选定的 token” 处于同一个几何空间、拥有完全相同的代数形式,DSpine 可以用同一套注入通路无缝贯通层间特征传递与末端条件解码。
2. 逐层门控相邻注入(Adjacent Causal Injection):同层并行,跨层接力
在草稿网络的每一层 Transformer 之后,位置 t 接收紧邻前驱 t-1 的预测特征,并结合自身特征计算门控(Gate),自主决定吸收多少前驱信息并写回残差流。
为什么这不会破坏并行性? 因为在每一层内部,所有位置读取的都是本层更新前的特征,全块所有位置在同一层内完全并行计算。而前驱位置在第 l 层传出的线索,会参与后继位置在第 l+1 层的计算,并进一步向后传递。如此一来,因果依赖链顺着网络深度逐层向后展开,无需增加任何串行骨干步数。
3. 逐层输出嵌入监督:为什么不能直接用全词表 CE?
为了督促浅层尽早形成清晰的预测特征,并与末端注入的真实 token 嵌入对齐,DSpine 在每一层注入后直接与真实目标 token 的紧凑嵌入计算余弦方向对齐损失(Directional Alignment Loss)。
消融实验揭示了一个非常有意思的反直觉现象: 如果在中间层直接施加全词表交叉熵(Token CE)监督,接受长度不仅不升,反而在多项基准上跌破无监督的 DFlash 基线! 原因在于,强行要求中间层隐状态直接做全词表分类,会挤占并干扰后续层所需的上下文表征计算;而 DSpine 仅对低维投影的方向做余弦约束,既让预测线索在浅层清晰浮现,又让完整隐状态自由服务于上下文建模。
4. 末层条件解码与转移缓存(Transition Cache):把串行选词变成并行查表
当骨干计算结束,每个位置先选出初始的 Top-K 候选集。此时从左到右正式选词:一旦前驱位置确定了具体 token,DSpine 就把最后一层注入模块的输入从预测特征替换为真实词向量,直接修正后继位置的候选得分(Last-Write Refinement)。
如果每确定一个前驱才去算一次后继得分,就会退化成串行矩阵运算。DSpine 引入了 转移缓存(Transition Cache) :因为末层修正只依赖紧邻前驱的候选 token,模型在选词开始前,直接一次性并行算出所有相邻位置候选组合的条件得分矩阵。随后从左到右选词时,只需在缓存表里做极速查表,彻底消除了逐位置的串行矩阵乘法开销。
三、实验结果:28 组接受长度与 40 组服务吞吐全满贯
研究团队在 Qwen3-4B 和 Qwen3-8B 上系统对比了 DFlash、Domino、DSpark、DFlash2 与 DSpine,评测横跨数学(GSM8K、MATH-500)、代码(HumanEval、MBPP、LiveCodeBench)与对话(MT-Bench、Arena-Hard)共 7 大基准。
1. 接受长度:28 组评测全部第一,采样模式下优势更猛