
Embodied RSI范式突破机器人零样本泛化瓶颈:Recursia长时任务超英伟达ASPIRE 10个点
机器之心发布
机器人 RSI 时刻远远未到达,先看一个动作:机械臂把碗放到盘子上,再抓起杯子,放进刚刚移动过的碗里。
视频 1. 长序列真机任务 T3 :先把碗放到盘子上,再把杯子放进移动后的碗里。
对人来说,这只是顺手收拾桌面。对机器人来说,即使识别、抓取、放置等单项技能已经相当可靠,第二步也发生在一个被第一步改变过的世界里:碗的位置更新了,机械臂的姿态变了,接下来可能看不清、抓不稳或放不准。所以, 核心研究问题是:能否自动通过源任务学习技能,并把源任务上学到的单技能可靠地组合到新的任务中?
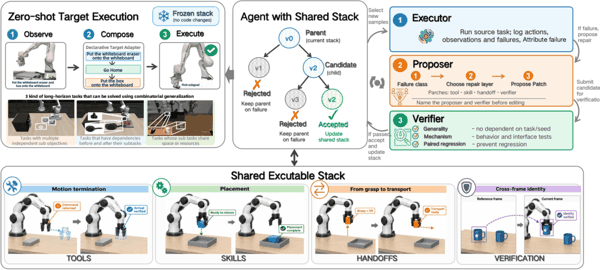
来自北京交通大学、北京大学、纽约大学(NYU)、南加州大学(USC)、北京灵行智能科技有限公司等机构的研究团队提出了 Recursia,把这个 “组合泛化问题” 放进具身 RSI,也就是递归自我改进的讨论中。 Recursia 将系统组织为 “内外双层循环”:内层 Agent(Inner Loop)负责当前任务中的观察、决策和代码执行;外层 Agent(Outer Loop)汇总执行经验,提出、验证并保留对共享栈的修改,让有用的改变进入后续循环。
实验发现,Recursia 在目标任务上不进行代码调试的零样本迁移设置下,在 LIBERO-Pro Long 上取得 28%(位置扰动)/ 53%(任务扰动)的成功率,比英伟达 ASPIRE 分别 高出 5.8 和 15.1 个百分点 ,而 OpenVLA、π₀ 等 VLA 模型几乎全军覆没(0%),π₀.₅ 在两类扰动下分别为 8% 和 1%。另一组迭代分析中,Task 方向的成功率从第 0 轮的 0% 提高到第 18 轮的 43.4%,中间存在波动。按表 1 的真机结果,Recursia 的三任务平均成功率比 SD-only 高出 40 个百分点(66.7% vs 26.7%) ;其中 “先把碗放上盘子、再把杯子放进移动后的碗” 这一强组合依赖任务,基线为 20%,Recursia 为 100%。
这条结果之所以值得注意,是因为它发生在具身智能最尴尬的背景上:部分 VLA 路线训练时 overfit,漂亮 demo 背后经常会有很差的泛化,换个物体位置、换句任务描述就当场罢工。训练场景中的高成功率,不等于换个位置、换种任务组合后仍然可靠。LIBERO-PRO 等研究已经揭示,部分 VLA 模型对任务与场景扰动较为敏感。多模态大模型通过代码调用感知与控制工具的 Embodied Agent 路线,为组合泛化提供了另一种可检验的途径,也让一个更激进的设想浮出水面:如果 Agent 能从失败中学习,它能不能改进 “改进自己的那套机制” 本身?[3,4]
这就是 Embodied Recursive Self-Improvement(具身递归自我改进) 所追问的问题。听上去有点科幻:AI 先把自己改得更强,再用更强的能力继续改自己。目前不同工作对 RSI 的使用范围并不完全相同:有的侧重把经验写进记忆或技能,有的进一步改变产生改进的机制。这些工作都有价值,但距离 “机器人能持续研发更强的下一代机器人”,还需要不同层次的证据。
理解 Embodied RSI,关键在于追清楚一件事:这轮到底改了什么,改动有没有留下来,又能不能让下一轮改进做得更好。把这条线理顺,参数、上下文、记忆、Skills、Harness,以及各种眼花缭乱的论文,就能放回各自的位置,也能看清 Recursia 的研究位置。项目主页与代码地址如下。
 论文标题:Learning to Compose: Recursive Self-Improvement of Shared Executable Stacks for Zero-Shot Long-Horizon Robot Manipulation
项目主页:https://cocacola-lab.github.io/Recursia-website/
项目 GitHub:https://github.com/cocacola-lab/Recursia
一、背景:我们距离机器人 RSI 有多远?
用编程举例,Coding Agent 在单次任务中通过 “写码→测试失败→修复→再测试” 的 在线闭环纠错 ,交付更好的产物; 自我改进(SI,也叫自进化) 还要求把经验沉淀为可复用的记忆、技能或工具,让改进在后续任务中持续生效。本文采用更严格的 RSI 讨论口径:这种改进还应增强系统发现、设计和验证下一轮改进的能力, 即让 AI 去改进 “改进 AI 的 AI”。 [5]
从 Agent 的角度来看,RSI 已是兵家必争之地。国外 AI 御三家在本月均有密集动作,可能正在集体冲刺 “奇点”。早在 6 月,Anthropic 发表了一篇名为《When AI builds itself》。官方坦言,截至 2026 年 5 月,Claude 自己撰写了公司内部超过 80% 的合并代码;8 月份,由 AI 担任主导开发的比例已经从年初的个位数飙升到了约 26%。OpenAI 在 GPT-5.6 的官方介绍中列出了 RSI Index。谷歌近几个月节奏明显加快。[6,7,8,9]
从机器人角度看,Embodied RSI 可能也是通向 “终局” 的一条重要路径: 让机器人在与世界交互的过程中,持续积累能力,并逐步接管 “改进自己” 的工作。英伟达已经从两端推进。ASPIRE 根据执行反馈修复控制程序,将有效经验沉淀为可复用的技能库;ENPIRE 则重点打通真机上的外层改进循环,串起场景复位、策略执行、结果验证与训练改进,让 Coding Agent 根据真机实验持续修改策略与训练代码 [2,10]。其他路线也在汇合:RoboFoundry 将上下文、记忆与分层技能组成的系统作为进化对象;EmbodiRSI 则根据执行反馈,在面向部署场景构建的仿真中调整下一轮数据采集与策略训练,再迁移回真机。[11,12]
这些工作把问题推向了更深一层: 机器人究竟应该怎样组织用于执行的 “内层循环”(Inner Loop)与用于进化的 “外层循环”(Outer Loop)?
Recursia 的回答是内外双层循环。它的着力点,是把 “内层如何闭环、外层如何改写并验证” 放在一起研究:既让机器人更好地完成眼前的任务,也让这次经历真正改变下一次执行任务的能力。
二、Recursia:怎么让内外双层循环起来?
2.1 先让内层循环转起来:机器人要看着结果再做下一步
在 Recursia 中,内层负责执行任务,外层负责根据执行经验改进系统。内层架构决定机器人在一项任务里如何行动,也构成外层改进后实际部署的执行系统。内层本身有不同架构:是否让模型在执行中反复回来 “看一眼、想一步”,会改变任务如何推进。Recursia 比较了三种设计。
1.Rule-based:预设规则驱动,去掉在线 Agent 决策循环的极端配置
按预先定义的规则组织高层行动,运行中不依赖大模型反复读取新结果、重新决定下一步。这里所说的 “没有内层 Loop”,指可以看作省去模型在线推理循环的极端版本。
2.One-shot:先生成任务程序,再执行
先生成任务程序,再执行它。程序内部可以包含观察、条件分支和有限重试,但高层逻辑主要由这次生成确定。它依靠预先写好的程序逻辑处理执行中可能出现的情况,也承担了提前预见这些情况的要求。
3.Online closed-loop:根据反馈决定下一步,让执行结果持续进入下一次决策
在任务推进过程中读取新的观察和执行结果,决定接下来的动作。上一段代码实际做成了什么,会影响下一段代码如何行动。内层于是形成观察、决策、执行、再观察的循环,也就是具身 Agent 的运行过程。可以简单理解成 “模型+运行框架”,即 Agent = Model + Harness:模型负责理解、推理和生成,运行框架组织观察、工具调用、执行反馈与后续决策。[4]
这三种方式代表了不同的内层架构。比较它们,能够检验把高层决策接回执行反馈之后,机器人是否更有能力应对任务中的变化。Recursia 在相同冻结共享栈上做了内层循环的的对照实验,如下。
内层循环的分析实验:模型参与高层组织,相对规则式执行取得更高成功率。
在同一个 N=13 冻结共享栈上,论文比较了上述三种内层架构,每种架构在 Pos 和 Task 两个扰动方向各评测 50 个匹配回合(图 1 (a)、(b))。Pos 改变物体初始位置,Task 改变任务设定。
主题:机器人