
对决RoboColiseum!GPT、Claude、Gemini机器人能力PK,险胜之后还有黑马
编辑|Clio
如果让 GPT、Claude、Gemini 直接指挥机器人干活,谁更靠谱?
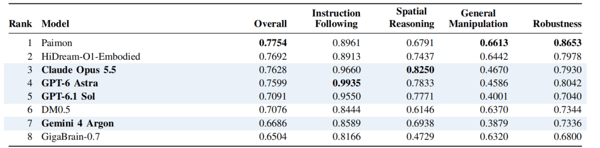
10 月 20 日,具身智能评测平台 RoboColiseum 发布的评测报告给出了一组实测结果:在四款参评的多模态模型中,Claude Opus 5.5 以 76.28 分取得最高综合成绩,GPT-6 Astra 以 75.99 分紧随其后,两者仅相差 0.29 分。GPT-6.1 Sol 和 Gemini 4 Argon 则分别以 70.91 分、66.86 分位列第三、第四。
RoboColiseum:https://robocoliseum.ai/
Techreport:https://robocoliseum.ai/techreport/agent2act
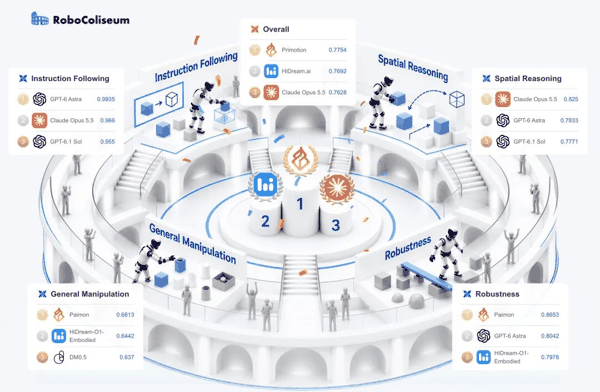
不过,在报告收录的官方总榜中,前两名仍然属于专业具身策略模型:Paimon 和 HiDream-O1-Embodied 分别取得 77.54 分和 76.92 分,排在 Opus 和 Astra 之前。
总分接近,能力分布却不同。Astra、Sol 和 Opus 在指令跟随、空间理解两个维度上,都超过了表内相应维度得分最高的策略模型;但在通用操作上,四款多模态模型均落后于报告所列的策略模型。
 模型已经理解了任务,为什么还是做不好某些动作?除了比较排名,本轮报告也通过环境扰动、控制系统配置对比和操作案例,尝试回答这一问题。
RoboColiseum 于 2026 年 8 月 14 日正式发布,是面向全球高校、科研机构、模型企业和研究者长期开放的具身智能仿真评测平台。目前,平台已推出指令跟随、空间理解、扰动适应和通用操作四类能力子榜,以及 78 个高保真仿真评测任务。自内测上线以来,已有海内外 100 多支队伍在平台开展模型训练与评测。
先看一个端锅案例。
在原始指令下,GPT-6 Astra 尝试抓取锅具,但夹爪的接近姿态不够协调。研究团队补充明确的抓取与交互指导后,它转而对准锅柄,采用对齐更好的双手抓取方式,持锅也更加稳定。
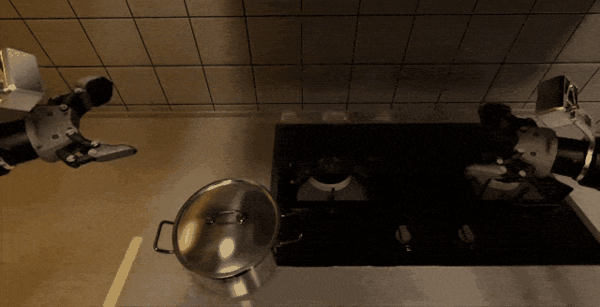 双臂端锅失败
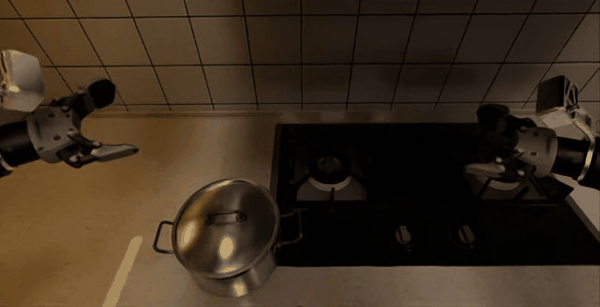 双臂端锅成功 抓哪里、夹爪怎么转、两只手如何配合,都需要模型判断物体与机器人该怎样接触。认出物体之后,还得把视觉理解、空间判断和动作规划衔接起来。
这一案例来自正式打榜之外的补充探索,不计入四款模型共用原始指令的榜单比较,却直观地呈现了理解与操作之间的距离:模型能够执行更明确的操作指导,自行推断合适的抓法仍有困难。
类似的差距,也出现在精细操作中。面对圆形积木,Astra 调整姿态后完成了入孔;换成手机充电,连接头却未能准确对准充电口,最终没有完成插接。
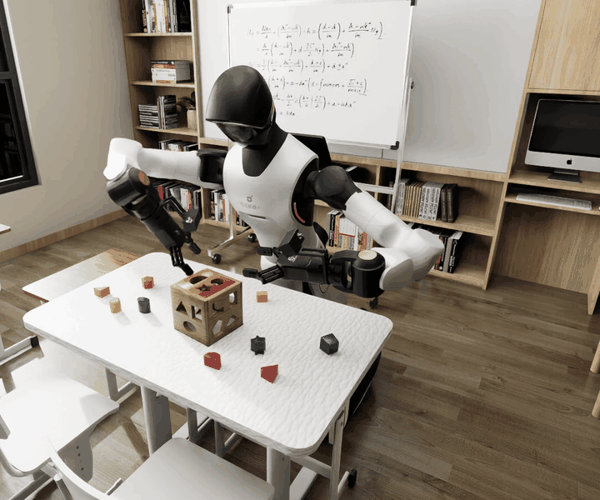 积木入孔:Astra夹取圆形积木并完成入孔
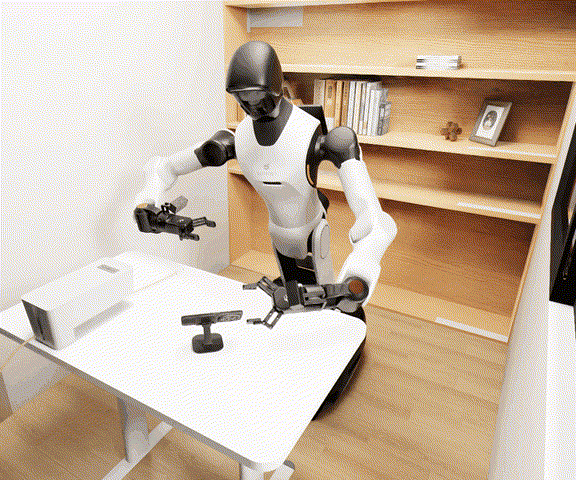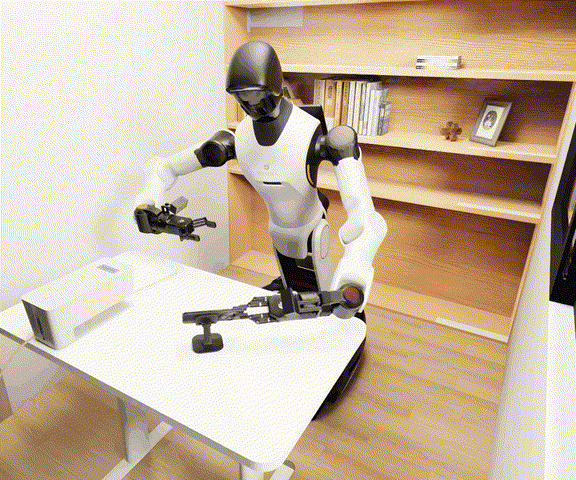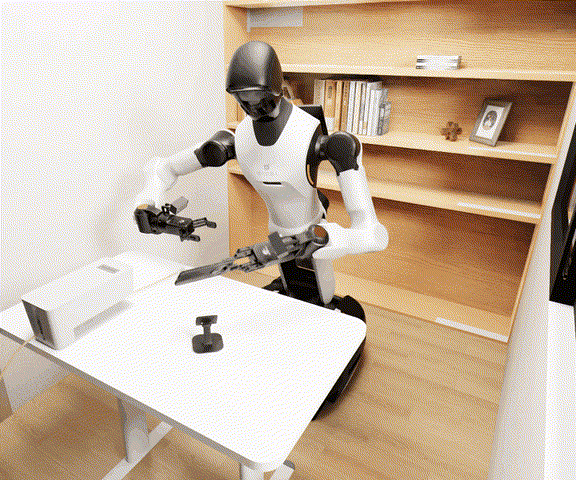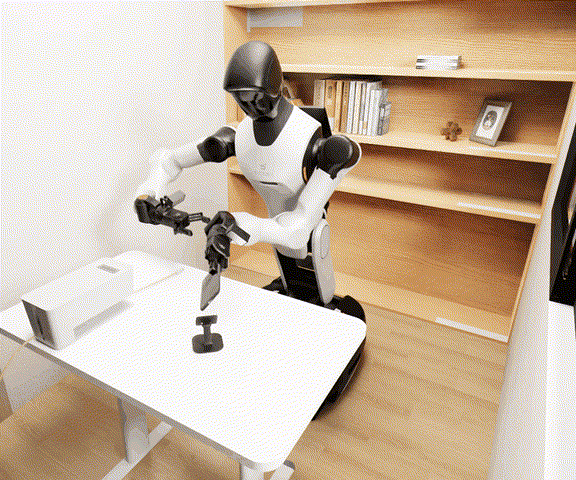 手机充电:Astra抓取成功,但充电口方向错误无法接入 在灵巧手叠碗实验中,Astra 可以为每只手的 20 个手指关节输出角度目标,也会调整手指和手腕,但始终未能形成稳定抓握。即使进一步提供手指、手掌的位置和几何信息,任务仍未完成。
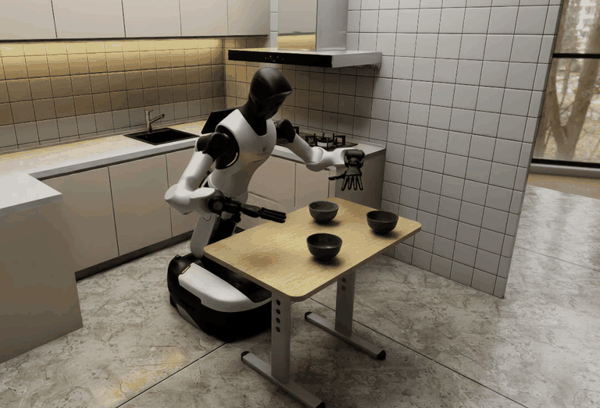 灵巧手叠碗:Astra能够接近、接触,但是尝试抓取失败
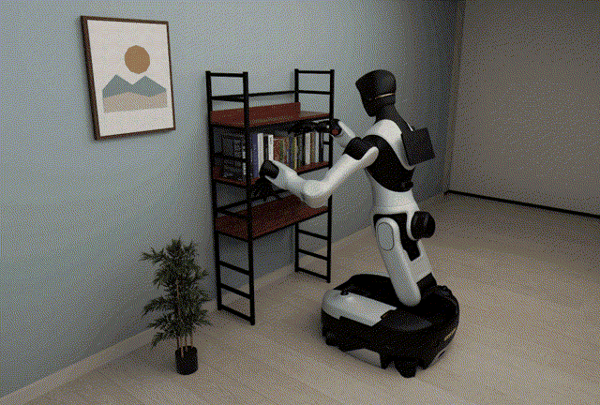 灵巧手取书:Astra多次调整抓取姿态,仍取书失败 从让手指动起来,到让多根手指协调接触、稳稳托住一只碗,模型还需要跨过一道坎。这样的操作短板,在榜单中也有体现。
四款模型各自强在哪?
本次评测通过 Agent2Act 控制框架,将四款模型接入 RoboColiseum。对应测试案例使用相同样本和固定随机种子,四类能力测试均采用原始评测指令,不额外增加任务专属提示。模型根据观测决定行动目标,框架负责动作校验、执行转换和反馈,最终由平台原生评测机制评分。
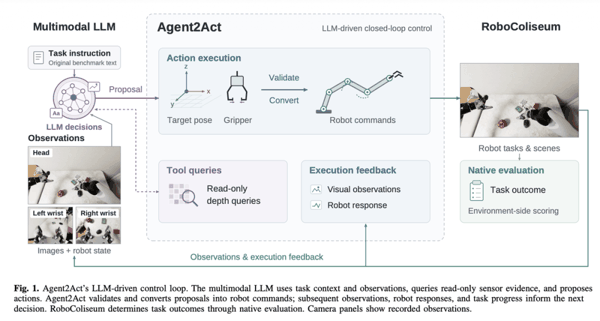
推理设置存在一项差异:Astra、Sol 和 Opus 使用 high,Argon 使用 medium。报告解释,在本次 API 通道下,Argon 的 high 设置响应过慢,难以支持大规模批量评测。因此,涉及 Argon 的比较也反映了推理设置差异。专业策略模型则保留各自的训练与执行设置,并未采用同一套控制方案。
在上述条件下,四款多模态模型各有强项。
Claude Opus 5.5 不仅综合得分最高,在空间理解和通用操作方面也领先其他三款模型。GPT-6 Astra 则在指令跟随和整体扰动适应能力上表现突出。
GPT-6.1 Sol 的选择价值更多体现在成本上。结合报告采用的参考 API 价格和 Token 用量统计,它以较低的估算推理成本取得 70.91 分,为需要平衡任务表现与调用开销的开发者提供了另一种选择。
Gemini 4 Argon 则呈现出一些反差:它的综合排名相对靠后,扰动适应总分却高于 Sol;在包裹分拣任务中,它还以 0.56 的任务得分领先另外三款模型。
但如果把目光转向专业策略模型,通用操作上的差距就显现出来了。按百分制换算,四款多模态模型在这一维度的得分为 38.79—46.70 分,报告所列策略模型则为 63.20—66.13 分。这也说明,综合排名无法代替细分评测,选模型还要看具体任务和成本。
环境变化同样可能改变判断。报告考察了背景与光照、相机位置、图像质量、指令措辞和机器人初始姿态五类扰动,图像质量变化是四款模型共同的突出弱点。
测试通过随机丢帧、镜头遮挡和额外图像噪声模拟视觉干扰。在本轮扰动类型和强度下,相对于各自的指令跟随基线,Opus 得分下降约 20 个百分点,Argon 下降约 26 个百分点,Astra 下降约 32 个百分点,Sol 则下降约 77 个百分点。
Sol 正常条件下的指令跟随得分为 95.50 分,受到图像质量干扰后降至约 18 分;Opus 在同类扰动下仍取得约 76 分。