
通用大模型要「降维打击」具身智能?首个AA
通用大模型要「降维打击」具身智能?首个AA-Robotics榜单来了
2026年10月15日 12:17
编辑|Neo
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
10 月 14 日,知名大模型评测机构 Artificial Analysis 把这些在数学、编程等领域表现出色的大模型,拉进了一场真正的机器人考试。
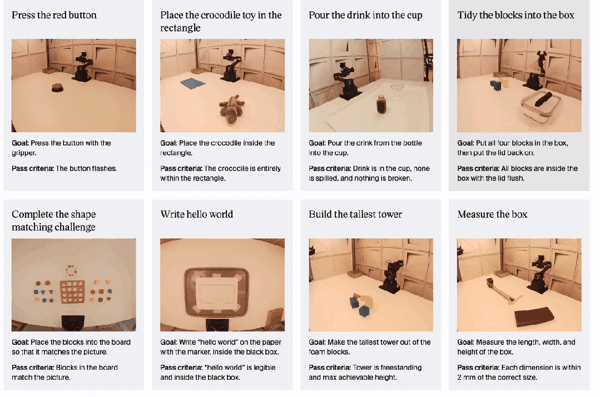
在新发布的 AA-Robotics v0.1 评测中,GPT、Claude、Gemini 等前沿模型需要控制真实机械臂,挑战倒水、写字、搭积木等八项任务,比一比谁的「动手能力」更强。
结果,大模型们刚一上手,就闹出了不少笑话。一台机械臂花了十几分钟,终于把几块泡沫积木搭成了一座合格的高塔。背后指挥它的 GPT-6.1 Sol 明明已经完成任务,却仍然不肯停手,继续调整积木, 结果反而让这项任务以失败告终 。
这只是此次机器人考试中颇具戏剧性的一幕。
首批结果同样充满反差: GPT-6 Astra 排名第一 ,通用大模型已经能够借助编程 Agent 操控真实机械臂;但它们 完成一项任务平均需要约半小时 ,比人类基线 慢了将近两个数量级 。
 这份成绩单,也让机器人行业最近的一场争论有了新的讨论依据:随着通用大模型越来越强, 具身智能公司专门训练的「机器人大脑」,究竟还有多少不可替代的价值?
「机器人大脑」,会被通用大模型取代吗?
上个月,GPT-6 Astra 控制机械臂画金门大桥、抓取积木、模仿人类操作的视频接连刷屏。一台售价约 150 美元的机械臂,在 Astra 的控制下,竟然能根据摄像头画面自主规划动作,一笔笔画出金门大桥。
更有说服力的实验来自 RoboCurve。在它的实机测试中,Astra 控制双机械臂,把红色积木放进碗里, 20 次成功了 19 次 。这样的成绩,让不少人开始追问:既然通用大模型已经懂视觉、空间、推理,还能编写控制代码,机器人公司为什么还要投入大量时间和金钱,从头训练自己的 VLA 模型?有人甚至提出,机器人领域的 OpenAI,可能就是 OpenAI 自己。
但身处具身智能行业的人,并不完全买账。
9 月 10 日的外滩大会上,自变量机器人创始人王潜谈到这种「降维打击」的说法时,判断目前可能性不大。他的理由是,模型的能力来自数据。编程模型变强,背后有大量代码数据和成熟的验证体系;机器人面对的物理世界,同样需要专门的数据、评测、硬件与基础设施,不会因为语言模型强大就自动解决。王潜还提到,Astra 并非与机器人数据完全绝缘。因此, 通用模型能控制机械臂,并不能简单理解为语言能力自然迁移到了物理世界。
破壳机器人创始人许华哲也动手试过 Astra。它能识别桌面物品,甚至抓起一根筷子;但一旦要求它用筷子进行更复杂的接触操作,表现就明显下降。在他看来,语义理解、空间理解的进步令人惊喜, 复杂的物理交互却还是另一道题。
双方争论的焦点,由此逐渐清晰:通用大模型能不能「动手」,已经不是唯一问题;它到底能做多少,能否做得稳定、迅速,才更关键。
AA-Robotics 恰好提供了一把新尺子。
GPT-6 排第一,
但机器人考试远没有那么简单
Artificial Analysis 此前一直在追踪大模型的推理、代码能力、速度和价格。这次,它把考场从屏幕搬到了桌面。
每款模型都获得一台 Hiwonder NexArm 机械臂的控制权。这是一台带五个关节和一个夹爪的六轴机械臂,桌面周围和机械臂手腕上共布置四个摄像头。
模型起初只知道机械臂的名称、如何通过 HTTP API 与它通信,以及如何提交任务。它得自己看摄像头、理解物体位置、编写并运行程序,让机械臂完成动作。GPT 模型运行在 Codex 中,Claude 使用 Claude Code,Gemini 使用 Antigravity。 八项测试均为零样本尝试,不会为了当前题目再训练一次。 这套评测考察的是通用大模型如何借助编程 Agent 和机器人控制接口,理解环境、规划动作,并最终完成真实世界中的操作任务。
首批五款模型的综合成绩已经公布:GPT-6 Astra 得到 69.4 分,GPT-6.1 Sol 为 64.6 分,Gemini 4 Argon 为 55.3 分,Claude Opus 5.5 和 Claude Fable 5.1 分别为 48.8 分、46.3 分。