
英伟达开源IMO金牌配方:不仅是「人海战术」,1.5 TB显存做实AI「推恩令」?
 用三套 checkpoint 完成多轮证明搜索,用过程透明平息学术怒火,用 1.5TB 显存门槛锁定算力霸权。名为代码平权,实则算力集权。
作者丨 郑佳美
编辑丨岑 峰
9 月 9 日,NVIDIA 公布了 Nemotron 3 Ultra 在 2026 年 IMO 上使用的整套数学推理系统。
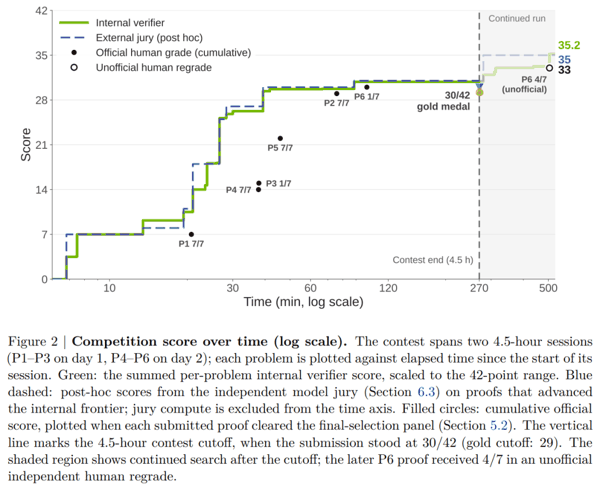
这套系统最终拿到 30/42 分,超过当届 29 分的金牌线。整个比赛过程中,模型只用自然语言写证明,没有调用 Lean 等形式化证明器,也没有借助外部工具或联网检索。
但这次发布的重点不只是成绩。NVIDIA 还把支撑这 30 分的两个数学专家 checkpoint、SFT 与 RL 训练数据、推理代码、训练配方、比赛提交证明,以及 200 道新的 Nemotron-IMO-Bench 一起开放了出来。
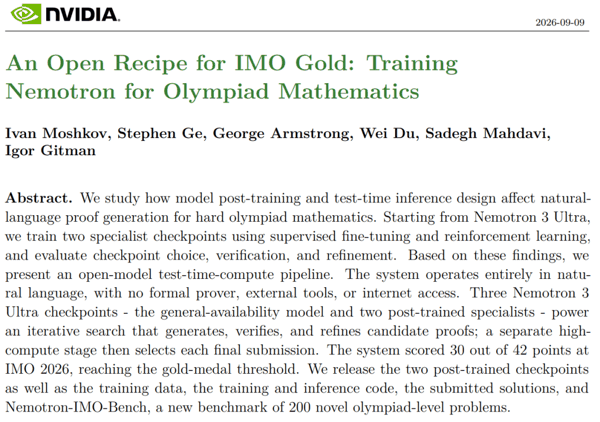 换句话说,这次公开的是一整套从训练到比赛推理的系统,而不是单独放出一个更强的数学模型。Nemotron 3 Ultra 只是底座,后面两个专家模型、大规模证明搜索、模型验证和多轮改写,共同组成了把成绩推到 IMO 金牌线的完整链路。
两天后的 9 月 11 日,陶哲轩、Peter Scholze、Maryna Viazovska 等 25 位菲尔兹奖得主联合发声,批评 AI 数学成果发布越来越快,而证明检查、方法梳理和复现往往没有足够时间展开。
 放在这样的背景里,NVIDIA 这次开源比较少见的一点,是把一个 IMO 金牌级结果背后的模型、数据、推理流程和计算成本都留了下来。
而这套系统的技术起点,是 NVIDIA 没有继续对同一个 Nemotron 3 Ultra 反复采样,而是先训练了两个行为明显不同的数学专家。
 01
两个专家 checkpoint
Nemotron 里面一个比较核心的设计,是让后训练直接服务于后面的搜索。
SFT 数据里除了完整证明,还加入了大量证明修改、验证和再次验证的轨迹。这样训练出来的模型,学到的不只是从题目生成证明,还包括拿到一份已经写了一半、甚至局部存在错误的证明以后,怎样判断哪里出了问题,再沿着原来的路线继续修。雷峰网
放进搜索系统以后,这种能力会直接影响计算资源的利用方式。高难数学题很少只有会做和不会做两种状态,大量候选其实处在中间区域,主体结构已经接近可用,只在某个引理、边界条件或者推导闭环上出了问题。
 一个只会重新作答的模型,每次失败后都要重新进入整个证明空间;接受过修改训练的模型,则可以把已有证明当成中间状态继续推进,相当于保留前一次计算里已经找到的有效结构。
RL 专家处理的是另一层问题:怎样改变这些证明路线被抽中的概率。IMO 级题目的证明空间非常稀疏。模型可能已经具备解决某类问题所需的局部能力,但正确组合只占生成分布里很小的一部分。
继续增加采样当然可能碰到这条路线,但如果大多数样本仍集中在相似区域,算力增加以后,实际覆盖范围扩大得并不会太快。雷峰网 (公众号:雷峰网)
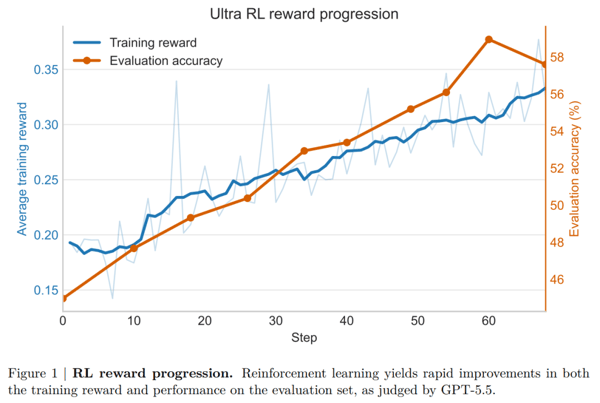 强化学习在这里做的,是根据成功和失败轨迹重新调整生成分布。那些能够把证明完整闭合的思路获得更高权重,反复把模型带进死路的选择被压低。它并没有凭空增加新的数学知识,而是在重新安排模型已有能力出现的频率。
于是通用版、SFT 和 RL 三份 checkpoint 形成了三种不同的解题偏好。这个差异对后面的搜索很重要,因为搜索效果取决于有效样本量,而不只是表面上生成了多少份答案。
如果同一个模型连续生成 200 份证明,其中大部分围绕同几种构造打转,那么 200 份文本并不等于 200 条互相独立的路线。候选之间相关性越高,新增计算提供的新信息越少。加入经过不同后训练的 checkpoint,相当于主动改变采样分布,让计算资源进入另一片证明空间。
 NVIDIA 的实验里也能看到这种现象:继续增加同一个 RL 模型的采样,收益很快放缓;把 SFT 专家加入进来以后,即使生成预算接近,能够覆盖的问题明显增加。
所以这里的后训练并不只是在提高单个模型的数学能力。SFT 让证明可以被继续修改,RL 改变高价值路线出现的频率,多 checkpoint 再降低候选之间的相关性。几部分合在一起,解决的是有限推理算力怎样覆盖更多证明路线的问题。
这也是后面 384 次初始生成能够发挥作用的前提。候选如果高度重复,再大的搜索池也很难带来对应规模的新路线。
 02
384 次生成之后,搜索才真正开始
Nemotron 首轮会为每道题生成 384 份证明,但这 384 份答案本身并不是系统的核心。系统没有把首轮生成当成终点,而是把这些证明放进一个持续更新的搜索池。
每份证明经过验证以后,会出现三种情况:直接通过;整体方向可用,但存在需要修补的问题;或者路线价值已经较低。系统不会简单把后两类全部删除,而是把评分较高的证明留下,再把验证器指出的问题送回模型继续修改。
这一步改变了整个推理过程的性质。普通的多次采样是在不断从起点重新出发,每次生成彼此之间几乎没有记忆。
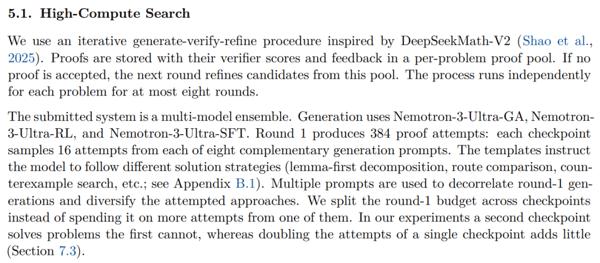 Nemotron 的 proof pool 则把历史计算保留下来,一条路线走到什么位置、哪里出了问题、哪些部分仍然可用,都会成为下一轮搜索的输入。
验证器给出的批改信息,在这里承担了一种方向信号。自然语言证明没有连续可微的目标函数,系统无法像训练神经网络那样直接算出下一步该往哪个方向移动。批改意见起到了近似作用:它告诉模型当前证明与可接受答案之间还差在哪里,refinement 再围绕这个局部区域继续寻找。
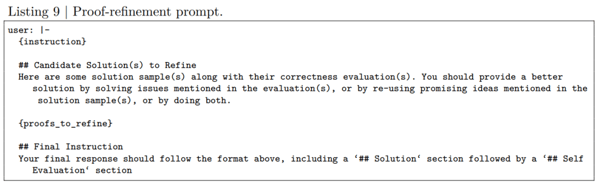 因此,多轮改写不是简单把同一篇答案反复润色。每轮都会重新产生多个候选,这些候选再次进入全局证明池,与之前的路线一起竞争。某条证明如果持续获得较高评价,计算资源会继续沿着这条路径投入;如果修改几轮以后仍然无法解决关键漏洞,它就会逐渐失去继续扩展的机会。
这样一来,整套系统同时具备了搜索宽度和搜索深度。首轮数百份证明负责铺开搜索空间,后面的多轮 refinement 则让接近正确的路线可以继续向前推进,而不用每次重新开始。
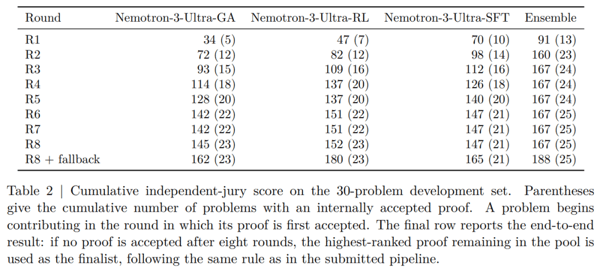 这也是 Nemotron 和简单暴力采样差别较大的地方。暴力采样依赖的是从固定分布里不断抽取新样本;这里则会根据已经出现的候选质量,动态决定下一批计算继续投入到哪些路线。
但这种搜索也有一个天然限制:它没有像围棋那样明确的规则系统。围棋搜索时,一个动作是否合法可以直接判断,终局输赢也有确定答案。自然语言数学证明没有这种低成本判定。
一个证明前面几十步可能全部成立,只在最后用了一个并不存在的对称性;也可能某一步写得比较跳跃,但整体数学思路仍然成立。于是 verifier 在 Nemotron 里不只是负责给答案打分,它还会直接影响计算资源的流向。
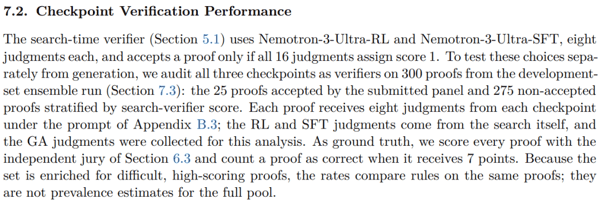 它认为某条路线值得保留,这条路线才会继续获得修改机会;它认为某份证明已经成立,搜索可能就会提前停止。验证误差到了这里,已经不只是评分偏差,还会进一步影响后续搜索路径。
搜索规模越大,verifier 对整体结果的影响也就越明显。
03
16/16 全票通过,仍然挡不住共享错误
NVIDIA 为了降低错误证明被放行的概率,把接受门槛设得很高:两个专家反复检查同一份证明,只有所有判断全部通过,候选才会被接受。
这个设计与搜索系统里的成本结构有关。正确证明被误判,损失主要是算力,因为系统还可以继续修改;错误证明一旦被接受,影响更大,它可能让搜索提前停在错误答案上。所以系统选择接受较高的误拒率,换取更低的错误接受率。
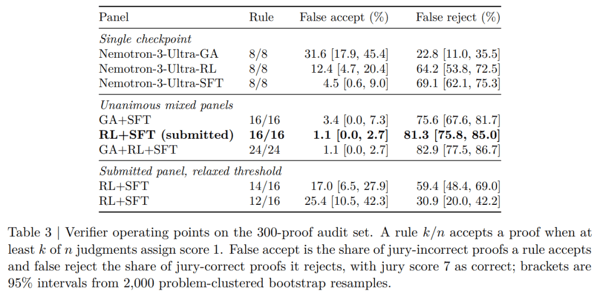 从实验结果看,提高门槛的确能够明显减少错误证明通过,但代价是大量正确证明也会被挡在外面。 如果问题只在门槛高低,主要就是在计算成本和错误率之间调节平衡。Nemotron 暴露出的另一层困难,是这些验证判断并不独立。
SFT、RL 和通用版虽然经过不同后训练,却共享同一个 Nemotron 3 Ultra 底座。它们拥有大量相似的知识结构、概念表示和推理习惯。当错误来自随机疏忽时,多次检查可以降低风险;当错误来自几个模型共同拥有的理解盲区时,增加检查次数的效果就会明显减弱。
论文里那份列置换对称性的错误证明就是一个典型例子。证明本身存在可以明确构造出来的反例,但三个 checkpoint 反复判断,没有一个识别出关键漏洞。
这里的问题并不是模型检查得不够多,而是模型之间的错误高度相关。如果几个裁判来自差异较大的体系,一个裁判的盲区可能被另一个补上;如果它们共享大量训练和表示结构,几个裁判就可能同时接受同一个错误前提。票数增加以后,内部共识会变得更稳定,但这种稳定并不会自动转化成更高的数学可信度。
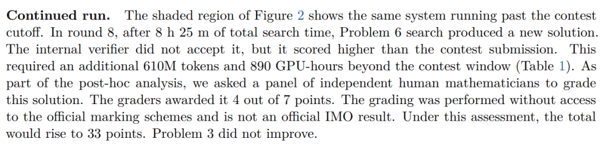
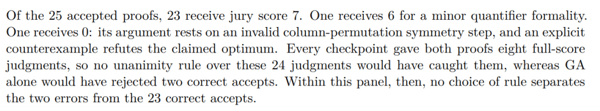 第 6 题的情况又从另一边说明了这个问题。系统继续投入大量计算以后得到一份新证明,内部验证仍然没有放行,但人工复核认为其中包含相当部分正确内容,可以拿到部分分数。
这意味着 verifier 同时存在两类偏差:一类错误证明会因为共享盲区被高置信度放过,另一类有价值证明又会因为门槛过于保守被压下去。
因此,这条技术路线后面面对的并不只是训练一个更强的数学裁判,而是怎样让不同验证组件拥有尽量不同的错误来源。
 不同基础模型可以负责交叉检查,专门的反例生成器可以主动寻找能够推翻关键步骤的构造,符号系统可以处理适合机械核验的代数关系,部分局部命题也可以转交形式化证明器。它们组合在一起的意义,是减少多个验证组件在同一个位置同时失效的概率。
到了这里,生成和验证也呈现出不同的扩展方式。生成端可以依靠更多模型、更大的搜索池和更深的修改链扩大覆盖范围;验证端面对的则是错误相关性。继续增加同一类模型的检查次数,收益会更快进入平台期。
04
开源的「阳谋」:AI时代的「推恩令」
两个专家 checkpoint、SFT 与 RL 数据、推理代码、RL recipe、提交证明和 200 道 Nemotron-IMO-Bench 放出来之后,30 / 42 可以被还原成一组具体的系统变量。
外部团队可以改变 checkpoint 组合、sampling budget、verifier threshold 和 refinement 深度,再看成绩如何变化。但这和完整重跑 30 分仍是两回事。
550B 级模型、TB 级显存以及数千个 GB200 GPU 小时依然构成很高的硬件门槛;Nemotron 3 Ultra 通用版自身的完整后训练链也没有做到逐阶段复刻,NVIDIA 官方文档明确写明,部分中间 teacher 和 MOPD checkpoint 尚未开放。
但 IMO 这条链已经把问题暴露得很清楚:证明生成可以依靠更多 proposal 和更多 test-time compute 继续扩展,验证却还没有同样稳定的 scaling 路线。
下一步真正难处理的,是怎样让 verifier 的错误不再与 generator 高度重合。
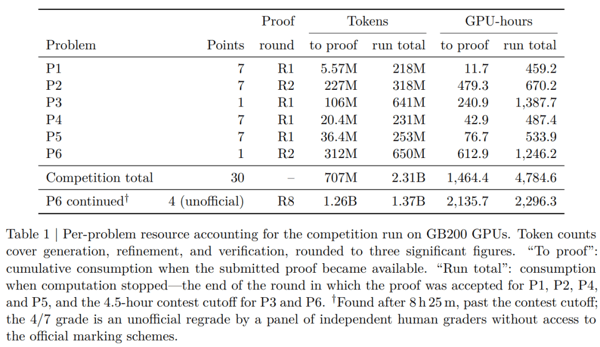
通过对这一事件的拆解,我们不难看出,即便配方全开,8 张 B200 显卡与 1,464 小时的长考成本,依然是一道将全球 99% 的高校实验室拒之门外的硬墙。
这种“只能看、买不起”的尴尬现状,正是未来 AI4S 竞赛的预演:代码平权已经实现,但算力主权仍被少数巨头垄断。
英伟达的这套打法揭示了未来科学发现的一种协作新范式:过去,数学家是“单打独斗”的独奏者。而在暴力推理时代,AI 巨头则烧掉数百万美金的电费,把那些枯燥、重复、海量的逻辑可能性全部铲平。
这并不意味着数学家的消亡,而是意味着数学家角色的位移:从“寻找证据的人”变成了“审判逻辑的人”。
NVIDIA 这份报告对基础研究最大的尊重,不在于那 30 分的成绩,而在于它在向学术界传递一个信号:算力可以完成最脏最累的体力活,但关于真理的最终裁决、关于验证逻辑的一致性,我必须仰仗人类的直觉——这或许就是暴力算力时代,大厂给基础研究最体面的回信。
回到开头那个比喻。推恩令之所以高明,是因为它用利益的共享消解了对抗的意志。今天,英伟达通过开源让全球实验室都能分享 IMO 金牌的红利,却也让所有人都在无意间进入了由英伟达硬件定义的搜索推理范式。
当你拿着这份图纸试图复现成功时,你会发现, 你唯一能做的就是去购买更多的英伟达显卡 。
参考链接:
https://arxiv.org/pdf/2609.10712
https://mathandai.org/
主题:系统|Nemotron3Ultra