
当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
现有视频世界模型可以生成视觉效果出色的短片。但随着生成过程不断延长,早期画面会逐渐离开模型有限的时间上下文。模型可能 “忘记” 已经见过的空间:沙发换了材质,门窗悄然移动,甚至房间的几何结构也发生变化。
一种直接的解决办法,是把过去观察到的内容全部保存下来。然而,无论保存的是 RGB 图像、三维点,还是扩散模型的潜特征,记忆都会随着视频长度持续增长。模型走得越远,需要保存和处理的历史就越多。
来自哈佛大学、麻省理工学院、新加坡国立大学与 MIT IBM Watson AI Lab 的研究团队提出 Honeycomb,试图回答一个更根本的问题:视频世界模型能否在持续吸收新场景信息的同时,让特征记忆始终保持固定大小?
Honeycomb 的答案是 HexMemory。它将场景压缩到六张固定尺寸的二维特征平面中,并通过 “读取、生成、写回” 的循环不断更新同一块记忆。无论视频生成多长,HexMemory 的特征存储量都不会随帧数继续增加。
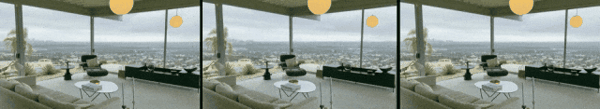 图 1:闭环重访动态对比。从左到右依次为 Honeycomb、Spatia 与 LSM World。相机离开并返回起点后,Honeycomb 更好地保持了房间结构和物体外观。来源:Honeycomb 项目主页。
 论文标题与作者信息。Jack Wei Lun Shi 与 Kaichen Zhou 为共同第一作者。来源:论文首页。 论文标题:Honeycomb: Constant-Size Scene Memory Representation for Video World Models
作者:Jack Wei Lun Shi (Co-first)、Kaichen Zhou (Co-first)、Haoyu Chen、Yufeng Weng、Keane Ong、Ruojin Cai、Hang Hua、Justin K.W. Yeoh、Mengyu Wang
论文: https://arxiv.org/abs/2609.37690
项目主页:jackswl.github.io/honeycomb
代码:github.com/kaichen-z/honeycomb
为什么长视频需要一块不会膨胀的记忆?
视频生成模型通常只能直接处理有限长度的上下文。对于短镜头,最近几帧已经提供了足够的信息;但在长时间、开放式的场景探索中,局部上下文无法回答一个重要问题:镜头很久以前见过的地方是什么样子?
现有方法大致采用两类空间记忆。Spatia 把观察到的 RGB 内容反投影到三维空间,持续建立彩色点云;LSM World 则把扩散模型潜特征与三维点关联,形成潜特征缓存。这些方法允许模型检索历史场景,却也有一个共同特点:新的观察会产生新的点或特征,记忆规模随生成过程持续增长。
如果视频只有几秒,这种增长或许可以接受。但对于需要长期探索的世界模型、交互式环境或具身智能系统,持续扩张的记忆最终会成为存储与计算负担。Honeycomb 因此不再逐条追加历史,而是把新旧观察反复压缩进一组固定结构。
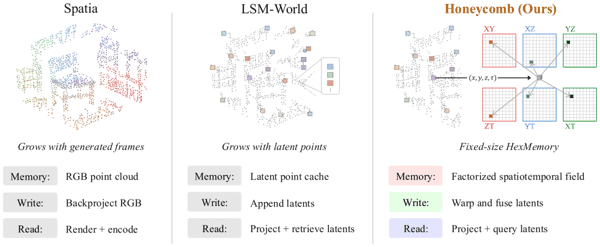 图 2:三种空间记忆设计。Spatia 累积 RGB 点云,LSM World 累积潜特征点;Honeycomb 将场景写入固定尺寸的时空特征场。来源:Honeycomb 项目主页,对应论文 Figure 2。
核心设计:用六张平面记住一个不断扩展的世界
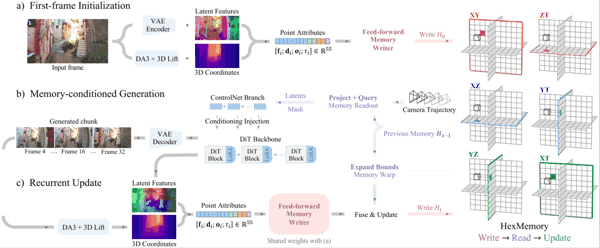 图 3:Honeycomb 整体框架。系统从首帧初始化 HexMemory,读取记忆以生成下一段视频,再将新观察写回同一组固定尺寸的平面。来源:Honeycomb 项目主页,对应论文 Figure 3。
Honeycomb 维护一块由六张固定尺寸特征平面组成的 HexMemory。系统先用输入首帧初始化记忆;每生成一个新的视频片段,就从记忆中读取条件,再把片段中的新观察写回原有张量。与持续追加潜特征点不同,Honeycomb 始终在同一组平面上更新。
1. HexMemory:三张空间平面,三张时空平面
HexMemory 使用 XY、XZ、YZ 三张空间平面,以及 ZT、YT、XT 三张时空平面。这里的 T 表示内容被写入记忆的时间。六张平面组成三对,每一对都覆盖 X、Y、Z、T 四个坐标轴。
查询某个三维位置在某次写入时刻对应的内容时,系统分别在相关平面上进行双线性采样,再组合这些特征。空间平面保存跨时间共享的场景结构,时空平面帮助表达随时间变化的内容。这相当于对四维场景特征场进行低秩分解,比直接维护完整四维网格或不断增长的点缓存更紧凑。
2. 前馈式写入器:只处理刚刚到来的新观察
系统首先用 VAE 将画面编码为潜特征,再结合深度与相机参数,把潜特征提升到三维世界坐标。每个三维点携带自身位置、潜特征、相机中心与观察射线方向。一个轻量网络为六张平面分别预测特征贡献,并通过双线性权重把信息分配给附近网格。
除了特征,每张平面还维护置信度图,记录不同单元接收了多少有效观察。这些置信度会在后续更新中决定旧信息和新信息各自应占多大权重。