
给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍
视觉编码器是多模态大模型(MLLM)的核心组件之一。即使使用相同的大语言模型(LLM),不同的视觉编码器也可能带来显著不同的下游表现。要找到最合适的视觉编码器,最直接的方法是将候选编码器逐一接入 LLM,完成跨模态对齐训练后进行评测,但这一过程需要大量计算资源。因此,如何在完整训练之前准确预测视觉编码器的下游表现,成为一个重要的研究问题。
现有评测方法主要分为两类:单模态方法主要关注视觉编码器自身的能力,例如图像分类表现;跨模态方法则进一步考虑目标 LLM,通过衡量视觉与语言表征之间的关系,评估不同视觉编码器与 LLM 的适配程度。从直觉上看,跨模态方法考虑了视觉与语言之间的匹配关系,应该能够提供更准确的预测。
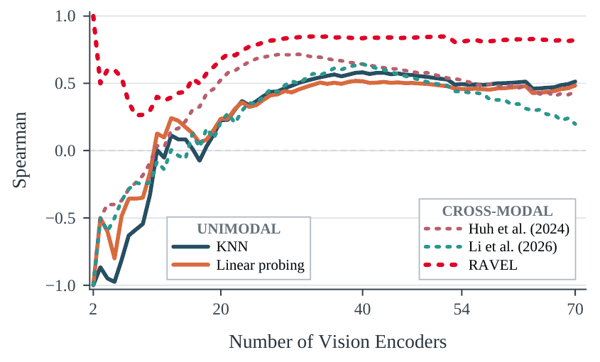 随着候选视觉编码器的多样性增加,传统跨模态评测方法的性能显著下降,甚至不及单模态方法。相比之下,RAVEL 在不同候选池中均保持显著优势,展现出更强的稳定性与可靠性。
然而,研究团队通过训练并评测 210 个多模态大模型发现,现有跨模态方法的优势并不稳定。在规模较小、类型相对有限的候选池中,跨模态方法通常优于单模态方法;但随着候选视觉编码器的数量和多样性增加,跨模态方法的评测性能显著下降,甚至弱于单模态方法。这一发现表明,现有跨模态评测方法在大规模、多样化的视觉编码器筛选任务中仍存在明显局限。
针对这一问题,团队提出了免训练评测方法 RAVEL。RAVEL 保留了跨模态评测的基本思路,并引入两个简单的技术改进:Stablized PCA Whitening(带稳定项的 PCA 白化),减少特征空间中主导方向的干扰;以及 Patch-level Similarity Scoring(基于图像块匹配的相似度计算),利用图像局部特征,更充分地捕捉视觉表征中的细节信息。这两个改进有效提升了跨模态评测的准确性与稳定性,使 RAVEL 在不同规模和多样性的候选池中均能保持较好的表现。
实验结果表明, 在三个不同的 LLM 上,RAVEL 的评估分数与实际下游表现的相关性显著高于之前的工作:无需额外训练,RAVEL 平均 Spearman 相关系数高达 0.85 ,不仅超越需要训练的 Alignment Probing 方法( +36.1% ),更大幅领先此前的免训练方法 GW( +93.5% )和 MutualNN( +101.1% )。
RAVEL 表明,无需额外训练,仅通过更合理地利用已有的视觉与语言表征,就能显著提升视觉编码器的评测准确性,为多模态大模型的组件选择提供了一种高效、可靠的新方法。