
答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」
让智能体分析一起法律案件,它可能检索法规、整理事实、列出理由,最后给出一个看起来完全正确的答案。
问题可能出在更早的一步:它引用了错误法源,算错了程序期限,或者误解了工具返回的内容。后面的推理越流畅,这个错误反而越容易被最终答案遮住。
如今,法律大模型正在从单轮问答走向智能体。系统不再只是生成一段文字,而是会规划任务、调用检索工具、读取材料,并依据中间结果继续行动。人们把更多步骤交给模型,也就更难逐项确认它究竟看到了什么、为什么作出当前判断。
一次幻觉,开始有了跨步骤的后果。
香港科技大学的研究团队将目光放在了这条执行链上。他们提出智能体幻觉评测基准 Lex Agent Hallu ,把观察对象从最终答案扩展到完整轨迹,并将错误定位到具体步骤。
这项工作的出发点很直接:当一个智能体说“依据已经找到”“规则适用于当前事实”时,评测不能只看结论对不对, 还要检查支撑结 论的理由 是否真实、准确并且前后一致 。
 论文标题:LexAgentHallu: A Hierarchical Benchmark for Profiling Hallucinations in Legal Agents
机构:香港科技大学
论文地址:https://arxiv.org/abs/2609.09754
一个错误法源
可以带偏整条法律推理
过去评测法律大模型,最常见的做法是给出一道题,再检查最终答案是否正确。到了智能体场景,同一个错误还要继续往下追,看看它影响了哪些检索、引用和判断。
把一条法规的名称写错,可能只留下一个文本错误。把已经失效的规定当成现行法,或者把下位规范当成上位法,却可能改变后续的规则选择、事实适用和救济建议。
智能体的风险因此不只来自“编造”。它也可能找到真实材料,却把材料用错;调用了正确工具,却填写了错误参数;看到了相关结果,却误读了结果所支持的范围。
一次幻觉,不再只是错误文本,而可能成为下一步法律判断的前提。
LexAgentHallu 因此不把最终答案视为唯一评测对象。它沿着智能体的执行轨迹逐步检查:系统如何规划、调用了什么工具、读到了什么结果、保留了哪些信息,以及怎样把事实与规则连接起 来 。
智能体的幻觉
究竟藏在哪里
LexAgentHallu 建立了一套 双层分类 体系。
第一层关注法律内容本身 ,包括法源、法律原则、程序规则和事实适用等错误。 第二层关注智能体执行过程 ,包括规划与推理、记忆,以及工具调用与观察结果理解等错误。两层合计包含 7 个中层类别和 27 个细粒度子类。
这套分类的目的不是给错误换一组名称,而是让问题能够被定位。法源伪造需要核验引用,事实—规则错配需要重新检查要件,工具参数错误需要约束调用接口,记忆偏移则指向上下文管理。
基准的构建也围绕“ 难例 ”和“ 可核验 ”展开。研究团队从多类法律任务中收集数据,过滤容易样本,再由具备法律训练背景的标注者核对答案、法源和推理轨迹,最后完成幻觉分类与专家复核。
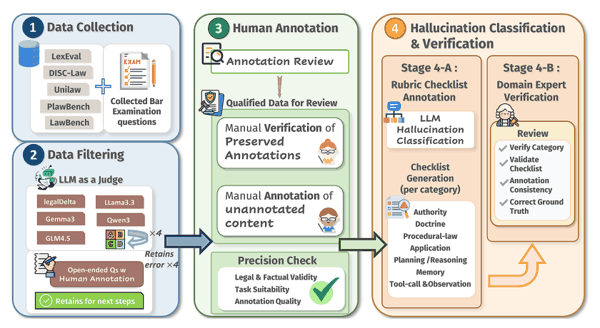 图 1|LexAgentHallu 的四阶段构建流程。来源:原论文 Figure 1,第 4 页。 最终, LexAgentHallu 收录 3414 个实例,覆盖 17 个法律类别和 6 类任务 。它不只回答“系统错了多少”,还试图说明错误发生在哪里、属于哪一类,以及是否可能继续污染后续步骤。
最好的配置
也有 89% 的轨迹出现幻觉
论文评测了 18 种闭源和开源智能体配置 。结果显示,高幻觉率并不是个别系统的边缘现象。
即使表现最好的配置,仍有 89% 的执行轨迹至少出现一次幻觉 。 所有系统在法律内容层面的幻觉频率都不低于 87.5%。
这组结果并不等于“所有法律回答都有同样风险”。它说明的是,在这套强调困难样本和完整执行轨迹的评测中,当前系统很难从头到尾保持一条干净、可核验的推理链。
模型、工具和编排方式还会共同改变错误分布。ReAct 式的行动—观察循环在整体幻觉和法律内容幻觉上更有优势;法律专用工作流更能压低过程性错误;预先规划再执行的方式,在本实验中没有表现出稳定领先。
因此,部署智能体时,不能把模型、工具和流程拆开评估。更强的基础模型,仍可能在不合适的检索流程里放大错误;较小的模型,也可能通过更明确的工具协议和过程约束获得更稳定的表现。
答案已经正确
为什么理由仍然不可信
论文提出了一个很直观的指标: RAWR ,即 Right-Answer-Wrong-Reason 。它只观察最终答案正确的样本,再检查这些样本的执行轨迹中是否仍然存在幻觉。
结果显示, 在答案正确的前提下,平均仍有 68% 的轨迹包含至少一种法律内容幻觉,37% 的轨迹包含至少一种智能体过程幻觉。
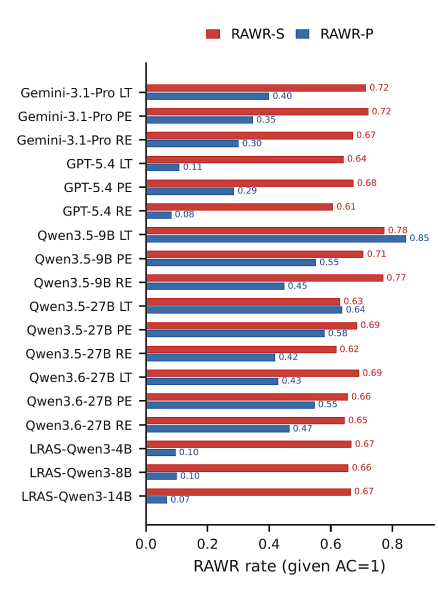 图 2|RAWR 衡量“答对但理由错”的比例。红色为法律内容错误,蓝色为智能体过程错误。来源:原论文 Figure 4,第 7 页。
正确答案只能说明结论命中,不能证明推理链是干净的。
对法律咨询、合同审查和诉讼辅助等应用来说,这一区别尤其关键。用户需要的不只是一个看起来正确的句子,还需要能够追溯、核验并经得起反问的理由链。
如果系统只在输出端给出结论,却不暴露引用、推理和工具调用的质量,错误就可能在“答案正确”的表象下继续留存。
哪些任务更容易出问题
不同任务的幻觉频率并不均匀。开放式、长链条、需要综合事实与规则的任务,更容易暴露法律内容和过程错误。
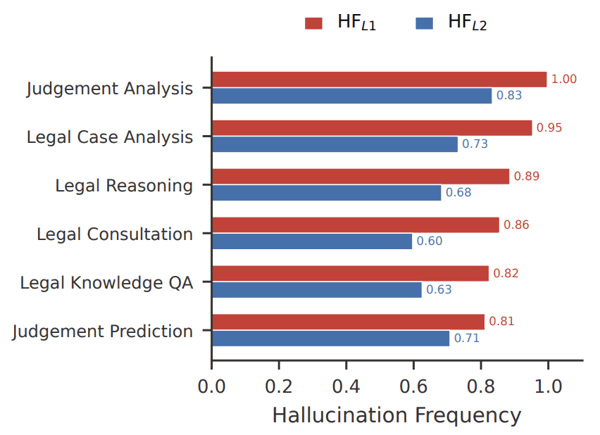 图 3|不同任务类型下的幻觉频率。判决分析、案例分析等开放式任务处于高位。来源:原论文 Figure 5,第 8 页。 在任务类型上,判决分析的法律内容幻觉频率达到 1.00,案例分析为 0.95;法律推理、法律咨询、法律知识问答和判决预测也都处于高位。
过程性幻觉呈现出不同排序。判决分析达到 0.83,判决预测为 0.71。较短输出并不必然安全:只要任务要求多步证据整合、期限判断或规则适用,规划和记忆仍可能成为风险点。
真正决定风险的,不只是题目看起来有多难,而是系统需要完成多长的“事实—规则—程序—结论”映射。任何一个环节发生偏移,后面的步骤都可能在错误前提上继续推进。
幻觉会不会沿着链条一起发生
论文还分析了 27 个细粒度幻觉子类之间的共现关系。结果显示,这些错误并不是随机散点,而会形成具有结构的组合。
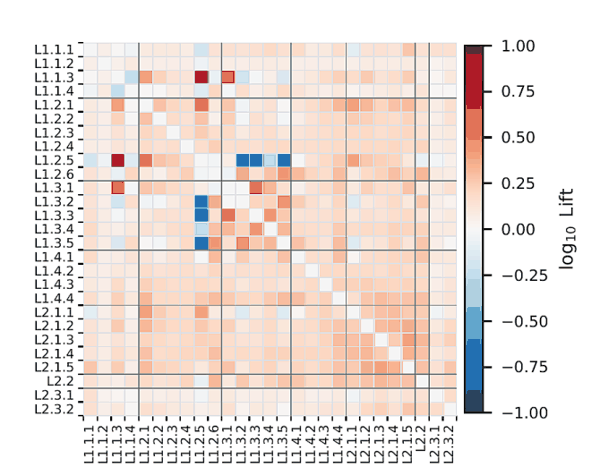 图 4|27×27 幻觉子类共现矩阵。红色表示正向共现,蓝色表示负向共现。来源:原论文 Figure 6,第 8 页。 程序期限错误与救济路径错误的共现提升度达到 2.82,程序步骤错误与程序后果错误达到 2.59。最强的跨组信号出现在法源层级错误与法律立场混淆之间,提升度达到 7.07。
这意味着,很多看似分散的错误可能共享同一个上游原因。法源层级一旦判断错误,后续的规则立场和事实适用就可能一起偏移;程序时钟一旦算错,期限、步骤和救济路径也可能连续出问题。
对系统治理来说,高风险错误可以被视为早期信号。一旦检测到法源层级、期限计算、程序步骤或事实要件映射异常,系统就应触发二次检索、规则校验或人工复核,而不是等到最终答案生成后再被动纠错。
从评测基准
怎样走向产品防线
LexAgentHallu 的直接价值,是把“幻觉很多”拆成可以处理的故障类型。把这套思路落到产品中,智能体至少需要三道检查。
生成前,明确边界 。系统需要确认适用法域、任务范围和可回答程度。在管辖权、时效或程序路径不清楚时,不应直接给出确定判断。
执行中,验证依据 。检索结果、引用来源、关键事实和工具返回值需要持续核对。一个中间结果不能只因为“看起来合理”就被带入下一步。
输出前,检查一致性 。结论与理由应当相互支撑,尤其要核对法源效力、程序期限、构成要件和救济路径。最终答案正确,也不能替代这一步检查。
更进一步,评测对象应当从单一模型扩展为“ 模型—工具—工作流 ”整体。系统如何检索、何时反思、怎样保留中间状态、在什么条件下停止,都是可靠性的一部分。
论文也提醒我们谨慎外推。LexAgentHallu 主要基于中国法律体系,并集中于单智能体场景。迁移到普通法、多法域检索或多智能体协作时,法源权威性、先例适用和程序规则都需要重新定义。
写在最后
LexAgentHallu 为智能体增加了一种更接近真实部署的评测方式: 不仅看最后答了什么,还要追踪答案是怎样形成的。
我们把法律任务交给智能体,是希望它能够稳定处理检索、事实整理和规则适用,而不是让用户在事后逐条排查一条看似顺畅的推理链。一个引用、一项期限判断、一次工具调用,都需要在进入下一步之前经得起核对。
“答对了,理由却错了”不只是一个评测现象。它提醒我们,智能体的可信度不能由最终答案单独证明。 真正可靠的系统,需要让错误更早暴露,也让错误更难沿着执行链继续传播。
作者简介
论文共同第一作者周钰锦、郑明轩、曹楚雪均为香港科技大学跨学科学院人工智能在读博士生,师从韩斯睿教授与郭毅可教授,研究方向涵盖法律人工智能、大模型安全对齐、与智能体等,成果发表于 ICML、EMNLP、ACL 等国际顶级会议。韩斯睿为香港科技大学助理教授、主要从事人工智能、法律科技与法律金融交叉研究。郭毅可教授为国际知名的计算机科学家、香港科技大学计算机科学及工程学系讲座教授、中国工程院外籍院士。