
SK海力士发布第二代CMM-DDR 5:256 GB、CXL 3.2,并把内存池化搬进MARS机架
SK 海力士在 10 月 12 日至 15 日于美国圣何塞举行的 OCP Global Summit 2026 上,围绕 CXL 接口展示了三套面向下一代服务器的内存方案,并于会后公布技术资料。核心是第二代 CMM-DDR5 内存模块:容量 256GB,基于 CXL 3.2 标准。按公司公布的数据,带宽达 80GB/s,较前代提升一倍以上,能效提升约 30%,并加入 CXL Pooled 池化功能。
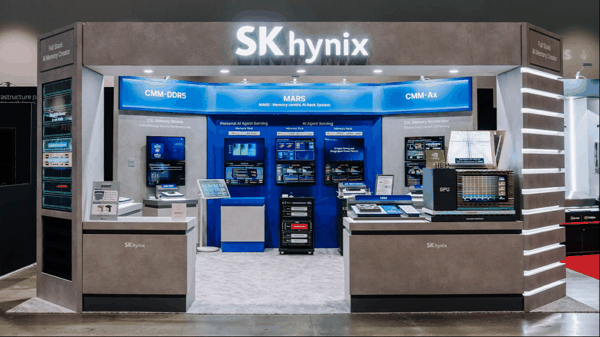 SK 海力士在 OCP Global Summit 2026 展出的 CMM-DDR5 、 MARS 与 CMM-Ax 方案 图片来源: SK hynix
CMM-DDR5 的用法是把多台服务器可共享的内存池按需切分,而不是每台服务器各自配满内存。SK 海力士与 NAVER Cloud 合作,在真实的 AI 服务环境里做了概念验证:一套面向智能体(agentic AI)的 KV cache 共享方案,以及在全模态服务 OmniServe 中的 embedding 共享方案。模型推理过程中,KV cache 会随着对话轮数与任务数量迅速膨胀,把它放进可共享的内存池,相当于让多台服务器共用同一份中间计算结果。
展台上另两项方案指向机架与内存内计算。MARS(Memory Centric AI Rack System)以内存为核心,把伙伴方案集成到一个机架内,实现机架级 内存池化 和 CPU 与 GPU 之间动态 零拷贝 数据共享,现场与 AMD、Marvell 等伙伴联合演示。CMM-Ax 把计算放进内存内部,减少数据在 CPU、GPU 与内存之间来回搬运的开销。同场展出的还有 HBM4 与 HBM4 E、HBF,以及 NVIDIA Vera Rubin 超芯片模型。
SK 海力士内存系统研究负责人金浩植在演讲中把现有 CPU 与 GPU 中心架构遇到的问题归结为「 内存墙 」与功耗上升,并给出以内存为中心的机架系统作为回应。
CXL 池化改变的是内存资源的分配方式:不再按峰值给每台服务器配内存,而是把容量集中起来、按负载动态分配。对机架设计来说,难点随之从单条内存的带宽转向池化后的访问延迟、拓扑规模,以及软件栈对池化内存的调度支持——KV cache 共享这类场景能不能稳定跑在真实业务上,取决于延迟抖动是否落在推理服务可接受的范围里。CMM-Ax 走的是另一条路,把一部分计算留在内存侧,减少搬运本身;两条路线并不互斥,但在机架里争的是同一样东西:带宽与功耗预算。
主题:SK海力士