
七校联合开源OpenWAM:机器人的「世界模拟器」来了
本文中,来自新加坡国立大学、清华大学、北京大学等七所高校的研究团队,最新开源 OpenWAM,面向世界动作模型的开源研究全栈与基座模型。
ArXiv:https://arxiv.org/abs/2609.07398
项目主页:https://openwam-official.github.io/
代码:https://github.com/OpenWAM-Official/OpenWAM
模型与数据:https://huggingface.co/OpenWAM
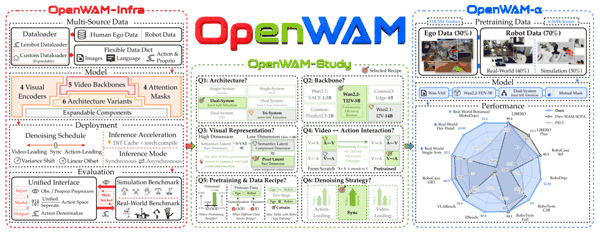 图 1 OpenWAM 总览:OpenWAM-Infra 提供模块化基础设施,OpenWAM-Study 提炼设计规律,OpenWAM-α 在大规模人类第一视角与机器人数据上验证方案。
当机器人需要完成一个动作时,仅仅识别眼前的物体还不够。它还要预测环境将如何变化,并判断哪些动作能够让变化发生。视频生成模型擅长学习世界如何随时间演化,机器人轨迹则提供可执行的动作监督。
OpenWAM 的核心思路,是把这两类能力放进同一个世界动作模型中,让模型一边理解可能发生的未来,一边学习如何改变未来。
论文标题为《OpenWAM: An Open, Modular Exploration Towards Systematic World–Action Model Pretraining》。研究团队将问题拆成三个层次:什么知识值得继承,世界建模和动作学习如何协同,以及这种协同如何跨数据域和具身形态扩展。全文的答案分别由 OpenWAM-Infra、OpenWAM-Study 和 OpenWAM-α 给出。
核心结论 :OpenWAM 通过模块化基础设施把世界动作模型从紧耦合的单一实现,转化为可控、可复现的实验体系;研究结果表明,充足的生成式世界先验、紧凑且信息丰富的视觉表征、明确的世界到动作信息流,以及跨域具身预训练,是构建高性能 WAM 的关键。
为什么需要世界动作模型
现有机器人策略通常直接从机器人示范中同时学习视觉规律和控制信号。视觉语言动作模型则更多继承图像文本预训练带来的语义和语言知识。世界动作模型选择了另一条路径:从视频生成预训练中继承视觉动态先验,再通过具身经验学习在这个世界中采取行动。
这种路线面临一个现实的数据不对称。描述世界变化的视频很多,带有精确可执行动作标签的机器人轨迹却相对稀缺。世界建模可以补充视觉覆盖和动态知识,动作学习可以把这些知识锚定到控制目标,但二者能否真正形成协同,取决于模型结构、信息流、推理方式和数据配方的共同设计。
论文将问题归纳为三个研究问题:WAM 应该继承什么世界知识;继承的知识如何与动作学习建立有效协同;这种协同如何在不同领域、不同机器人形态之间迁移。
OpenWAM Infra 把研究变量拆开
OpenWAM-Infra 针对现有系统难以扩展、不同模块彼此干扰的问题,定义了四个有明确接口的部分:可组合模型、训练运行时、部署运行时和评测协议。模型由视觉编码器、不同的数据流骨干网络以及可见性注意力掩码组合而成;训练、部署和评测则使用统一的运行方式。这样,研究者可以只替换一个设计变量,观察它对结果的影响。
主题:数据