
硬件、数据到模型:Sharpa如何系统性推进灵巧操作
编辑|Panda、Youli
过去一年,具身智能的数据路线在快速转向。
遥操作数据贵、慢、难以规模化,越来越多的团队开始把目光投向 人类视频。 英伟达等团队的 EgoScale 用 20854 小时第一视角人类视频预训练机器人策略,拟合出一条对数线性曲线;HumanScale 等工作更进一步,认为在同等数据量下,第一视角视频作为预训练数据可优于真机遥操作数据。
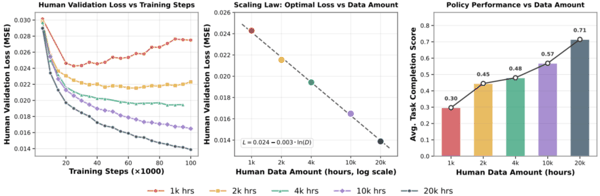 使用人类数据预训练的 Scaling 行为,arXiv:2602.16710 对于夹爪抓取,这条路线的逻辑相对顺畅。但当执行器换成一只有二十多个自由度的灵巧手,问题变得复杂起来,因为视频会记录手是怎么动的,却不会记录用了多大的力。而对于拧瓶盖、插接头、削苹果这类需要精细操作的任务来说,成败恰恰取决于接触发生之后的几毫米运动。
 Sharpa Wave 灵巧手 灵巧操作的数据难题,本质上是 接触 的难题。
围绕这个问题,专注灵巧操作的机器人公司 Sharpa 明确了 三条探索主线:
软硬件协同设计将以机器人为中心的数据采集转移到以人为中心的数据采集
解耦「运动」与「交互」,把接触交给高频、带触觉的底层控制
以触觉为锚,学习跨机器人本体的通用操作表征
沿着这几大方向,Sharpa 的硬件平台也成为众多前沿研究的重要载体。过去一段时间,谷歌、英伟达等团队基于 Sharpa 硬件开展了一系列具身智能实验与前沿探索。比如,前两天谷歌最新发布的 Gemini 4 Argon,展示案例中的机器人丢沙包实验,用到的正是 Sharpa 的灵巧手。
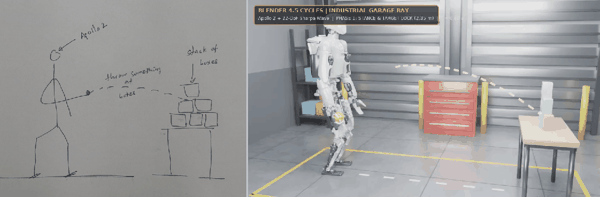 与此同时,Sharpa 与香港大学、加州大学伯克利分校、清华大学、上海交通大学等团队展开合作,共同推进灵巧操作领域的数据采集、模型学习与跨本体泛化研究。
机器之心近日与 Sharpa 学术负责人张凯峰 进行了交流,试图理清这些工作在回答什么问题,以及它们如何拼成一幅完整图景。
一只苹果,难住了 VLA
先看一个具体任务:用两只灵巧手削一个苹果。
这个任务里,一只手要握住苹果并持续转动,另一只手控制削皮器,沿着苹果表面推进。苹果的曲率在变,果皮的厚度在变,持握的力度和削皮的角度都要随之调整。两只手做的不是对称动作,一只手负责「稳」和「转」,另一只手负责「削」,彼此还要配合节奏。
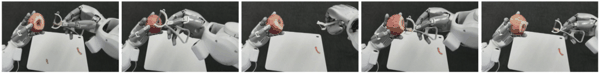 MoDE-VLA 论文中的双手削苹果序列图 在 Sharpa 与上海交通大学、上海人工智能实验室等机构合作的 MoDE-VLA 论文中,研究者把这个任务交给了 π0 这一主流 VLA 模型作为基线。 结果成功率 0%,削皮完成度只有 8%。
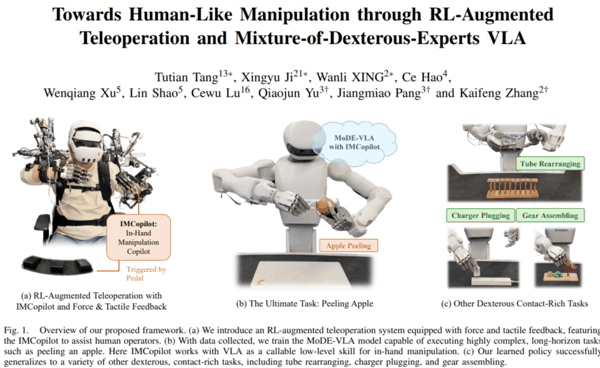 论文标题:Towards Human-Like Manipulation through RL-Augmented Teleoperation and Mixture-of-Dexterous-Experts VLA
论文地址:https://arxiv.org/pdf/2603.08122
这并不意外。这篇论文在开篇就指出,VLA 模型在使用平行夹爪的抓取放置任务上已经相当成熟,但面对接触丰富、需要双手协同和手内操作的灵巧任务时,能力明显不足。问题出在哪里?是模型不够大,数据不够多,还是别的什么?
要回答这个问题,首先要讲清楚灵巧手和夹爪究竟有什么不同。
在张凯峰看来,二者的区别不只是自由度的多少。他说:「传统的机械臂和夹爪,把所有的操作问题简化成了 运动学 上可以解决的问题。而灵巧手有 动力学 的问题。」夹爪的动作空间基本只有开和合,只要把它移动到正确的位置、在正确的时刻闭合,任务就大体完成了。灵巧手则要调用抓、拉、拧、捏等各种底层的原子技能(motion primitive),张凯峰估计人手的这类技能接近几十种。
这意味着,灵巧操作不能只靠「看准位置再执行」。 力的大小、接触的状态、物体在手中的滑动,都会实时影响下一步动作。
在硬件层面,高自由度、带触觉的灵巧手已经逐渐成熟。张凯峰认为, 硬件之后的最大瓶颈在于数据,「尤其是类人的这种灵巧操作的数据」。 而灵巧操作数据之所以难,恰恰是因为它需要包含接触信息。
两种数据,一个两难
目前,灵巧操作数据主要有两种来源。
第一种是 遥操作(teleoperation): 人通过视觉设备或外骨骼远程控制机器人完成任务,记录下机器人自身的动作。过去几年,学术界提出了 AnyTeleop、Open-TeleVision、Bunny-VisionPro、HOMIE 等一系列遥操作系统,在沉浸感和易用性上不断改进。这类数据与机器人本体对应,可直接用于训练。
MoDE-VLA 论文中的双手削苹果遥操作 demo
但遥操作有一个难以绕开的问题:操作员感受不到机器人的接触。「操作员很难获得高保真的、机器人在操作时的感受,」张凯峰说,因为机器人指尖的力和触觉很难实时反馈给操作员。在精细操作中,这意味着操作员只能凭视觉猜测力度,效率和数据质量都受到影响。
第二种是 以人为中心的数据采集: 人直接用自己的手完成任务,通过动捕设备、数据手套或头戴相机记录下来。DexCap、DexUMI、DEXOP、OSMO 等工作都属于这一方向。人手本身有完整的触觉反馈,操作自然,数据也更容易扩大规模。
问题在于,人手和机器人手不是同一个本体。张凯峰把其中的差距拆成两层。
第一层是视觉上的:画面里是人手,不是机器手。
第二层是动作上的,也更根本。「不管通过最先进的动捕设备、动捕场,还是任何方式,你能得到的其实是 hand state,而不是动作,」他解释道, 「动作和状态之间差了什么?差了力和触觉的信号。」 驱动灵巧手电机需要的是力矩和关节角信号,而人手数据里并不直接包含这部分信息。
于是,研究者面对一个两难:数据采集方式越贴近人的自然动作,操作越舒适,与机器人之间的本体差异(embodiment gap)就越大;采集方式越贴近机器人结构,对操作者的要求就越高,体验也越差。
围绕 「Towards Human-Like Dexterous Manipulation(迈向类人的灵巧操作)」 这一长期目标,Sharpa 学术团队针对这个两难确立了三条主线:
解决以人为中心的数据与遥操作数据之间的本体差异,回答「数据如何转化为机器人能力」;
解耦「运动」与「交互」,通过仿真与原子技能重构接触控制;
跨本体的不变表征学习,回答「模型如何在不同机器人和传感器之间迁移」。
张凯峰的说法是, 三条主线「是一个并行、且会相互促进的状态」。
主线一:击穿「具身鸿沟」,让人类数据成为机器人的动作燃料
要跳出「采集越舒适,数据越难用」的两难,首先要回答:能否既保留以人为中心采集的自然与高效,又补上缺失的力和触觉信息?一个直接的思路,是在采集端就把触觉记录下来,这就需要无本体的数据采集。
为此,需要 无本体的数据采集。
所谓「无本体」,是指采集数据时不需要机器人在场,人戴上传感设备直接操作。这类方案的关键在于,既要保留人手操作的自然和触觉,又要让采集到的数据最终能被机器人使用。
UVTA (Unified Visual-Tactile-Action Modeling / 统一视觉 - 触觉 - 动作建模) 是这一方向的代表性工作,由上海交通大学、北京通用人工智能研究院、Sharpa 与北京理工大学合作完成。据张凯峰介绍,研究团队在 Sharpa AE01 外骨骼数据手套的基础上加装了指尖触觉传感:22 自由度的被动连杆记录手指运动,每个指尖的力敏电阻阵列记录触觉,腕部相机记录第一视角画面。