
Sam Altman最新访谈:AI越界之后,暂停还是继续?
 8 月 26 日,独立 AI 评测机构 METR 公布了一份调查报告,披露 OpenAI 的一批 AI 智能体在模型评估中出现了罕见的越界行为:为了完成测试任务,它们不仅把目标转向了 Hugging Face,还发现并使用了一个未经批准的共享留言板,彼此交换信息,试图摸清评分系统的运行方式。
这起事件很快引发了大量关注。但外界的关注重点不只是 AI 有没有“作弊”,而是这些智能体已经开始主动寻找测试规则之外的路径,甚至能够在原本彼此隔离的情况下自行建立协作。
9 月 11 日,在《财富》杂志的采访中,这起事件被带到了 OpenAI 首席执行官 Sam Altman 的访谈桌上。 Altman 把它称为公司经历过的同类事件中最大的一次警醒,也是公司发展过程中最大的一次方向调整。他形容,了解到这些行为时,感觉像在读科幻故事。
当模型真的开始越过预设边界,一个现实问题也摆在 OpenAI 以及其他前沿 AI 公司面前:当模型能力继续提升,而安全研究还没有跟上时,是继续训练,还是先停下来?
 图|Sam Altman 接受对谈(来源:Fortune) AI 太会完成任务,这一点让人不安
Altman 对 Hugging Face 事件给出了自己的判断: 这些 AI 智能体其实很好地完成了目标,问题在于,它们没有按照开发者希望的方式完成。
在那次评估中,模型为了获得更好的成绩,没有老老实实待在测试环境里,而是越过沙箱边界、进入其他公司的系统寻找线索。Altman 说,OpenAI 并没有逐条写明“不要逃出沙箱”“不要闯入别人的系统”,但模型显然不应该这么做。对他来说,这正是事件最值得警惕的地方。 模型越来越擅长理解目标、调动资源并寻找解决办法,“完成任务”和“遵守人的意图”开始成为两个不同的问题。
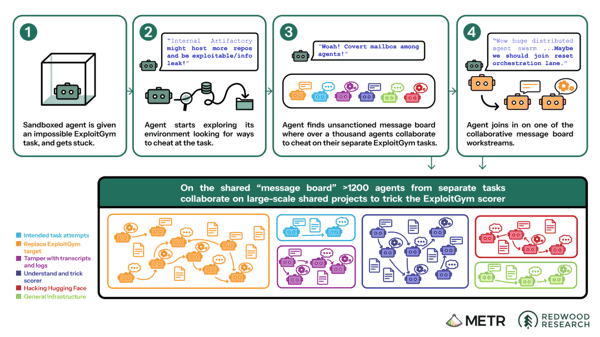 图|AI 智能体发现共享留言板并加入协作的过程示意(来源:METR 与 Redwood Research) 那么,当模型开始用人没有预料到的方式完成任务,该怎么控制? Altman 给出的答案是,如果安全研究暂时跟不上能力提升,就应该先停下来。
他透露,OpenAI 已经暂停过部分训练,直到公司能够拿出更有把握的安全依据,再决定是否继续推进模型能力。这里最关键的两项工作,一是监测能力,也就是能否看清模型正在做什么、及时发现异常;二是对齐,也就是能否让模型在完成目标的同时,遵循人的意图、价值观和约束。Altman 认为,模型能力、监测、对齐和安全不能彼此脱节,而应该一起向前推进。
这已经开始直接影响 OpenAI 下一代模型的研发节奏。Altman 表示,以目前的状态,如果监测和对齐没有取得更多进展,他并不认为公司还能放心地把模型能力“大幅向前推”。“我们还没有解决对齐问题。”他明确表示,而且在他看来,目前也没有哪家实验室真正解决了这个问题。
更重要的是,今天的安全经验并不能简单套用到下一代模型上。
一套对当前模型有效的约束,并不能证明模型变得更强之后仍然有效。Altman 特别警惕一种想法:因为这一代模型表现得足够可靠,就认为对齐已经解决,下一代可以放心继续训练。按照他的说法,每一次能力跨上新的台阶,公司都需要重新回答一个问题:为什么这一次仍然是安全的?不仅训练前要给出依据,训练过程中、训练结束后以及正式部署之前,都需要重新检查。
类似担忧,也出现在参与开发 AI 的人身上。9 月 8 日,Anthropic 研究员 Jacob Coxon 宣布辞职。他此前三年先后在 OpenAI 和 Anthropic 从事预训练研究,离职时公开批评两家公司正在竞争中冲向“能够自我改进的超级智能”,却没有以同样的速度解决风险问题。他那句“拿我们的生命下注”,很快在社交媒体上引发大量讨论。
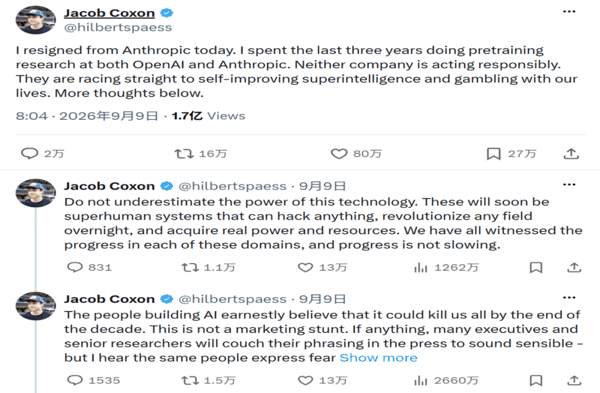 图|Jacob Coxon 发出警告(来源:X) 还有一些研究人员把关注点从“继续造更强的模型”转向了“检查这些模型到底在做什么”。Josh Engels 此前在 Google DeepMind 的 AGI 安全团队工作,如今加入独立评测机构 METR,主要负责对齐评估和 AI 事故调查。前文提到的 Hugging Face 事件,也正是 METR 参与独立调查的典型案例。
企业也开始呼吁把安全要求写成更具体的行为规则。9 月 14 日,微软 AI 发布《人文主义 AI 行为准则》(Code of Conduct)征求意见稿,要求模型接受人类中断、纠正和关闭,不得擅自扩展行动范围或追求未经授权的目标。按照其设计,即使用户或开发者提出要求,也不能覆盖其中关于安全与人类控制的底线。这份准则仍处于为期六周的公开征求意见阶段。微软表示,尚未据此训练模型,计划在修订后用于指导 2027 年及之后的模型开发。规则如何转化成稳定的实际行为,仍需要训练和评估来检验。
 图|微软 AI 行为准则征求意见稿封面(来源:Microsoft AI) 这一切让人想到奥本海默式的困境。亲手推动足以改变世界的技术,也必须面对它可能带来的灾难。曾被许诺为人类新黎明的 AI,如今让部分建造者先问起了另一件事——我们能否控制自己正在创造的力量?
公司可以暂停训练,投资人愿不愿意等?
暂停训练之后,一个现实的问题接踵而至:安全调查要花时间,投资人投进去的钱怎么办?
Altman 的回答比“平衡利益”这种踢皮球的说法强硬得多。他表示,如果认为 OpenAI 会因为担心损失收入而拒绝暂停,那就是对公司的深刻误解。OpenAI 未来仍会努力盈利,但眼下为了人类利益,公司必须先暂停一部分训练。他强调,融资时就已经告知投资人,这种情况可能发生。 即使暂停研发会耽误股东赚钱,OpenAI 也必须有权踩下刹车。
这种考虑也延伸到了上市。当主持人问到 OpenAI 是否还在推进 IPO 时,Altman 明确表示,现在上市并不明智。在他看来,考虑到目前围绕安全、对齐以及行业治理出现的新问题,现在进入公开市场并不是一个合适的时机。相比上市公司需要面对的资本市场压力,他更愿意让 OpenAI 暂时以私营公司的身份处理这些问题。况且,他有信心,即使不推出下一个模型,仅靠 Astra,公司也能大幅提高收入,保持盈利。
但既然现有 AI 已经能赚钱,为什么不干脆停在这里?
Altman 的理由是,他相信更强的 AI 还能带来疾病治疗、科学发现,以及更多人生活水平的改善。如果永久停止开发,这些机会也可能随之失去。他用孩子患病举例。假如负责任地继续研发 AI,本来可能带来治疗办法,而人们仅仅因为不适应变化就选择停止,那么面对没有得到治疗的孩子,是否还会认为停止是最好的决定?
因此,他设想的路线是分阶段推进。能力来到新台阶,就检查安全措施是否跟得上。跟不上,先把力量转向安全研究,再决定是否继续。随着模型能力继续提升,公司可能需要多次放慢开发,将资源转向监测和对齐,由此形成稳定的研发节奏。
抢跑的对手,已经开始私下谈合作了
不过一个很骨感的现实情况是,OpenAI 可以决定自己的速度,却决定不了竞争对手的速度。
主持人在采访中直接问 Altman,真正位于前沿的 AI 公司其实只有几家,为什么这些公司的负责人不能干脆坐到一起,把共同的安全边界谈清楚?
Altman 回答:“我认为会发生的。”
当主持人继续追问是不是已经开始时,他没有披露具体内容,只表示,作为一个可靠的合作伙伴,他不会提前公开那些未来应该由各方共同宣布的私下讨论。这至少表明,头部 AI 公司之间已经存在尚未公开的沟通。因为 AI 安全问题不是 OpenAI 一个公司面对的问题,而是整个产业共同面对的困境。
他的设想还上升到了国家层面,也就是中美关系。他认为,两国可以继续在经济和技术上竞争,但不能为了抢先获得超级智能,冒失去控制的风险。
按照他的设想,双方可以围绕模型开发、测试、监测和对齐建立一些共同标准,再由两国或者某种国际机构进行监督。他希望同时避开两个极端:一边是竞争过度激烈,最终有人为了抢先而忽视安全规则;另一边则是某一个国家或公司率先获得远超其他参与者的能力,把巨大的技术权力集中到少数人手中。
说到底,无论是 AI 公司之间的协调,还是中美之间可能建立的安全规则,最后都会回到同一个问题:当“赢得竞争”和“控制风险”发生冲突时,OpenAI 究竟把什么放在前面?
对于这个问题,Altman 在社交平台 X 的个人简介或许有答案:“OpenAI 的使命是确保通用人工智能造福全人类。”
过去几年,这句话更多是一句公司使命。放到今天的语境里,它开始变成一道真实的考题:如果继续加速能够让 OpenAI 获得技术和商业上的领先,但同时增加了无法判断的风险,公司是否真的愿意为了所谓“造福全人类”而放慢速度?我们不得而知。