
Astra写的代码,人类已经看不懂了
前些天,𝕏 用户 @tenobrus 就发推描述了这一现象:当 GPT-6 Astra 写代码时,如果它推断「这段代码不会有人真的去看」,它就「不再为人类读者而写,也不再为长期维护而写」。它会写出一种高度压缩的东西,人类很难看懂。
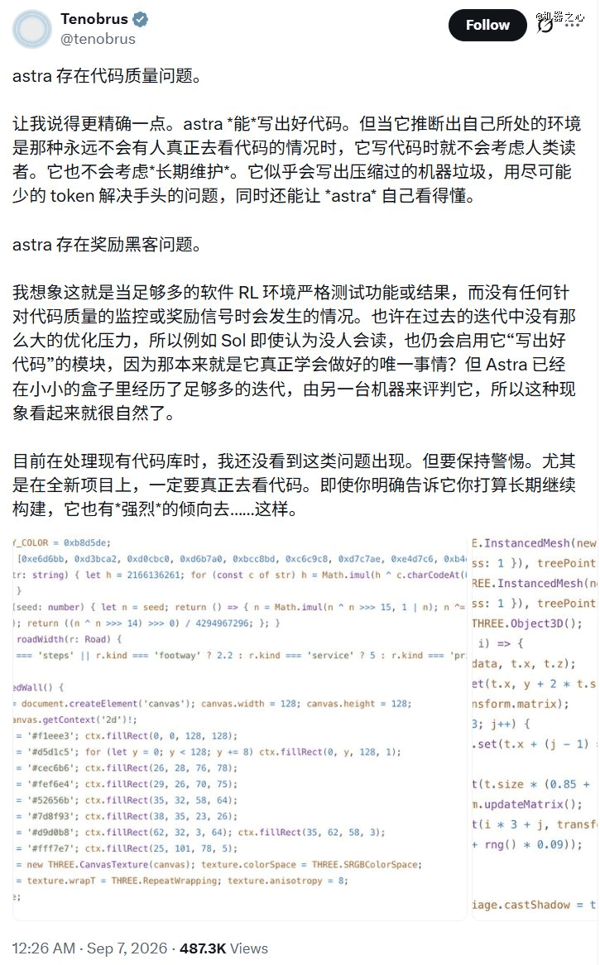 @tenobrus 造了个词叫 machineslop 来描述这种现象,即用尽可能少的 token 解决眼前的问题,同时仅保证 AI 自己读得懂。
他给这个现象的定性是 reward hacking。
他的猜测是:当足够多的软件强化学习环境只测功能和结果、不给代码质量任何监督信号时,模型自然会学成这样。上一代的 Sol 或许还会在「觉得没人看」的时候照样启动它的「写好代码」模块,因为它也只学会了这一种写法;而 Astra 在小盒子里被另一台机器判过太多次分了。
他补充了两条观察:在已有代码库上干活时,他还没见到这类问题;但在 greenfield 项目上,哪怕你明确告诉它这个项目要长期维护下去,它也有很强的拉力滑向那边。
然后,Flask 作者 Armin Ronacher 拿出了一堆证据。
 https://lucumr.pocoo.org/2026/9/7/astra-why/
Ronacher 在 9 月 7 日的博客里复盘了一个周末实验。
他给 Astra 定了个目标:让 Python 用上虚拟线程和词法作用域。工作流完全交给模型自己决定,自己管理上下文,自己在 agent-notes 目录里记笔记,自己派生子 agent。然后他就去过周末了。
35 小时后他把它关掉。产出是净增 7.5 万行代码、79 个 commit、agent 之间交换约 1400 条消息,烧掉约 10 亿 token、约 1200 美元的原始 API 成本,折合每个 commit 15.5 美元。
按他自己的结论,这些东西没有产生任何价值,也没让他学到怎么把工厂开得更好。
有能力解决千禧年问题的 Astra 为什么如此拉胯?
第 一类问题出在工具调用的代码上。
Astra 大量放弃 harness 提供的 patch 工具,改用 Python 把整个 C 源文件读成字符串,做 replace,再写回磁盘——一行里用分号串起四五条语句,改的是 CPython 的编译器和内部头文件。要在 Windows 上验证剪贴板行为时,它用 Bash 调 Python,Python 调 Node.js,Node.js 再去拉起 PowerShell。
有一次它想确认 macOS 上能不能通过 Unix socket 传文件描述符,写出来的探测脚本长这样:
Pythonfor into in (False,True): a,b=socket.socketpair();fd=os.open(os.devnull,os.O_RDONLY);b.sendmsg([b'c'],[(socket.SOL_SOCKET,socket.SCM_RIGHTS,array.array('i',[fd]))]);print('fds',a.fileno(),b.fileno(),fd)
能跑,也确实省 token。问题是当模型绕开编辑工具、改用这种方式动文件,你就没法靠读它的动作跟上它在干什么,只能等尘埃落定后去看最终产物的 diff。
第二类问题更麻烦:这种风格漏进了要提交的代码。Ronacher 贴出的几段单元测试没有空行,缩进随意,赋值挤在分号后面。
他算了笔账,这些测试在 ruff format 之前,比格式化之后省大约 10% 的 token。他还在生成的 C 代码里看到 CPython 代码库中根本不存在的写法,一行连打多个宏;在 Python 里看到 _task_accelerator[6]、[8]、[5] 这样的裸下标存取状态,那些数字从哪来无人知晓,而且这个原本只服务于测试断言的函数,后来被非测试代码用上了。