
联想YOGA Pro 15 RTX Spark上手体验:笔电的身形,桌面工作站的实力
在今年的 Computex 2026 上,英伟达正式公布了 RTX Spark 超级芯片:一个高度集成的芯片产品,也是 AI PC 时代的全新玩家。
现在,RTX Spark 笔记本电脑也陆续预约开售,摆在消费者面前的是一个全新的品类选择,专为 Windows on ARM 平台而生的移动 AI 工作站,但是创意生产和游戏需求也能胜任,还有轻薄机身和便携属性加持。
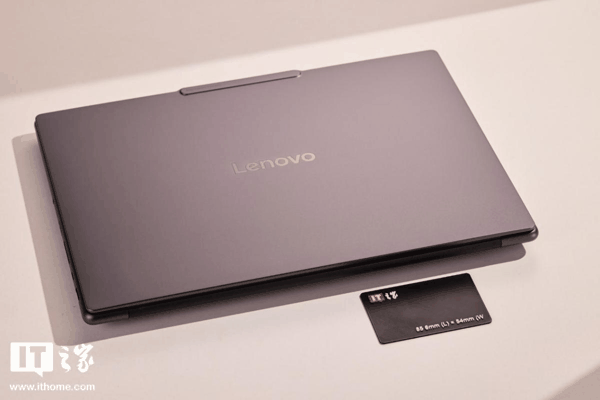 IT之家前不久也拿到了 RTX Spark 笔记本电脑新品之一的联想 YOGA Pro 15 RTX Spark ,128G 统一内存版本售价 42999 元。值得一提的是,联想、华硕、微星、戴尔、微软均已推出搭载 RTX Spark 芯片的笔记本新品,部分产品上架后光速售罄,市场需求火爆。今天就跟大家详细汇报一下它的性能表现究竟如何。
IT之家这次拿到的联想 YOGA Pro 15 RTX Spark 笔记本电脑,承袭了 YOGA 系列一贯的简约商务风和出色质感。
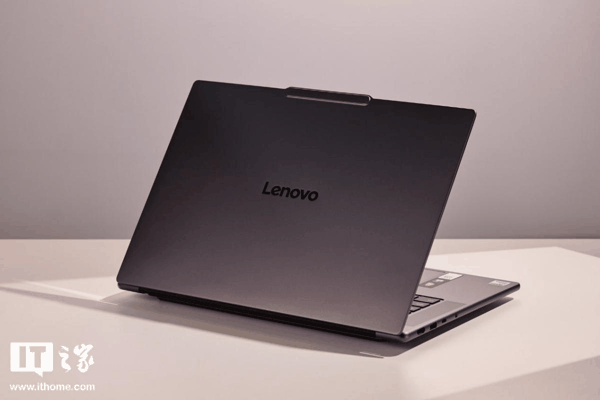 我们手上这台采用了“雷霆灰”配色,一体成型的 CNC 工艺加持、干净利落的机身线条、细腻顺滑的金属触感以及沉稳内敛的中心 Lenovo 品牌标志,无不体现着 YOGA 产品极致的商务属性,专业创作者和商务人士也非常吃这套审美。
A 壳顶部依旧保留了凸起的“Bar”设计,不过并没有磁吸功能和触点,也不能挂载其它配件,而是将空间留给了 B 面的镜头模组。
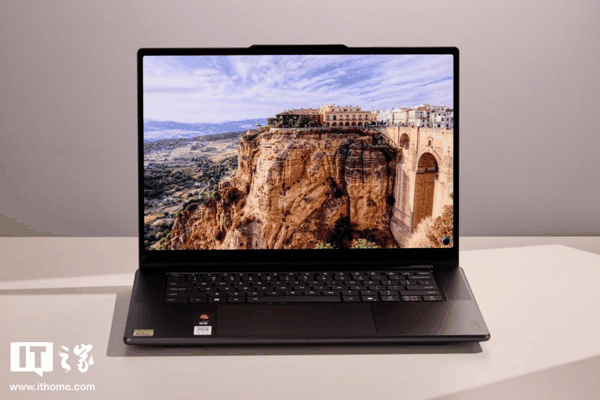 屏幕部分采用超窄边设计,屏占比极高。这是一块 15.3 英寸、16:10 比例、2K 分辨率的广色域 OLED 镜面屏,支持 165Hz 高刷新率,100% DCI-P3 广色域以及 Adobe RGB、REC709、sRGB、P3 等色域的专业校色,屏幕还支持触屏操作,交互场景更加丰富。
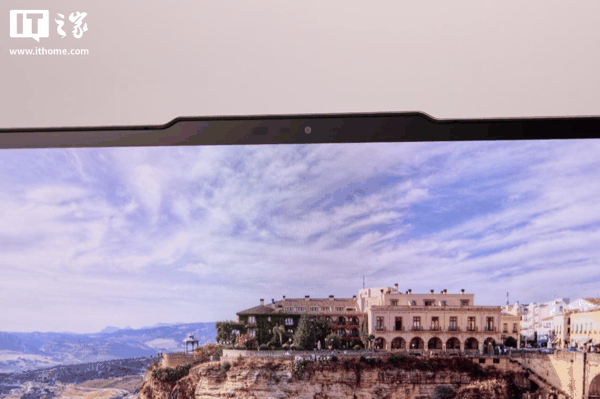 屏幕顶部集成了 9.2MP 高清摄像头,支持 IR 红外传感器,可通过 Windows Hello 进行人脸识别解锁。
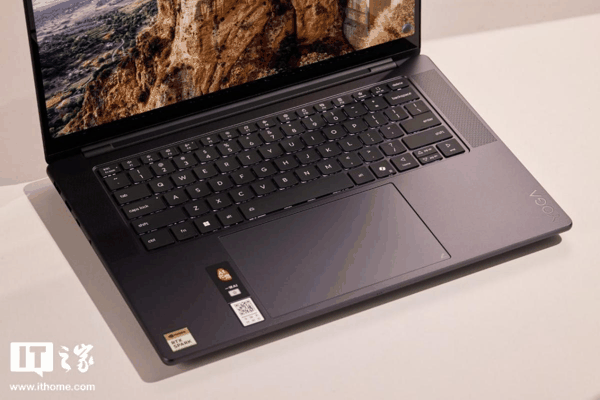 外设部分除了屏幕,最令人瞩目的就是 C 面这块“韵律键盘”,标志性的 0.3mm 微弧键帽设计、1.5mm 长键程、白色居中字符 + 白色键盘背光、准分子 UV 涂层一个不少,打字体验舒适。
联想 YOGA Pro 15 RTX Spark 搭载一块 7 英寸全域压感数位触控板,支持联想 YOGA 灵感妙笔手写,还可作为数位板绘画创作。
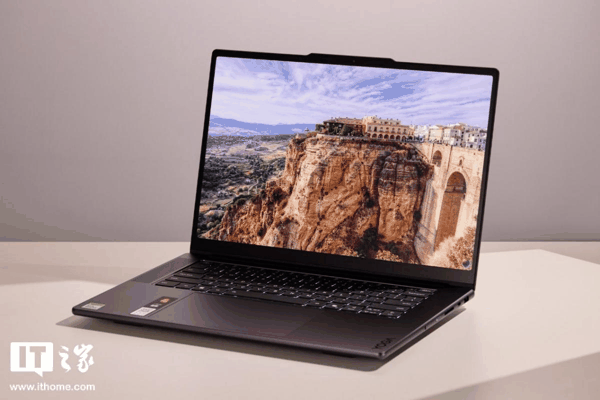 尺寸方面,联想 YOGA Pro 15 RTX Spark 整机厚度仅 16.7mm,重量轻至 1.7kg,这在全金属机身的笔记本中属于相对轻薄和便携的水平。
RTX Spark N1X 是 NVIDIA 面向 Windows on ARM 平台推出的超级芯片(Superchip),它打破传统 x86 笔记本 CPU + 独立 GPU 分离方案,采用 S-die 和 G-die 多芯片封装架构,基于台积电 3nm 制程打造,把 Blackwell GPU、Grace ARM CPU、内存控制器、高速互联集成在一套封装内。
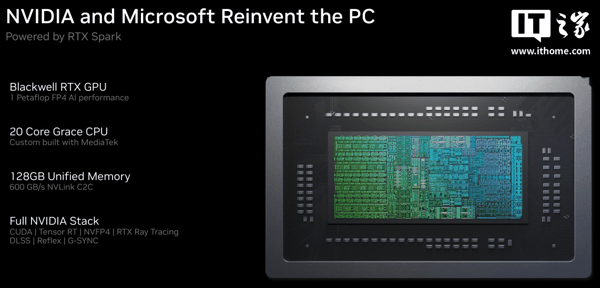 目前 NVIDIA 公布了两款 RTX Spark N1X 芯片,分别是 RTX Spark N1X-5120 Core 和 RTX Spark N1X-6144 Core,它们共享一套架构和内存子系统,主要差异在规格上。
前者为 18 核 CPU(9*Arm Cortex-X925 大核 + 9*Cortex-A725 小核),GPU 则拥有 40 组 SM 单元、5120 个 CUDA 核心。
后者则是 20 核 CPU(10*Arm Cortex-X925 大核 + 10*Cortex-A725 小核),GPU 则拥有 48 组 SM 单元、6144 个 CUDA 核心。
Cortex-X925 大核频率在 3.9GHz 至 4.1GHz 之间,Cortex-A725 小核频率为 2.8GHz。S-die(CPU)和 G-die(GPU)通过 NVIDIA NVLink-C2C 连接,接口带宽可达 600GB/s。S-die 为 NVIDIA 与联发科共同研发,除 CPU 核心外还包含内存控制器、PCIe 接口等模块。
G-die 可以看作是 RTX Spark N1X 的核心,它拥有基于 Blackwell 架构的 RTX GPU 完整规格和技术特性,比如硬件上的第四代 RT Core 与第五代 Tensor Core,原生 NVFP4 支持等;软件拥有 DLSS 5、CUDA 加速、3D 引导神经网络渲染等,因此对于游戏、专业创作和 AI 大模型推理、图片视频生成都有对应的软硬件、AI 算力支撑。
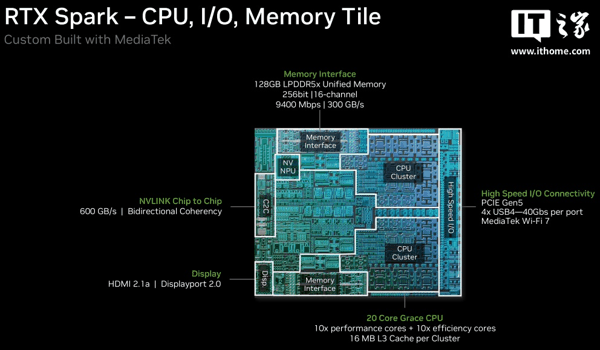 RTX Spark N1X 的一大卖点是“统一架构”设计,比如 LPDDR5X 统一内存拥有 16 通道,和 256-bit 位宽,最高 9400Mbps 的速率以及 300GB/s 的内存带宽峰值。前面我们提到的 NVLink-C2C 设计将 Grace CPU 与 Blackwell GPU 耦合在一起,而高达 128GB 的超大统一内存也能实现手动分配,把内存当显存用,这就相当于拥有了一块足以胜任大型游戏、AI 吞吐和 token 解码的超级“独显”,让笔记本也能拥有桌面级 PC 的性能实力。
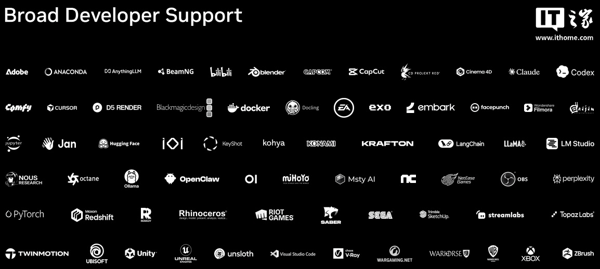 虽然 RTX Spark N1X 的产品落地于 Windows on ARM 平台,但 RTX Spark 产品发售即享有成熟且丰富的 NVIDIA CUDA 加速计算生态,NVIDIA 强大的号召力也足够带领主流工具开发者第一时间适配 ARM 平台,从 Windows x86/x64 平台迁移过来的 AI 软件、专业创作工具和主流应用都能无缝衔接。
比如 Blender、DaVinci Resolve、Adobe 全家桶等专业创作工具的 ARM 原生版本直接可用,本地 AI 应用如 ComfyUI、Ollama 等也都有 ARM 版本。
联想 YOGA Pro 15 RTX Spark 这次搭载的是基于 ARM64 处理器的 Windows 11 64 位系统,大版本号来到了 26H1,因此本次采用的测试工具也都选择了 ARM64 版本,而不用借助 Prism 进行转译从而受多指令集的影响,确保能够反映出硬件的真正性能水平。
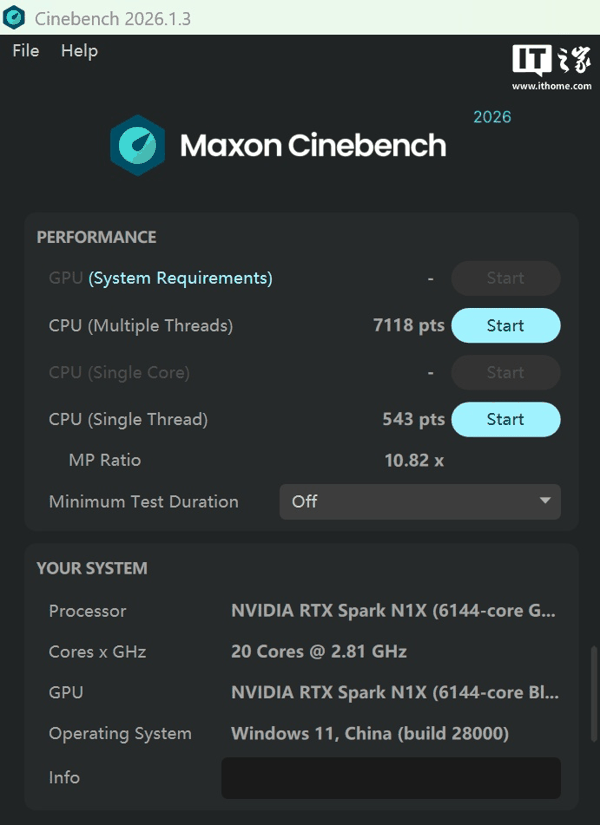 CPU 部分首先来看 CineBench 2026 测试,它的多核渲染测试部分计算工作量最大,场景复杂度和光线计算量更加符合 3D 项目的实际负载,并进一步延长了测试时间,避免处理器短时睿频对于跑分结果的干扰。
在此项测试中,NVIDIA RTX Spark N1X CPU 获得了单核 543 分,多核 7118 分的成绩。这个多核表现还是非常亮眼的,与 14 英寸 MacBook Pro 上 Apple M5 Pro 芯片(7105 分)持平,证明了其在 CPU 性能水平上无需担心。
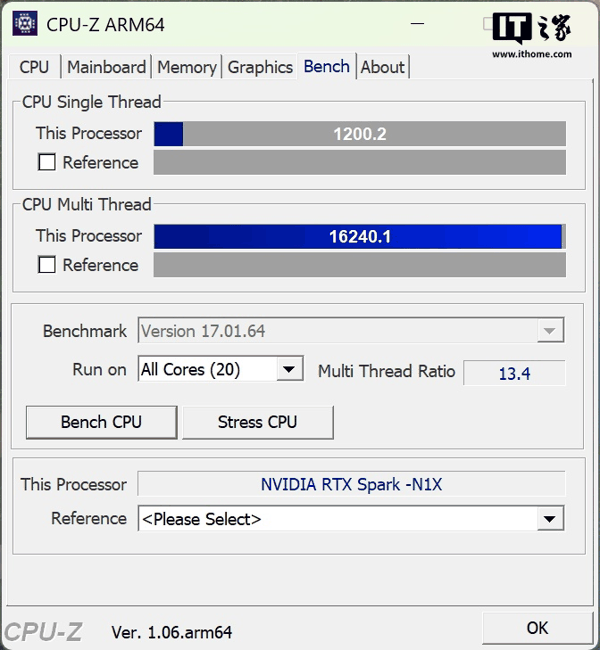 然后是 CPU-Z,单核得分 1200 分,多核得分 16240 分。这个成绩没啥多说的,也是旗舰水平。
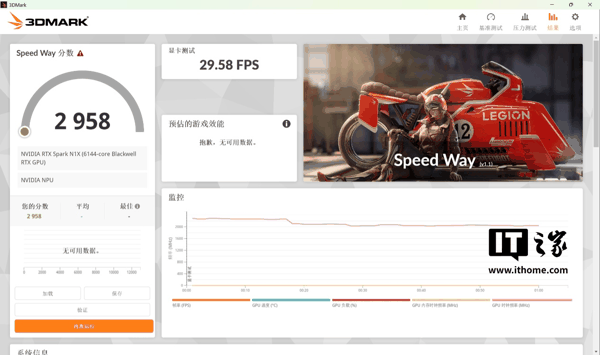
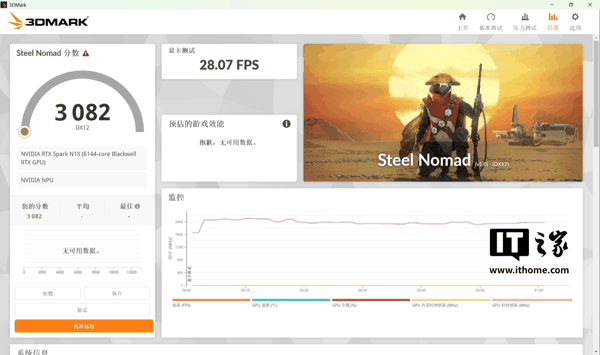
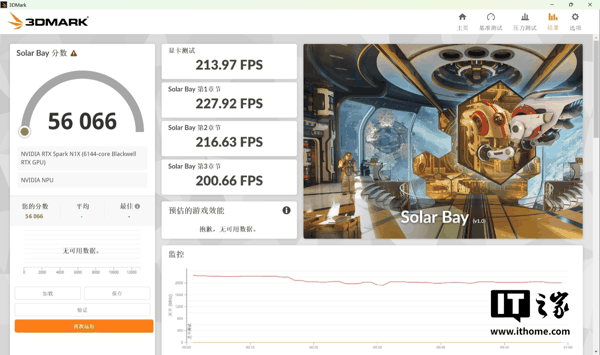
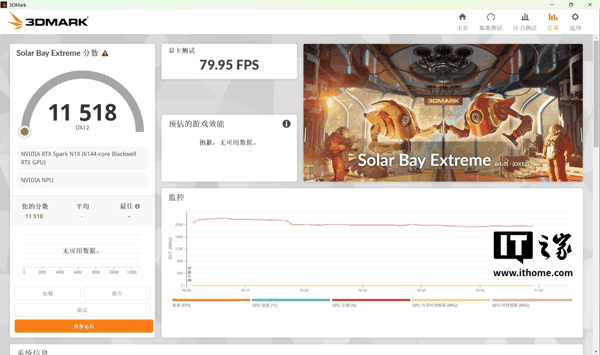
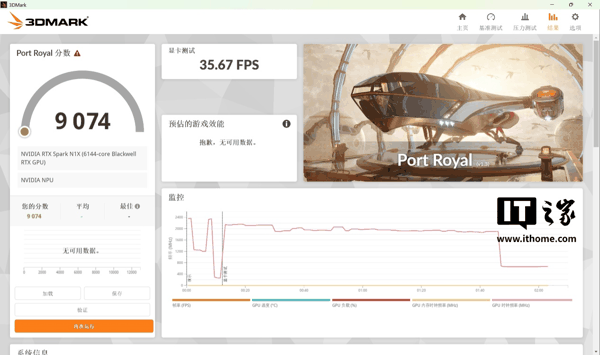 显卡方面,我们主要看 3D Mark 的测试成绩:
从以上测试结果来看,RTX Spark N1X GPU 的理论性能相比笔记本上的移动版 GeForce RTX 5060(140W)显卡还要强一些。不过,两者的定位完全不同,因此不能直接做对比参照。
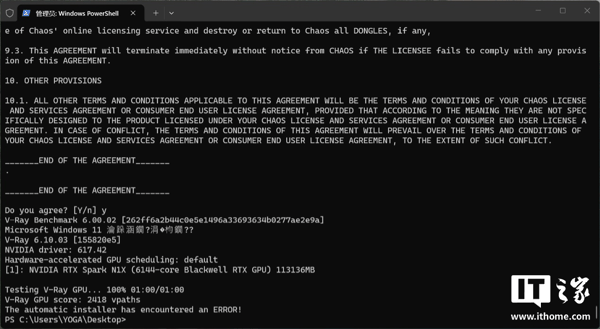
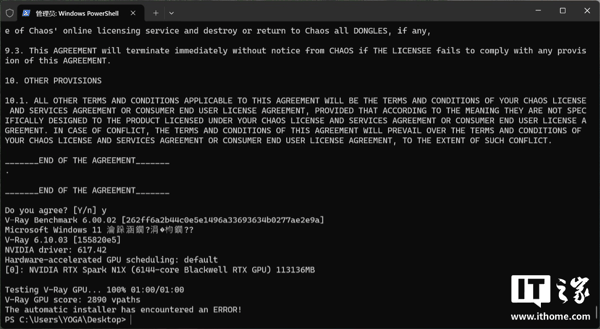 生产力表现上,我们主要测试了 V-Ray BenchMark 6.00.02 和 Blender Cycles 5.3.0 beta 两项基准测试。
其中 V-Ray BenchMark 主打基于物理的光照、材质、全局光与光线追踪,可输出照片级静帧和动画,并支持 GPU 及混合渲染。它深度集成在 3ds Max、Maya、SketchUp、Rhino、Revit 等主流 DCC / CAD 软件中,参考价值较大。
我们通过 PowerShell 终端对 Cli 版本启动测试,在其 GPU-CUDA 的测试中,RTX Spark N1X 取得了 2418 分的渲染成绩。
另一项 GPU-RTX 测试中,RTX Spark N1X 取得了 2890 分的渲染成绩。
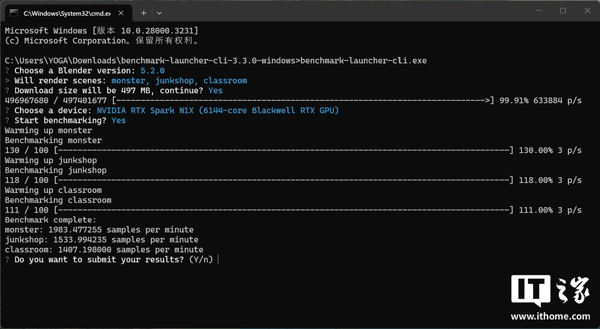 在 Blender Cycles 基准测试 5.3.0 版本中包含了对 DLSS 4.5 光线重建降噪的考察,其 3 个固定测试场景主要测试 GPU 在 Cycles 路径追踪下的渲染速度。该测试中我们需要将 blender BenchMark 3.3.0 版本的测试资源替换成 5.3.0 版本最新测试资源,同样通过 PowerShell 终端对 Cli 版本启动测试,RTX Spark N1X 的三项场景测试分数分别为:
以上两项生产力测试中,Blender Cycles 项目上 RTX Spark N1X 可以和 GeForce RTX 5070 Ti 笔记本电脑 GPU 掰掰手腕,只有 Monster 测试由于显存带宽的总吞吐量受限,成绩稍弱一点。另一项 V-Ray 6.0 的成绩可以达到 GeForce RTX 5060 笔记本电脑 GPU 的水平,但是只需要 80W 的封装功耗就能实现。
值得一提的是,无论是理论跑分还是生产力基准测试,这台联想 YOGA Pro 15 RTX Spark 都可以直接离电进行,分数差距均控制在 5% 以内,充分证明了其出色的电源管理、系统性能调度和 CPU 在能效上的优势。
本地 AI 可以说是 RTX Spark 目前最重要的使用场景,NVIDIA 官方在 RTX Spark 发布会上就明确表示:
这就是一台“随时、随地、断网也能用”的 AI 工作站,在设备上运行本地 AI 最大的价值。
另一方面,RTX Spark 目前已支持丰富的主流本地模型,比如 Qwen3.8-27B、Qwen3.8 Flash Next、NVIDIA 自家的 Nemotron Bolt 等,而且能够充分利用 Blackwell GPU 张量核心与 llama.cpp 等 CUDA 兼容框架加速。因此这个部分我们主要是验证一下 RTX Spark N1X 主推的端侧 AI 性能表现。