
GPT-6-Astra具身能力遭大考!传统基准拿满分,真机频碰壁
编辑|杜伟
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
「GPT-6-Astra 的具身能力上限到底在哪?具身社区下一步最值得做的是什么?」
 近日,商汤联合大晓机器人、Ropedia、新加坡南洋理工大学和东京大学的研究团队在《Has GPT-6-Astra Achieved Embodied Intelligence?》中,给出了 覆盖 12 项仿真评测、8 个真实机器人平台的系统分析 。
他们还分析了 GPT-6-Astra 与底层机器人控制系统的协作方式,搭建了一套更贴近真实家庭需求的具身评测原型。
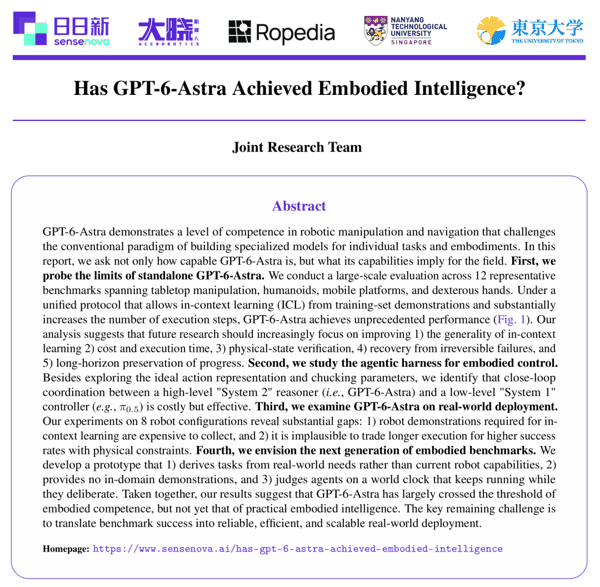 技术报告地址:https://www.sensenova.ai/has-gpt-6-astra-achieved-embodied-intelligence
有意思的是,同一个 GPT-6-Astra,在简单解除限制之后,在多项传统具身评测中交出了满分或接近满分的成绩:其中在长程组合操作评测基准 LIBERO-Long++ 上达到 100%,在考察操作鲁棒性和泛化能力的 LIBERO-Pro 上达到 99.3%,人形机器人基准 SIMPLE 上达到 98.8%,RoboDojo 上也可以达到 81.9%。但当这个模型指挥起真实机器人干活,一些日常小事,依然让它犯了难。
「把笔放进笔筒这个对人来说几秒钟就能完成的任务,总耗时 4 个多小时,消耗 55 美元。」
「明明判断鸡蛋煎好了,却没能及时关火,最后把鸡蛋烧焦;打开冰箱放下牛奶后,又转头忙着搬水果,让冰箱门敞开了好几分钟。」
「插入插头的操作,在多款真机交叉验证 11 次,一次都没成功。」
高分与失误放在一起,明显的反差暴露出一个关键问题:有能力规划、观察并纠正动作的通用大模型,距离可靠地干活,还有多远?
报告给出的判断是: GPT-6-Astra 已经在很大程度上跨过了具身能力的门槛,但距离能够实用部署的具身智能仍有相当差距 。实验中暴露出的成本及耗时的问题、那些意想不到的失误,恰好说明接下来的最值得啃的硬骨头在哪里。
值得注意的是,在去年 GPT-5 发布后,相同团队也做过一篇针对其空间智能的评测文章《Has GPT-5 Achieved Spatial Intelligence》,随后就发布了 SenseNova-SI 系列模型。这么看来,这次的评测更像是一次「提前预告」。
从满分到不足三成
成功率差在哪?
当前,机器人操作领域广泛采用经过专门训练的控制策略,以及视觉 - 语言 - 动作模型(VLA)等技术路线。这类模型通常利用真实或仿真的机器人操作数据进行训练,让机器人根据视觉信息和任务指令,执行抓取、移动、放置等动作。
GPT-6-Astra 的出现,为具身智能提供了另一种可能。通用大模型能够结合视觉信息、机器人状态和任务要求,直接生成操作指令,以进行后续执行和调整。它能完成的任务,也开始跨越不同的机器人形态。
为了系统地研究这种能力, 商汤 SenseNova 及其联合研究团队选取了 12 项代表性评测,覆盖桌面操作、灵巧操作、人形机器人移动操作、家庭长程任务和视觉语言导航等五类场景 。评测中,GPT-6-Astra 使用同一套评测思路,在不同环境中读取观察到的信息、生成机器人动作,并根据执行结果继续决策。
成绩确实很突出。除了上文已经提到的 LIBERO-Long++、LIBERO-Pro 和 SIMPLE,在超长程机器人操作基准 LIBERO-Ultra-Long 上为 98.9%。对于更复杂的灵巧操作,GPT-6-Astra 在 DexJoCo 上取得 87.3% 成功率,在 RoboDojo 上达到 81.9%。这说明,GPT-6-Astra 在大多数评测中达到或超过了当时已公开方法的最好成绩。
主题:GPT-6-Astra|具身能力|通用大模型