
让自然语言成为世界模型的表征,英伟达Physis-Lang这样增强视频物理真实性
 X:https://x.com/NVIDIAAI/status/2105051552029556942
从一块黄油如何融化,到 Physics-IQ Verified 的榜一,视频里的物理细节值得被重新描述一遍。
给视频模型一句「黄油受热融化」,它该生成什么?
一块逐渐变小的黄油、一圈向外扩散的液体,还是一团突然瘫软的黄色物体?这句话点出了事件,却省略了中间的过程。热量如何改变状态,重力如何影响形状,固体缩小与液体铺展怎样同时发生,都需要模型自己补全。
英伟达联合 MIT 和牛津大学的研究团队提出的 Physis-Lang,就从这些经常被省略的细节入手:把物理原因、规律和结果写进语言描述,再让这套描述贯穿数据筛选、模型训练和视频生成。
视频 1|Physis-Lang 完整演示:物理语言表征、描述准则自进化、数据检索及视频生成结果。
 图 1|Physis-Lang 论文标题、作者及研究机构。 在权威榜单 Physics-IQ Verified 上,Physis-Lang 的 Cosmos3-Super 和 Cosmos3-Nano 版本分别以 48.2 和 43.3 的得分,按平均分位列第一、第二。
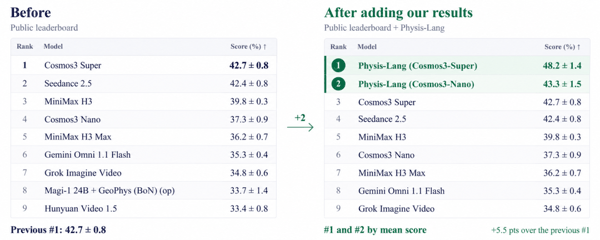 图 2|Physics-IQ Verified 榜单对比。Physis-Lang 的 Super 与 Nano 版本按平均分位列第一、第二,Super 较此前最高分提升 5.5 个百分点。
榜单地址:https://physics-iq-verified.anates.ai/
其中,Super 比图中此前最高的 42.7 分高出 5.5 个百分点;16B 大小的 Cosmos3-Nano 加入 Physis-Lang 以后,均分也超过了原始 64B 大小的 Super 模型。一个值得追问的问题是:语言描述究竟改了什么,能把提升传递到生成的视频里?
在训练和推理的 caption 中,细致地注入物理过程
普通视频 caption 往往擅长交代场景:画面里有什么,谁做了什么动作。Physis-Lang 进一步要求描述物体之间的作用,以及这种作用如何推动后续变化。
Physis-Lang 在基础描述之外加入物理推理信息。训练时,它为真实视频重新生成更细致的文本监督;推理时,它扩展用户的简短输入,并补充与当前场景相关的负向描述,约束不合理的物理行为。
还是黄油的例子。更完整的描述可以是:持续加热使黄油逐渐融化,固体部分在重力作用下塌落,体积不断缩小,融化后的液体在周围形成逐渐扩大的浅层液池。
这段话给出了连续的状态变化。生成模型需要表现的,不再只有「黄油」和「融化」两个概念,还有升温对物态的影响,固体与液体之间随时间变化的关系。
但描述更长,也可能意味着编造更多。模型如果把看不见的原因写得头头是道,反而会引入错误监督。因此,这项工作的关键,是让物理描述能够被检查,并据此持续改进。
评价 caption 物理细致程度的 PhysCapBench
& 自进化的 caption prompt
视频 2|描述准则的自进化流程:固定标注模型,根据物理评估反馈迭代共享的 caption prompt,并通过 PhysCapBench 验证。
研究团队为此构建了 PhysCapBench:一个评判视频描述中物理细节是否充分、是否正确的 benchmark。它包含 246 段物理视频,以及 3,794 条经过人工核验的原子断言,平均每段视频约 15.4 条。
所谓原子断言,可以理解为能够单独判断真假的物理陈述。例如,杯子撞上硬物后破裂,评估时会先将碰撞、受力和破裂的整个过程分解为逐条简短的物理陈述,再逐一评判,而不是笼统地给整段文字打一个印象分。
评分分为两个方向:Precision 检查描述说出的内容有没有依据;Recall 检查人工标注的物理信息有没有被覆盖。两者合成 F1,让「写得对」和「写得全」都有了可比较的尺度。
有了这把尺子,自进化才有明确的反馈。系统先在固定的 20 段开发视频上生成描述,由物理评估器指出遗漏和错误,再交给进化智能体修改共用的描述准则。更新后的准则还要在 PhysCapBench 上验证,最后选出表现最好的版本。
这个过程中,标注模型的权重保持不变。每轮修改的是所有视频共用的 caption prompt,而不是逐条给某个视频的答案「打补丁」。