
从Chat、Code到Discovery,AI开始学着做科学家
机器之心发布
成立才一个多月,估值就要冲到 500 亿美元。
根据 Business Insider 9 月 11 日报道,Jeff Dean 的新公司 Discovery Loop 正在寻求新一轮融资,这个数字几周前还是 100 亿美元,虽然还未最终落定,但目标估值已经翻了五倍。
按照 Discovery Loop 公司的规划,AI 将参与提出实验、执行实验和分析结果,而第一个被研究的对象,就是自家的技术体系。
资本押注的逻辑很清晰:如果 AI 能加速 AI 的研发,那被加速的就是一切。
2022 年底 ChatGPT 刚出现时,大家还在惊讶于 AI 能写文章、回答问题。如今,从 Chat 到 Code,AI 能够完成的任务越来越复杂。
过去几个月,这种 “推背感” 又强了一截。
5 月,OpenAI 公布了一份由模型给出的数学证明,推翻了数学家研究了近 80 年的埃尔德什单位距离猜想。几位外部数学家检查了证明,还专门写文章讨论它带来的新认识。
Anthropic 则把一个 AI 研究问题交给了一群 Agent,利用较弱模型的反馈训练更强的模型。在这个过程中,研究人员只设定问题和评价标准,AI 自己提出思路、运行实验、比较结果,再继续调整。在论文实验中,AI 找到的方法超过了人类研究者调优的基线。
Demis Hassabis 在今年 Google I/O 表示,如今是 “科学发现的新黄金时代”。 Chat、Code 之后,全球最前沿的实验室都在不约而同地往一个方向走 ——Discovery ,让 AI 参与科学发现,创造连人类也不知道的新的知识。
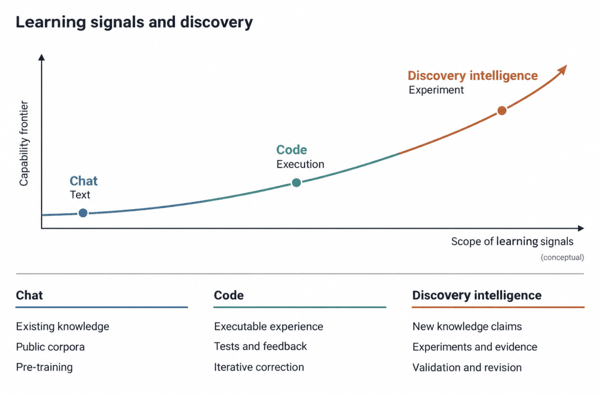 图 1:智能跃迁的三个阶段:从 Chat 到 Code 再到 Discovery Intelligence。 从 Chat 到 Code,变化的不只是模型能够完成的任务,也包括模型能够接触和学习的经验类型:从静态知识,扩展到带有行动、结果与反馈的交互式 experience。
但越往未知处走,AI 就越难依赖现成的任务说明。当人类也不知道答案时,AI 该如何选择下一步,又怎样把一次探索中获得的经验,用到下一次研究?
现在,这个领域迎来了一位值得关注的新玩家。
9 月 15 日,新型研究组织(Neo Lab)PhAI Labs 发布 Discovery Foundation Models(DFM)技术报告,提出一套面向开放式科学发现的通用模型系统。核心团队成员来自斯坦福、牛津、普林斯顿等高校及产业研究机构,研究方向涵盖基础模型、强化学习、智能体、科学智能与递归自我改进(RSI)。
这支团队兼具顶尖科研履历与模型研发经验。据介绍,核心成员在 Cell、Nature、Science 三大期刊均有第一作者论文,在 NeurIPS、ICML、ICLR、CVPR 等顶会上累计发表百篇论文,多项工作入选 Oral。除了学术成果,团队还拥有基础模型预训练、强化学习与具身智能系统研发的实战经验。更为难得的是,这一团队组合将科学问题定义、模型训练、具身执行与强化学习四层能力汇聚于一体,为连接科学问题、模型研发和实验反馈提供了科研与工程两方面的支撑。
他们的思路,是把科学发现从一条直线变成一个闭环:
让 AI 自己识别值得研究的未知问题,提出的假设也不停留在文本里,而是进入真实的工具、数据与实验环境,接受外部证据的检验,而每一次验证的结果,都成为下一次探索的起点,反过来更新 AI 对世界的理解,开启下一轮发现。
在这个过程中,人类科学家的判断与关键选择被完整记录下来,成为训练下一代模型的经验。
技术报告:Discovery Foundation Models: Toward Open-Ended Discovery Intelligence
报告链接: https://arxiv.org/abs/2609.15973
DFM 科学家计划入口:https://phai-labs.com/collaborate/
官方网站:https://phai-labs.com/
模型已经很强,科研还卡在哪里?
让 AI 进入科学研究,困难首先在于:研究往往没有一套预先写好的任务说明。
Karpathy 今年 3 月开源的 autoresearch,AI 自主修改训练代码、运行实验,并根据指标保留还是撤回。autoresearch 可以在明确的训练环境里,用固定指标判断一次修改是否有效。
但在真实科研中,研究者可能连应该研究什么、应该测量哪些变量都需要反复斟酌。一次实验失败,有时意味着方法需要调整,有时则是问题本身就问错了,而区分这两种失败,恰恰是科研里最难、最有价值的判断。
这些判断很少完整地出现在论文里。人们通常能读到最终结论,却不容易看到一个假设为什么被放弃、一次实验为什么失败,以及哪条新证据改变了研究方向。而这些没被写下来的过程,正是 AI 学会做科研最需要的学习材料。
实际上,从产业分工看,两端的资源已经存在。一端是前沿 AI 实验室,提供通用模型、推理能力、算力和训练工具;另一端是科学家、研究机构和自动化实验平台,拥有真实问题、专业数据、实验条件和领域判断。
然而,两端之间,仍有巨大 Gap:
用通用大模型,经验留不下来 。科学家会不断追问、修改或否定 AI 的建议。但这些反馈往往散落在聊天记录里。后续实验结果没有返回系统,AI 就无法知道自己的哪项建议有效、哪项判断被证伪。
用 AI Scientist,领域换不动 。自动研究 Agent 能在计算环境里完成连续实验,但每换一个领域,工具、数据接口和验证流程都要重新配置;一旦涉及细胞培养、分子合成这类湿实验,还要解决仪器接入和真实反馈的问题。
用专用科学模型,预测接不上决策 。AlphaFold 能预测蛋白质结构,分子生成模型能设计候选分子。但预测做得准确,不代表能自动回答后续问题:改变一个分子、加入一种物质或者调整实验条件,会带来什么影响?这些判断仍需要额外的模型、仿真或实验。
就算建起自动化平台,经验也复用不了 。哪些方案可以先用计算方法筛选,哪些地方必须请科学家判断,哪些假设值得投入时间和资源做湿实验。这些选择如何配合,一次研究积累的经验怎样用于其他项目,还是需要有人来组织。
四个问题指向同一件事:AI 不缺工具,缺的是让判断、证据和经验持续积累的闭环。而这,正是 PhAI Labs 要解决的事。
构建承载科学研究经验的基础设施
PhAI Labs 的判断是,要让 AI 参与科学发现并且让这一过程规模化,缺的不只是更强的模型,还需要 一套 能够承载科学研究经验的基础设施 。
模型会迭代,但研究过程中产生的判断、证据与反馈,需要一个地方沉淀下来。
这套 Science Infrastructure 需要组织科研数据与研究轨迹,提供可执行、可复用的科学环境,连接模型、工具、仿真、科学家和真实实验,并让一次研究中产生的经验能够进入下一轮训练与发现。
为此,PhAI Labs 提出了一个五层能力体系。
最底层是 Science Data ,负责整理科研数据和研究过程。科学家的修改、工具的运行结果、真实实验的反馈,都需要保留来源和上下文,才能成为后续研究与模型训练可用的材料。
第二层是 ScienceIDE ,把科学代码、工具、任务目标和验证标准组织成可执行、可验证和可复用的研究环境,让研究者在进入一个新任务时,不必每次从零搭建工具和流程。
第三层是 JEPA - Anything ,探索如何预测科学系统在不同条件下的状态变化。例如,采取一种干预、改变某个实验条件之后,可能发生什么?这类预测可以帮助研究者快速筛选方案,再把更值得验证的假设交给耗时更长、成本更高的湿实验。
第四层是 DFM 核心推理系统 ,通过多模型协同组织研究过程。它结合了基座模型、当前研究状态、记忆和验证机制,决定下一步是修改假设、调用工具、进行预测,还是寻求专家判断与实验验证。
第五层是 ScienceBuddy ,负责与科学家的实时交互。研究者的追问、修改、采纳和否定,都可以成为系统改进的依据,并进一步返回数据层。