
AI算力下一代芯片会是光吗?智子光垣通用光计算技术曝光
当GPU集群的功耗和散热逼近物理极限,当摩尔定律的放缓让“堆更多晶体管”的旧逻辑越来越昂贵,AI算力的下一程增长,需要一条全新的技术路线。光计算,正是被寄予厚望的答案之一——它让光在传播中直接完成矩阵运算,速度和能效潜力远超电子方案。但过去几年,光计算始终面临一个核心质疑:能在实验室跑出惊人数据,却难以像GPU一样灵活适配不同模型和任务。上海一家名为智子光垣的初创公司,正在正面回应这个质疑。其团队打造的光计算芯片能实现150 TOPS算力,并即将推出面向服务器端和边缘端的两款可部署产品。更关键的是,智子光垣的目标不是做一颗“算得快的专用芯片”,而是构建一个可重构、可扩展的通用光计算平台——如果这条路走通,它颠覆的将不只是芯片架构,而是整个AI算力的供给方式。
电芯片正在逼近物理和能耗极限
AI越强,算力的代价就越高。更大的模型、更密集的推理,正在把芯片、供电、散热乃至整个数据中心推向新的极限。今天的问题已经不只是“还能造多少GPU”,而是现有计算方式还能不能支撑下一轮AI增长。
国际能源署预计,2025年至2030年,全球数据中心用电量将从485 TWh增至约950 TWh;其中,面向AI的数据中心用电量将增至约3倍,将导致严肃的AI能源问题。
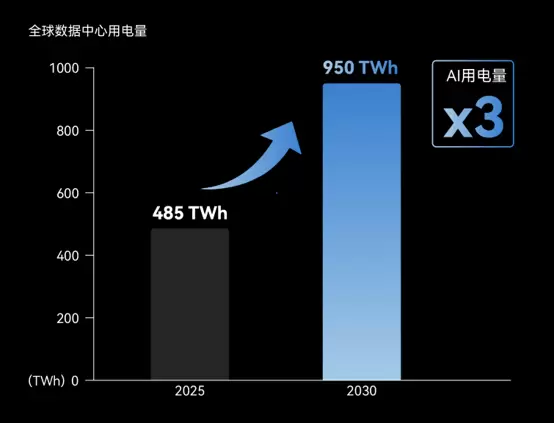 AI数据中心用电量 AI扩张带来的压力,正在从模型Token成本一路传导至算力基础设施紧缺以及电子芯片摩尔定律失效。
当电子计算越来越接近能效边界,一条新的路线正在加速走向产业化——光计算。
电的瓶颈,为什么光计算会是答案?
光的优势,不只在“快”。它可以蕴含海量信息,多路多维度并行,更重要的是,传播本身,就可以成为计算。
光天然存在干涉与衍射等物理效应。通过设计光路,调控不同光束之间的相互作用,完成光的振幅相位等信息叠加,矩阵运算便可以被写入光的传播过程中。而矩阵乘法,正是AI计算中最基础,也最密集的运算之一。
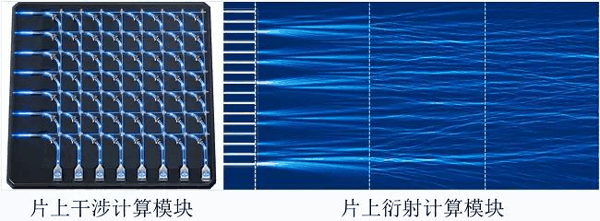 电子芯片需要晶体管不断开关、数据反复搬运,才能完成一次次乘加;而在光计算中,几束光从芯片的一端抵达另一端,大量乘加便可在光速传播中并行完成。
在大规模矩阵运算中,光子方案的速度潜力可达到电子方案的 十万倍 以上,单次运算能耗可降低 一千倍 以上,而所需要的芯片制程要求仅为电子的 十分之一 。
光计算芯片的价值,也正在于此。
但光能算,还不够
真正走向应用,还要回答另一个问题:
光能不能把一次运算中的优势,转化为真实系统可以调用的算力?
今天,光计算已经在特定运算中展现出速度与能效潜力。但从一次验证走向真实应用,面对的不再是单一、确定的计算条件:模型与任务会变化,计算规模需要扩展,芯片也要进入更加复杂的系统与运行环境。
真正的难题,是让光的优势在这些变化中依然成立。
从“能计算的光”,到“通用光计算”
面对这道问题,智子光垣选择了一条最贴近实际需求的路: 推动光计算从“专用”走向“通用”。
所谓“通用”,并非让光包办所有计算,而是在光所擅长的范围内,让同一套硬件不被单一用途永久定义。
这套能力的起点,在计算核心的可重构。
智子光垣从芯片底层构建 时空重构架构 ,使计算关系能够在空间与时间上完成同步调制。计算需求发生变化时,无需重新设计芯片,写进光路的计算关系即可随之重组。
当计算能够灵活重构,“通用”的下一步,是让算力随需求扩展。
干涉计算兼具高精度与灵活性,衍射计算擅长大规模并行。智子光垣通过chiplet将两者融入同一架构,单芯片级联多个光计算核心,使计算规模与可重构性持续提升。