
达瓦科技荣获2026 NVIDIA创业企业展示半程展示卓越企业奖项
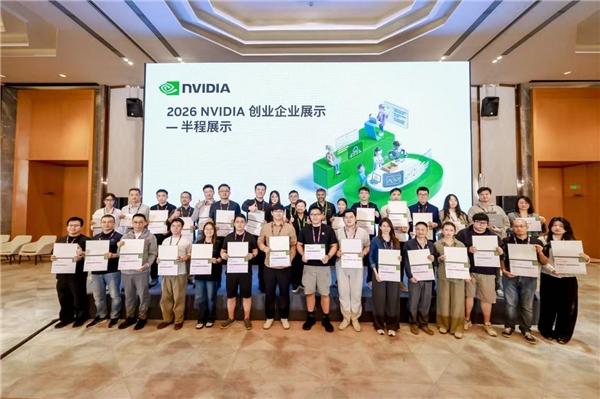
10 月 15 日,2026 NVIDIA 创业企业展示——半程展示在苏州金鸡湖国际会议中心举行。达瓦科技凭借实时世界模型 产品Scenes AI,荣获半程展示卓越企业奖。这是达瓦科技继 8 月获评深圳站优秀企业之后,再次在 NVIDIA 创业企业展示活动中获奖。
本届半程展示从 NVIDIA 创业企业展示各城市分站、超过580家科创公司中选出 30 家企业,围绕 AI 智能体、物理 AI 与 AI 行业应用展开路演。达瓦科技首席产品官李宗兴代表团队登台,分享了达瓦对实时世界模型的技术判断:视频生成解决的是“下一帧画面长什么样”,而世界模型还必须回答“改变一个变量之后,世界将如何演化,以及哪些部分应当保持不变”。
 视频生成的下一道门槛:从生成画面到控制世界
达瓦科技的核心定位,是视频生成控制层。它并不把所有问题都交给一个大模型逐帧重生成,而是在创意与画面生成之间增加一层控制系统:先把场景、角色、镜头、灯光、材质、动作和物体关系组织成可查询、可修改、可持续更新的世界状态,再由生成层把需要变化的部分呈现出来。
这套架构的关键是“控制层做重,生成层做轻”。控制层负责规划行动、维护状态和推演结果;生成层负责把状态转化为视频画面。对离线内容生产而言,控制层让创作者可以只修改机位、动作或灯光,保留同一场景中的其他对象与关系;对实时互动而言,控制层定位真正发生变化的区域,生成层只对局部进行更新,从而减少整幅画面重复计算。
为此,达瓦提出“世界状态维护”的新范式:不再逐帧重画整个画面,而让模型理解画面背后的世界,把空间、人物、相机、光照、材质与物理拆解为可以单独更新的状态,只计算真正发生变化的部分。达瓦科技把这种技术路线概括为:一次构建世界,可以拍、可以渲、可以播、可以玩。
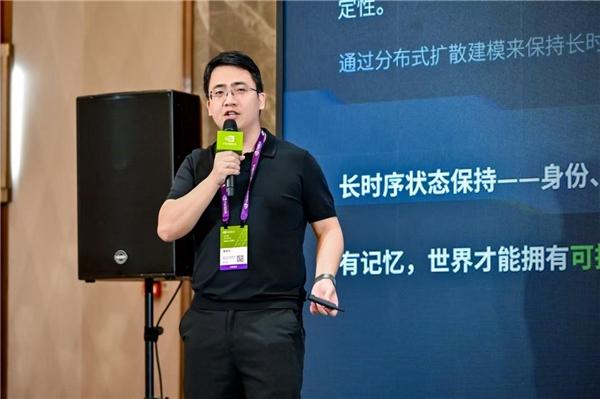 【达瓦科技首席产品官李宗兴在半程展示路演现场】 一张消费级显卡,实时改写一间真实的办公室
这一范式已经在真实空间中得到验证。今年 9 月,达瓦首发了 Scenes AI 的实拍演示:摄像头对准一间普通的办公室,不断给出全新的prompt,实时生成多个场景。核心生成计算全部由本地一张 NVIDIA RTX 显卡承载,办公室可以变成动画草原,也可以出现雪怪、火焰和新的家具形态;但每次变化都遵循同一套世界状态,而不是把整张画面重新抽卡。画面右上角实时显示运行帧率,全程“无预设,无卡顿,100%实时持续生成”。
视频中,地面塌陷,一只雪怪破土而出、攀墙离开,地上的坑洞却一直留在原地;身旁的铁艺椅子先变成红色尖刺座椅,再化作狼首铁王座,主播可以继续坐在原位置;窗帘下摆燃起明火,火势沿着布料向上蔓延,紧挨着的玩偶和花盆却安然无恙;最后,整间办公室化为一片动画草原,空调、窗帘和柜子都留在原位。
这背后是实时生成最难的三道关:推理延迟、误差累积和动态场景控制。摄像头不断输入新画面,人物动作随时改变生成条件,模型必须在有限的算力和显存里,判断哪些内容需要更新、哪些状态应当保留;而人物面貌或空间结构上的任何一次偏差,都可能在后续画面中被不断放大。对达瓦而言,实时性不是单纯把离线视频模型压缩得更快,而是先通过控制层让世界具备状态和控制,再让渲染计算随事件发生。
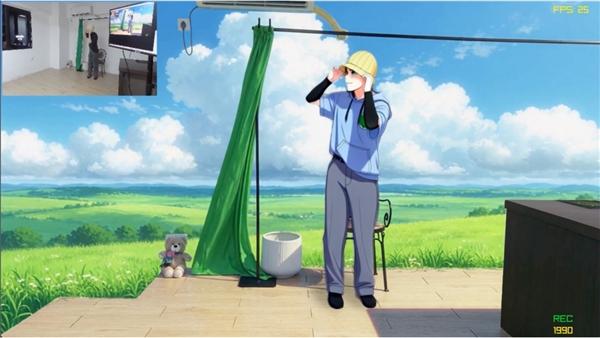 【Scenes AI实时演示将整间办公室化为一片动画草原】 Latent Stage 精准控制:三项关键技术,让 34B 世界模型跑进直播间
Scenes AI 的底层模型 Latent Stage 共有 34B 参数,每步激活约 4B。让如此规模的模型在一张消费级显卡上持续实时运行,依靠的是三项自研技术:
• 稀疏自回归扩散 + 潜空间缓存:只算正在变化的部分。 基于达瓦300+真实商业拍摄数据分析,典型场景中每帧真正变化的区域只占画面的 10% 至 20%。Scenes AI 只对这些区域预测“状态增量”,墙面、地板等稳定区域则通过潜空间缓存(Latent Cache)直接复用。空间上的局部更新,加上模型内部的稀疏激活,使 GPU 消耗相较传统视频扩散方案降低 40% 至 60%,推理速度提升 3 至 5 倍。
• Latent Stage + 世界记忆:改一处,其余不变,而且记得住。 Latent Stage 在潜空间中把场景、人物、相机、光照、服装、道具与物理拆成可以独立控制的变量;世界记忆(World Memory)持续保存已经发生的变化。在连续编辑测试中,目标编辑成功率达到 98.2%,人物身份保持率达到 93.3%。雪怪离开后坑洞仍在,正是模型“记住了世界发生过什么”。
• 神经物理 + 神经渲染:从生成画面,走向推演物理。 神经物理围绕运动、碰撞、重力和材质响应约束生成,神经渲染让火光、阴影同步作用于环境。模型不只生成火焰,还判断了“什么会燃烧、什么不会”。
此外,达瓦提出的非线性视觉矩阵,把角色、环境、相机、光照、物体与运动组织为可重新组合的视觉要素,相关论文NVD技术已被国际普适计算会议 UbiComp / ISWC 2026 接收。
 Live Stage 实时渲染:控制层决定哪里变化,局部扩散负责把变化生成出来
Scenes AI 的实时能力由 实时生成模型Live Stage 承担。它采用因果化的稀疏微扩散设计,不对整幅画面做全帧扩散,而是接收控制层发出的事件、位置、速度、强度、对象身份、材质和局部历史等条件,对变化区域进行少步采样,再将局部结果合成回持久世界。
一条典型的运行链路是:
世界状态 → 行动或接触事件 → 状态更新 → 局部生成与合成 → 结果写回
例如,人物触碰布帘时,系统先由规则与事件层识别接触位置、动作方向和材质条件,再由实时扩散模型处理布料形变与接触边界;稳定的墙面、地板和未受影响的对象沿用已有表示。人物离开后,短时的衣料摆动可以结束,而雪地脚印、地面凹陷等需要长期保留的结果则写回世界状态,供后续镜头和交互继续读取。
在典型场景中,真正发生变化的区域约占画面的 10%—20%。局部更新、稀疏专家激活与潜空间缓存共同减少重复推理,使实时生成更接近传统渲染的计算方式。
真正决定下一代训练质量的数据集,不是视频数据集,是状态数据集
与多数从互联网视频中学习的模型不同,Scenes AI 的训练数据来自真实的影视生产。达瓦在重庆永川运营 8.4 万平方米的全流程数字化科技片场,从 300 多个真实商业项目中,沉淀了约 180TB 结构化世界状态数据,涵盖相机、动作、对象、光照、物理与叙事状态。
这类数据直接对应实时世界模型最难处理的长尾情况:宽袖和裙摆随动作发生形变,手与道具反复接触,多角色互相遮挡,摄影机在表演中连续移动,灯光变化同时影响人物和环境。互联网视频通常只能告诉模型“画面最后长什么样”,而真实片场数据还记录了“相机怎么拍、演员怎么动、对象如何接触,以及导演为什么这样改”。这些恰恰是实时生成最容易出现漂移、穿透和不一致的地方,也是达瓦数据最大的价值所在。真正决定下一代训练质量的数据集,不是视频数据集,是状态数据集。
过去5年,达瓦持续对这些数据进行采集、标注、梳理。在单场戏中进行 300 多个维度的结构化标注,使镜头、光学、空间、表演和动作可以对齐到同一时间轴。这些过程数据分别服务于世界构建、离线视频生成和实时局部扩散,并通过 FilmOS 与 Scenes AI 进入创作和互动场景。客户修改、交互反馈和模型失效案例,进一步为后续数据筛选、补采与训练提供入口。
“这份荣誉属于每一位在片场和实验室里工作的达瓦人。”达瓦科技联合创始人陈亮表示,“我们每天都在拍真实的电影和短剧,每一次打光、每一次运镜,都在告诉模型这个世界是如何运转的。世界模型的下一场竞争,属于拥有真实世界过程的团队。”
“NVIDIA 为实时世界模型提供了坚实的计算底座。”达瓦科技首席产品官李宗兴表示,“我们希望和 NVIDIA 生态一起,让世界模型从实验室走进真实生产,让每一位创作者都能用一张显卡,实时构建、改写并走进一个持续运转的世界。”