
谷歌发布Gemini 4 Neon,速度飙升3倍还支持百万上下文
人工智能在复杂推理与多步骤任务自动化领域迎来新的竞争焦点。谷歌于11月18日正式推出全新 AI 模型 Gemini4Neon,重点发力复杂编程、科学研究以及企业工作流程,致力于在推理能力、响应速度和运行成本之间寻找更优解。目前,该模型已开始向开发者、企业以及部分付费订阅用户开放。
核心能力:百万超长上下文与多智能体协同
据谷歌介绍,Gemini4Neon 拥有高达100万 token 的上下文窗口,能够综合处理电子表格、PDF、图表、音频和视频等多种形态的数据,并将零散信息整合归纳为结构化报告等成果。
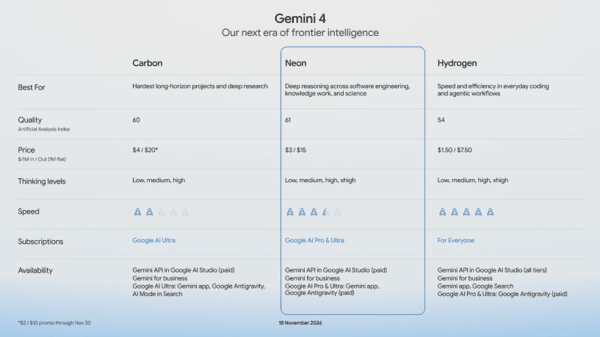
在软件开发与自动化执行层面,Neon 展现出较强的多步骤处理能力:
代码与工程任务: 支持跨文件排查错误与代码重构,适合处理大型代码库中的复杂问题。
多智能体调度: 在谷歌 Antigravity 开发环境中,Neon 可充当“调度员”,协调 Hydrogen 子智能体并行处理不同任务,并在长时间运行过程中持续同步进展。
性能表现:编程智能体指数超 Claude Opus5.5排 第一
在基准测试与内部评估中,谷歌公布了多组针对性数据:
权威 榜单成绩: 在 最高 xhigh 推理档位下,Neon 在 Artificial Analysis 智能指数中以61分位列第三;在同机构的编程智能体指数中则拿下58.6分,超越 Claude Opus5.5位居 第一 。
效率与质量对比: 早期内部评估显示,Neon 的整体任务质量达到或超过体积更大的 Gemini4Carbon,同时任务完成速度达到后者的3倍。在默认 high 思考档位下,相关测试中的单任务成本比同系列 Carbon 模型低32%。
谷歌同时说明,上述排名与成本对比均对应特定评测条件,并不代表所有实际业务场景下的表现。
价格与接入方式:四档推理级别可选,多端逐步开放
在 API 调用定价方面,Gemini4Neon 的具体费用标准如下:
输入费用: 每100万 token 为3美元(现汇率约合20元人民币)
输出费用: 每100万 token 为15美元(现汇率约合100.2元人民币)
缓存输入费用: 每100万 token 为0.15美元(现汇率约合1元人民币)
该模型提供 Low、medium、high 以及 xhigh 共四种推理级别,便于用户按需调节思考深度与资源消耗。个人与订阅用户方面,订阅 Google AI Pro 或 Ultra 后,即可在 Gemini 应用中选择使用 Gemini4Neon。
主题:谷歌|Gemini4Neon