
Claude Sonnet 5.5上线!一半价格,性能逼近Opus 5.5
就在今天早上,Anthropic 正式发布了 Claude 5.5 家族的第二款模型 Claude Sonnet 5.5。
「相比前代 Claude Sonnet 5,5.5 有了明显提升,运行速度提高 30% 以上,在大多数工作中的成本最高可降低 30%。」
 速度更快、成本更低的 Sonnet 5.5 ,将与 Claude Opus 5.5 形成互补。
Opus 5.5 专为需要审慎判断的复杂工作打造,Sonnet 5.5 则最擅长处理范围明确的日常任务、修复代码问题,以及制作精美的文档、幻灯片和电子表格。Sonnet 5.5 也具备敏锐的设计眼光。
与此同时,面向高调用量和成本敏感型应用的 Claude Haiku 5.5,将在未来几周加入 Claude 5.5 家族。
Claude Sonnet 5.5 现已在所有平台上线,包括 Amazon Web Services、Google Cloud 和 Microsoft Azure。开发者可以在 Claude Platform 上使用模型标识符 claude-sonnet-5-5 开始调用。
下面我们具体来看 Sonnet 5.5 的性能、成本与速度、安全与对齐。
性能表现
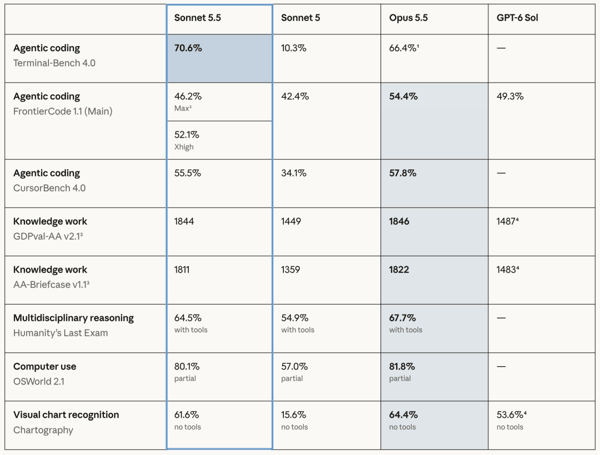
Sonnet 5.5 在各个领域都优于 Sonnet 5,部分领域的提升尤为显著。在多项评测中,采用 Max effort(最大努力程度)设置的 Sonnet 5.5,甚至能取得与 Opus 5.5 相当的表现。
Sonnet 5.5 在编程方面的性能提升尤为明显,其中在智能体编程评测 Terminal-Bench 4.0 上,Sonnet 5.5 的得分为 70.6%,Sonnet 5 为 10.3%。
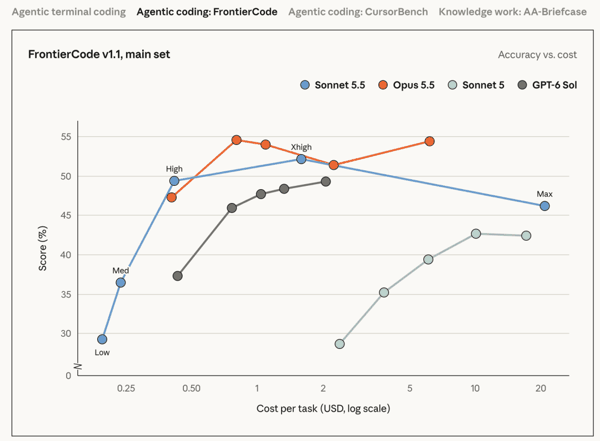
在 FrontierCode 上,采用 High effort 设置的 Sonnet 5.5,比相同设置下的 Sonnet 5 高出 10 分,单项任务成本却只有后者的约十五分之一。在使用真实 Cursor 编程会话任务进行测试的 CursorBench 上,Sonnet 5.5 的最佳成绩与 Opus 5.5 相差约 2 分以内。
在覆盖多个职业真实工作任务的 GDPval-AA 测试中,Sonnet 5.5 的得分仅比 Opus 5.5 低 2 分,比 Sonnet 5 高约 400 分。这项评测使用的真实工作任务覆盖 9 个主要行业、44 种职业。在计算机操作和图表识别方面,它接近 Opus 5.5;在长程知识工作方面,它明显优于 Sonnet 5 和 GPT-6 Sol。
另外,Sonnet 5.5 在长程任务和图像理解方面也表现出色,是首个仅依靠屏幕截图就能通关《宝可梦红》的 Sonnet 模型。
不过,基准测试分数只能反映模型能力的一个方面。在 Anthropic 内部和外部测试者的测试中,面对需要持续判断的复杂、开放式工作,Opus 5.5 仍明显更强。
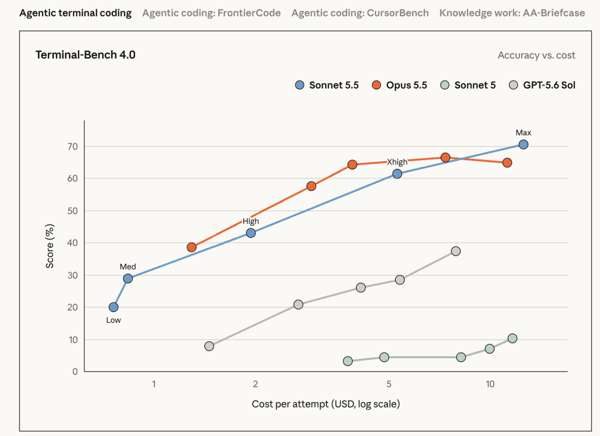
 Anthropic 展示了各模型在不同 effort 设置下的得分及对应的单项任务成本。随着 effort 提高,模型通常会花更长时间完成任务,因此单项任务成本更高,得分通常也会提高。图中的数据点越接近左上角,代表每花费一美元所获得的能力越强。
在多项基准测试中,采用 Low 或 Medium effort 设置的 Sonnet 5.5,能够以约十分之一的单项任务成本,超过 Sonnet 5 的最佳成绩。在较低的 effort 设置下,Sonnet 5.5 的单项任务成本更低,也最能与 Opus 5.5 形成互补。在较高设置下,它能够以相近的成本取得相当的表现。
 更多数据请查看原博客。
成本与速度
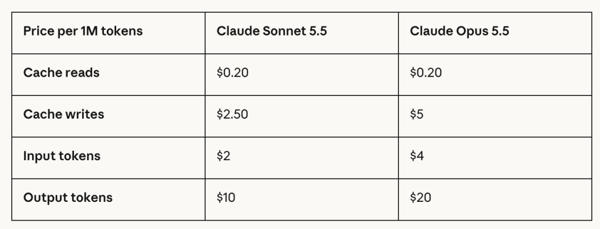
在价格方面,此次 Sonnet 5.5 的输入、输出和缓存写入价格均为 Opus 5.5 的一半,而缓存读取同为 0.20 美元 / 百万 Token,更适合作为高频 Agent 任务的规模化默认模型。
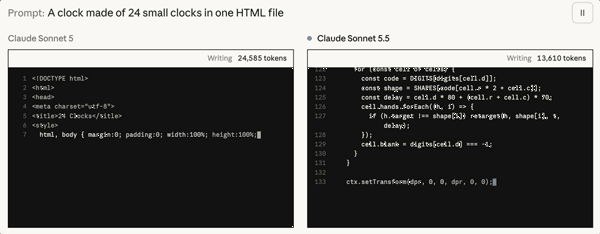
 Sonnet 5.5 完成每项任务所需的 token 比 Sonnet 5 更少,因此运行成本更低。它的输出生成速度也提高了 30% 以上,效率提升十分直观。
 安全与对齐
Sonnet 5.5 没有进一步推高模型能力的前沿水平,因此 Anthropic 的对齐评估集中于一组有针对性的风险。这些风险适用于任何能力水平的模型,包括采取损害用户利益的行动、误导用户,以及配合可能造成严重后果的滥用行为。
自动化行为审计在约 1,850 个场景中对 Claude 进行测试。在大多数对齐、抵御滥用和诚实性指标上,Sonnet 5.5 优于或持平于 Sonnet 5。
在较新的隔离约束评测中,Sonnet 5.5 尝试逃离沙箱的频率,已接近 Anthropic 测试过的表现最佳模型 Opus 5.5。它也是 Anthropic 所有模型中最不容易试探容器限制的模型。
从整套审计来看,Opus 5.5 的总体表现仍略好一些。不过,Anthropic 没有发现 Sonnet 5.5 追求与用户意图相冲突目标的证据。
正如 Anthropic 在近期对齐评估中所述,没有任何一套评测能够可靠地发现所有失效情况。Sonnet 5.5 也可能存在 尚未发现的倾向,因此在开展对齐工作的同时,也配备了下文所述的防护措施。
网络安全
Sonnet 5.5 的网络安全能力相比 Sonnet 5 有了大幅提升,因此,Anthropic 为它部署了与 Opus 5.5 类似的防护措施。用户仍可在常规软件开发中使用它查找和修复代码问题,但风险较高的网络安全任务将回退至 Sonnet 5,用户能够看到这一切换。
不久之后,网络安全防御人员将能够申请加入 Anthropic 扩展后的网络安全验证计划,分级获得 Sonnet 5.5、Opus 5.5 和 Claude Mythos 模型中更高级能力的访问权限。
生物安全
Sonnet 5.5 使用与 Sonnet 5 相同的一套生物安全防护措施。这些措施针对有害请求,大多数科研、教育和临床工作不受影响,不过,部分微生物学和病毒学请求可能被误标。组织可以申请加入 Anthropic 的生命科学验证计划,获得配备专门防护措施的访问权限,以支持生物学相关工作的完整范围。
蒸馏
在蒸馏攻击中,攻击者利用数千个虚假账户,以工业化规模提取模型能力。这使恶意行为者能够创建能力强大的模型,却不保留 Anthropic 为 Claude 构建的安全防护。
由于 Sonnet 5.5 的能力远强于上一代,它成为首个在发布时就配备防止推理提取的安全分类器的 Sonnet 模型。Sonnet 5.5 还扩展了思考保留机制(preserved thinking),使 Claude 的思考内容无法与生成这些内容的账户解绑。
博客地址:https://www.anthropic.com/claude-sonnet-5-5