
对话西湖大学于开丞:通用语言模型再强,物理世界也「等不起」
 2023 年就下场做世界模型的先行者。
作者丨 幸丽娟
编辑丨 岑 峰
2026 年 9 月,机器人操作评测基准 RoboDojo-Sim 的榜单上出现了一个令人意外的名字:GPT-6 Astra。
这个语言模型没有为机器人做任何专项训练,就在 42 项操作任务上拿下平均成功率第一,反超 40 个公开机器人策略。
世界模型这张牌桌,被搅了局 。“语言模型是不是连世界模型的活都能干了?”这个问题被重新摆上桌面。
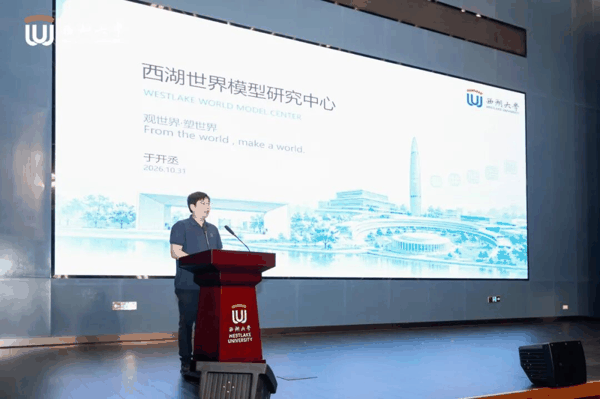
一个多月后,西湖大学宣布成立西湖世界模型研究中心,校长施一公亲自站台。
这所以创新机制闻名的研究型大学,在“世界模型还有没有必要”的质疑声中,把世界模型立成了校级交叉科研平台。推动这件事的人,叫于开丞,西湖大学工学院助理教授、自主智能实验室(AutoLab)负责人。
在他看来, 通用语言模型再强,物理世界也“等不起” 。语言模型根本无法直接替代世界模型。
 他曾在瑞士洛桑联邦理工大学(EPFL)跟 几何视觉大牛 Pascal Fua 做了五年研究,博二那年就“抓出”了 NAS 行业级核心问题 并拿下高通创新基金,当年欧洲获奖者仅四位。
回国后他加入阿里巴巴达摩院,以 BEVFusion 等系列工作在自动驾驶圈成名。两年后,他因自动驾驶领域的一个现实困境,靠着研究直觉转向世界模型。
当时,Sora 还有一年才登场, 世界模型这个词鲜有人能看懂,以探索前沿著称的达摩院都接不住 。
于是,他把这个题目拿回学术界来做,在西湖大学的科研土壤上,一做就是三年。
2024年,在大语言模型最锣鼓喧天的那一年,他在 ECCV 的挑战赛上 用世界模型 pk 掉语言模型 ,拿下“全球冠军”,先一步论证了世界模型路线的可行性。
两年后,锣鼓喧天的主角,终于变成了世界模型。各路团队拿着技术概念,忙着融资。
而已在这个方向耕耘三年的于开丞,没有去追概念的热闹 。 在他眼里, 世界模型就是一个像Transformer 一样的通用技术。 他要做的,是在国内赛道拉满“一圆桌的人”,去跟欧美 AI 力量打擂台。
他要做的这件事,是有底气的。通用世界模型 Awomo-0.5,40 亿参数,在具身智能、物理世界理解等六个国际主流评测榜单上同时登顶, 代码和权重全部开源 。大多数创业公司还交不了卷, 这份“以小博大”的答卷 先交了出来。
开源链接: https://awomo-westlakedi.github.io/Awomo-0.5-page/
为什么三年前世界模型赛道荒无人烟的时候就已经先出发?为什么他认定世界模型 100% 值得做?于开丞在与 AI 科技评论的这次谈话中,给出了他最本质的回答。
以下是对话实录,AI科技评论进行了不改变原意的删改。
 01
起点:自动驾驶的钱,花不动了
▎ AI 科技评论:你 2023 年就开始做世界模型了。但那个时候 Sora 还没出现,"世界模型"几乎是一个无人提及的词。你是基于怎样的契机,把研究转到这个方向上的?
于开丞: 契机来自 自动驾驶的一个现实困境:上限变低,成本很高。
每碰到一个新场景,就得重新收集一遍数据、再走一遍流程。这件事太不优雅,也就是太贵。既然这么贵,就必须找一条新的技术路径。我们是从这个痛点出发,开始注意世界模型的。
当时 diffusion 模型在图片生成上已经跑通,我们自然而然地想到: 既然图片上能做生成,物理空间为什么不能? 于是我们就从生成符合 3D 关系的场景图像,推进到生成符合 3D 关系的场景视频。
这里 3D 是关键 :2D 生成只要“看着像”,但 物理世界要的是“真的像” ,要满足严丝合缝的投影关系和物理关系。
沿着这个逻辑往后推进,我们发现还有很多值得研究的工作。这就是我们从自动驾驶切入世界模型的起点。
▎ AI 科技评论:你在达摩院就已经开始切入这个方向了?
于开丞: 对,在达摩院已经有了雏形。但后来达摩院,或者说整个阿里集团,觉得有点太烧钱,要收缩,就不再做一些特别探索性的研究了。
后来我想想也很有道理:这种非常探索性的研究,可能还是要到高校去做。
▎ AI 科技评论:所以你是因为要做世界模型,才离开产业回归学术界,那为什么去了西湖大学?
于开丞: 是机缘巧合,也是方向使然。当时我有两个选择,最后选择了西湖大学,两个原因:一是这边的氛围和对创新的认可非常吸引我,加入以后,学校也确实给了我们很大的支持;二是施一公校长的精气神,也非常打动我。
在创新的机构做创新的事情,是非常幸运的。比如现在 学校允许我以产、学双栖的状态,去成立西湖大学世界模型中心 ,其实在学校历史上都是有突破性意义的。对我而言是莫大的荣幸,我也身负很重的责任感,去把这件事情做得更好。
▎ AI 科技评论:在那个时期选择这样一个充满未知的方向,会有犹豫吗?
于开丞: 当时世界模型还没人做,我们属于勇闯无人区了。但我们的判断很简单:没人做的时候先做,并且能把技术做到领先,就可能一直领先下去。
现在这个研究方向被大家认识、被社会认可,我们当然非常开心,但在我们的视角里,这就是一步一个脚印走出来的,看着没那么玄幻。
▎ AI 科技评论:你曾公开提及,2024 年在 ECCV 上参加了一个比赛,拿了“世界模型的世界冠军”。当时是比赛本身与世界模型相关,还是你用了世界模型参赛?
于开丞: 是我们用了世界模型参赛。这个挑战赛是华为举办的,主题是“极端场景生成”,用生成模型去合成驾驶场景下没见过的事故场景。
我们用世界模型的技术方案拿到了冠军,其他参赛方案基本没有世界模型。所以在当下那个时间节点上,我们算是抢占了先机。
▎ AI 科技评论:“世界模型”突然就变得这么火了,火起来的这个时间点,比您预想的提前了还是延后了?
于开丞: 肯定比我想的要更靠前一些。我们2023 到 2025 年是在默默做研究,2026 年我们觉得这个事情可以去扩大、“敲锣打鼓”地做的时候,大家就已经一拥而上了。
这其实也代表了大家对这个领域的期待,我也特别理解,因为语言模型之后,最大的一个机会就在世界模型赛道上。
02
对的事,才值得做:
世界模型 100%有价值
▎ AI 科技评论:2023 到 2026 年之间,你有没有遇到过不太清楚前方路的时候?或者有想转研究方向的冲动?
于开丞: 语言模型很火的时候,很多人会想:语言模型这么火,是不是该转去做语言模型?
诱惑很大,但我们还是坚持住了本心。背后的逻辑在于:
一是 擅长与不擅长 的问题。语言模型不是我们最擅长的,CV 才是我们能够游刃有余的技术领域。
二是 价值归属 的问题。语言模型肯定非常有价值,但那个价值很多人都在跟,参与感肯定不会太强了;但世界模型,我坚信未来100%有价值,并且这个赛道需要人来做,我也相信自己能做好。
再往深一层看,还有一个 生态位问题 。不管当时还是现在,初创公司在世界模型这个赛道里,是有机会冲出来的;而大语言模型要烧更多算力、需要更多的资金去推动,这更多是大厂干的事。
但最底层的思路还是: 对的事情,才值得做 。如果大语言模型是唯一对的事,那无论起步多晚都必须做。但我认为,大语言模型并不唯一,世界模型同样也是对的事。
▎ AI 科技评论:怎么评估世界模型一定是对的事?
于开丞:首先,语言模型无法走出屏幕,但世界模型可以。
语言模型再好,也仍需人来操作。将来我们要上火星,要去高山、深海和各种危险场景,许多地方人不擅长去、也不适合去,总归需要一个东西替人去。否则就只能以人力替代,而这并不人道。
其次, 从技术路径看,世界模型与语言模型并不共通,需要更多的科研力量投入进来。
语言模型从文字构建出发,基础是语言文字。语言文字是抽象的,是一个已经被压缩过的世界。它同世界模型所面对的连续物理世界,是完全不同的两回事,技术上也并不容易共通。看起来都叫模型,实则千差万别。
而且,世界模型本身还有多条路线:3D 是一个方向,影视是一个方向,各条路线之间的打通并不容易。倘若容易,世界上就只会有一家公司了。这也说明, 世界模型这个研究方向充满了可探索的空间和可能性 。
所以从底层逻辑上讲, 世界模型 100% 有价值。 那为什么不做?那为什么不在别人还没看到这个方向的时候,我们就早早地去做?
03
“世界模型”这个词,
要从目的定义,别乱加定语
▎ AI 科技评论:这个赛道现在定义都还不统一,如果要你这位资深的世界模型学者给它一个定义,你会怎么定义?
于开丞: 首先,从本质上来看, 世界模型是一项像 Transformer 一样的通用技术。 目前大家已经有的一个 共识是:它能够预测下一个状态。
其次,应该从目的出发来进行定义,而不是先堆定语。如果脱离场景去谈技术本身,是没有意义的。 一项技术只有绑定具体的目标领域,才存在适配与否的问题。
语言模型适合的建模方式,不见得适用世界模型;语言模型所擅长的机制,例如 KV cache,在世界模型架构下未必同样有效。
所以,我的定义是: 世界模型,是指面向连续物理空间事件、以预测下一个状态为目的的模型 。其底层采用以扩散模型为基底的 Transformer 架构(DiT),并叠加对未来的预测机制。
进一步从目的来看, 一类是给人看 ,比如 Seedance 这种通用视频生成,强调人眼的体验感; 另一类是给机器人用 ,那就需要有绝对意义的物理真实性。
行业也有一些非常离谱的定义,比如把 ICL 说成世界模型。ICL 是一个模型默认具有的能力,把它拿出来单独说就没意思了。
▎ AI 科技评论:所以,在你看来,视频生成模型也是世界模型?此前我们的受访者提到过,“预测下一个动作”是世界模型的必要条件,而视频生成模型不预测下一个动作。
于开丞: 我们先从共识来看,世界模型预测的是下一个状态,而 “状态”可以定义得很宽,甚至可以把人的心理状态定义为一种状态 ,这也符合世界模型的本质。只是我们会强调,我们做的是物理世界模型,更希望它在物理世界中理解行动。
但就世界模型的定义而言,“动作”不是必要条件 。举个例子:家里要做装修设计,可以找装修队,但你得理解空间、理解逻辑、理解我的需求,这也是一种理解。所以物理世界模型不见得一定要有动作。
这是世界模型和具身智能放在一起谈以后,产生的一个误区。而实际上, 具身智能是一个落地场景;而世界模型是一项通用技术,两者不能混为一谈。
正如刚才提到的,判断一个世界模型的真假,需要看它为了什么目的,做了什么技术取舍。
给人看的那一类,不在乎真不真。比如把杯子扔出去、 它掉下来,只要有扔上去、掉下来的动作就行。很多学术文章已经证明,生成的内容并不符合物理定律,但没人在意。只要不出现没手、五个手指变成六个这种明显反直觉的错误,就过得去;至于手能不能以很怪的角度捏过来,人在视频里看到也不会介意。
此外,还有一些漫画、动漫相关的内容,模型甚至为了让人看得爽,会加入反直觉的物理特效,训练数据里也混杂了大量这类反直觉特效。
另一类需要到物理世界去用的,比如我们做的隐空间物理世界模型,错了就是错了,对了就是对了,追求的是动作的准确性和任务完成度。
04
路线之争:基因决定取舍
▎ AI科技评论:行业头部研究者正在出现技术路线分化。你提到的隐空间,是Yann LeCun主张的一条路线;此外还有李飞飞的空间智能、英伟达的物理仿真。你如何看待这种划分?
于开丞 : 路线要锚定到各自要解决的问题本身。他们的路线划分最大的原因,在于各自的目标不同。
此前我们与 Yann LeCun 有过一次交流。他的目标就是 物理理解与物理操作 ,走的是“把世界压缩成抽象表示”的模型路线;李飞飞团队做的是空间智能,产品落地场景包括 游戏和虚拟资产 ,这从一开始就是她明确的目标方向。
英伟达则不同。它的目标就是 卖卡 。既然卖卡,就必然围绕计算来做文章,也就是在 Omniverse 里通过计算产生各类求解器,做成物理仿真器。它做这件事的价值,就在于:物理仿真背后是渲染,是建立在 GPU 上的大规模管线单元利用,而这正是英伟达最擅长的事。
所以,路线分化本质上是由基因决定的:目标不同,取舍就不同,路线也就不同。
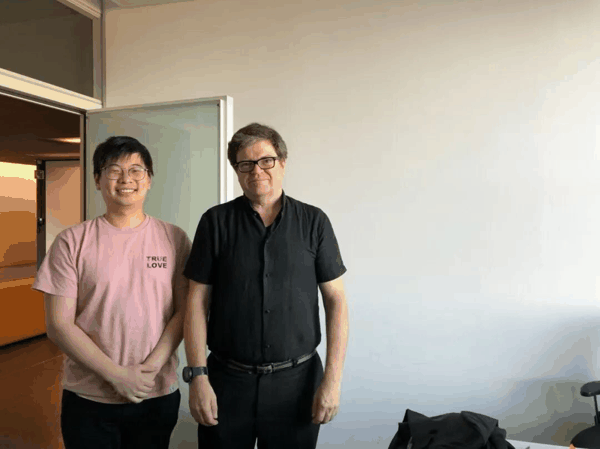 于开丞与 Yann LeCun 的合照(照片由受访者提供)
▎ AI科技评论:你与Yann LeCun 同属隐空间路线。他经常公开批评像素路线,你是否认同?
于开丞 :我精神上高度认同他,因为我自己此前也走的像素生成路线,后来 又亲自把像素路线否定了 ,换到隐空间路线。
在隐空间路线上,我们隐空间物理世界模型在具身智能、物理世界理解等六个国际主流评测榜单上拿下了评测第一,这些成绩确实能够证明这条技术路线是有用的。换句话说,这不仅仅是“我相信这个赛道”的信念问题,是通过实实在在的成绩证明了它的有效性。
但对于他的具体技术架构本身是否值得跟进,我持谨慎态度,并且也在持续关注他们的进展。
▎ AI科技评论:在你看来,隐空间路线的优越性体现在哪里?
于开丞 :隐空间,是指把连续的视觉信息压缩到语义空间去理解和推理。
首先,这条路线可以 借助语言模型的发展 。语言模型训练了大量语料库,产生了一套很好的“价值分离器”。它已经把很多人的知识在最底层逻辑上分得很好了。
我们做世界模型时,一定要继承这套分离机制,让它与语言模型形成上下握手的连接,帮助底层的世界模型更好地训练。如果没有语言模型、只训世界模型,难度可能会变成 100 倍、1 万倍。
其次,如果我们把小猫、小狗的大脑当作一个世界模型,它们看懂世界,也能预测未来,还能做出判断和行动。那我们如何控制它,并且让它准确地满足我们的期待呢,那就需要用到语言。我们需要 用精准语言告诉它,想让它做什么。
▎ AI科技评论:关于准确性问题,我有一个疑问,比如说机械臂分拣回形针这个场景,是不是需要足够高清的像素来做区分,语义空间会不会让它无法分辨回形针?
于开丞 :隐空间的 输入同样可以是高清的像素 ,只不过理解和推理是在语义空间进行的。它的语义理解是绑定了物理实体的:机械臂能看到一段关于回形针的高清视频,语义层将其识别为回形针;但并不意味着识别之后,就把像素信息全部丢弃,只保留“回形针”三个字。 这个语义概念一定是与一个物理现象的概念绑定的。
我们再以“猫”、“狗”打比方。语言模型已经通过大规模语料,为文字建立了一套清晰的向量化逻辑关系:“猫”与“狗”在语义空间中距离较近,因为同属动物;“猫”与“筷子”则相距较远。
把这种语义结构引入世界模型作为引导,价值很大,否则世界模型就得同时从零学这两件事: 既要在视觉上分清猫狗,又要从零学会“猫”“狗”这两个字怎么写 。相当于需要同时处理多项任务,难度自然陡增。
“猫”和“狗”两个概念早已在人类课本里写得清清楚楚,老师教孩子会直接告诉他“这是猫、那是狗”。而一个无人告知“什么是什么”的原始人,同样能看见猫、看见狗,却没有任何人告诉他这些分别是什么。两者认知世界的速度,完全不可同日而语。
▎ AI科技评论:Yann LeCun 那条纯隐空间路线有一个已知问题叫“表征坍塌”。你们结合了显式的视频生成框架,是否也会遇到?怎么防止?
于开丞 :相对来讲好一些,但训练量不够大的时候,也会遇到。因此,我们一方面持续 扩大训练规模 ,另一方面 引入文字信息作为 caption 约束 ,以抑制表征坍塌,这相当于用“脚手架”把它支起来。
如果没有任何外部约束、让模型完全自行学习,表征很容易坍塌。一旦坍塌,模型就失效了,无法正常工作;只要 loss 正常下降,模型就没有问题。
▎ AI科技评论:你的技术路线引入了“可组合的物理概念”。李飞飞空间智能路线的核心研究者之一、斯坦福助理教授吴佳俊,也有给空间理解推理引入物理先验的工作。你们的做法和吴佳俊有什么区别吗?
于开丞 :我们的思路本质上是一致的,都是 给空间理解引入物理先验 。我认为这个方向是正确的,而且我跟佳俊也熟,他很有使命感,带的团队确实优秀:在华人学者中,他带的学生质量,应该是数一数二的。
此外,跟我们路线相同的还有一位徐丹飞,他做了一个组合式世界模型( compositional world model),在 RSS 2026 上还做了成果展示。
这就是 英雄所见略同 。这个方法思路,我们定得更早,也不比他们差,我们该怎么做就还是怎么做。而这些优秀团队选择这个方向,也给我们提供了一些信心和交叉支持。