
EMNLP 2026|大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。推测解码(Speculative Decoding, SD)通过引入一个更轻量的 draft model 预先生成候选 token,再由 target model 对这些候选进行并行验证,从而减少昂贵的 target model 前向计算次数,已成为加速大语言模型推理的重要技术路线。
但现有方法通常沿着两条路线分别优化:一类通过生成多个 draft sequence 扩大候选空间,另一类通过 block verification 一次验证更长的 token block。前者提高 “能找到可接受候选” 的机会,后者提高 “一次能接受多长” 的上限,但二者长期被分开设计。
团队提出 SpecTr-GBV ,将 multi-draft 与 greedy block verification(GBV)统一进同一个推测解码框架。它把多条 draft token blocks 与 target token block 的验证写成最优传输问题,在保持输出分布一致性的同时,追求更长的期望接受长度。
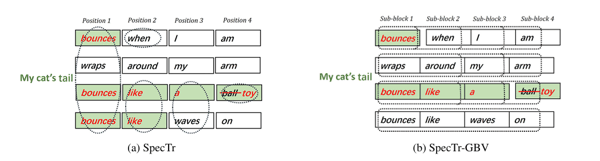 SpecTr(NeurIPS2023)与本文 SpecTr-GBV 的验证机制示意图。SpecTr 采用逐位置验证策略,在每个位置接受一个 token 并保留与其一致的 draft sequences;相比之下,SpecTr-GBV 以 sub-block 为单位进行联合验证,并在多条 draft sequences 中搜索并保留最长的可接受子块。
 论文标题:SpecTr-GBV: Multi-Draft Block Verification Accelerating Speculative Decoding
作者:Yijun Lin、Jinhao Sheng、Qingyue Cai、Feng Zhou
机构:Center for Applied Statistics and School of Statistics, Renmin University of China;School of Intelligent Medicine, China Medical University
研究主题:大语言模型推理加速、推测解码、多草稿验证、块验证、最优传输
OpenReview 链接: https://openreview.net/forum?id=4BZ8R9wHhy
为什么重新设计推测解码的 “验证” 环节?
标准推测解码的基本思路是小模型先生成一段长度为 L 的草稿,目标模型一次前向计算得到对应位置的真实条件分布,再通过 rejection sampling 依次决定草稿 token 是否可以被接受。只要某个位置首次被拒绝,后续 token 通常就会被丢弃。
这种机制虽然避免了目标模型逐 token 调用,但也带来一个直接瓶颈:一次 speculative iteration 最终能保留下来的 token 数量,受限于草稿序列与目标分布的匹配程度。只要前面某一处失败,后面的潜在正确 token 也很难继续发挥作用。为了进一步提升草稿序列与目标分布的匹配程度,可以将验证方式从逐 token 匹配扩展为多 token 的块级匹配,从而更充分地利用草稿序列中的候选信息。
已有路线:更多草稿,或者更聪明地验证
第一条路线是 multi-draft。以 SpecTr 为代表的方法,会从 draft model 生成 K 条独立草稿序列。在每一个位置上,它利用最优传输构造 draft 分布与 target 分布之间的 coupling,从 K 个候选 token 中寻找可接受者。随着 K 增大,“至少有一个候选可被接受” 的概率会提高。
第二条路线是 block verification。GBV 不再逐 token 独立判断,而是在 single-draft setting 下把前缀子块作为整体进行验证,并证明能够达到单次迭代中最优的期望接受 token 数。
问题在于:multi-draft 解决 “候选够不够多”,block verification 解决 “能不能一次接受得更长”。如何能把它们统一起来?
SpecTr-GBV 的核心:最优传输问题同时解决 “多草稿” 和 “长块验证”
SpecTr-GBV 从 K 条 i.i.d. draft sequences 出发,每条长度为 L。与 SpecTr 按位置逐列做验证不同,它把每条草稿的不同前缀都视为候选 sub-block,并围绕 “最终能够与 target sequence 匹配到多长” 来定义 acceptance length。
对给定的多条 draft sequence 与 target sequence,论文把 acceptance length 定义为:存在至少一条 draft,其长度为 i 的前缀与 target 的长度为 i 的前缀完全一致时,可以接受到位置 i;最终取最大的 i。于是,验证目标不再是单独最大化某一个位置的接受概率,而是直接最大化整个 block 的期望接受长度。
直观地说,SpecTr-GBV 研究 “在多条草稿里,哪一条能尽可能长地按照 target distribution 一次走下去”。
第一步:构造多草稿 block 与 target block 的 coupling
论文将验证写成一个 optimal transport optimization:在保持 draft marginal 与 target marginal 不变的前提下,寻找使期望 acceptance length 最大的 coupling。由于 K 条草稿由 draft model 独立生成,作者进一步考虑条件独立性下(conditionally independent couplings ,CIC)的耦合,以对应算法中的多草稿验证不进行联合适应的结构。
第二步:逐条草稿做 greedy block verification
算法层面,SpecTr-GBV 依次处理多条 draft sequence。对每条草稿,它从短前缀到长前缀进行 block-level verification,并保留能够通过验证的最长 sub-block。如果当前草稿没有带来更长的可接受前缀,就继续检查下一条草稿;最终选择所有草稿中接受长度最长的 block。
第三步:用 residual distribution 补上下一 token
当最长可接受 block 没有覆盖完整长度 L 时,算法会在其后从 residual distribution 中采样一个 token;若长度 L 全部接受,则再从 target model 生成一个额外 token。与此同时,未接受位置的 target distribution 会在进入下一轮 speculative iteration 前做相应修正,以保证跨轮次的输出分布一致性。
理论结果:SD 更优接受率
SpecTr-GBV 的一个重点不是只做经验上的组合,而是给出与其多草稿验证结构相匹配的理论上界。论文首先推导了在 CIC 类中任意 coupling 的期望 acceptance length 上界,并证明这个上界具有三个关键性质。
单调性 :draft 数 K 增加时,上界严格增大。更多独立草稿能够扩大至少一条路径与 target 前缀匹配的机会。
收敛性 :当 K 趋于无穷时,该上界趋近于最大 block 长度 L。
一致性 :当 K=1 时,上界退化为 single-draft setting,对应 GBV。
更进一步,论文证明 SpecTr-GBV 能够达到上述上界。因此,在作者定义的 conditionally independent couplings 类中,对于固定的 K,SpecTr-GBV 实现了最优的期望接受长度,且该最优值还会随着 K 增大而上升。
实验结果与分析
论文在五个数据集上进行评估:HumanEval(Python 代码)、GSM8K(小学数学)、MGSM(多语言数学)、LM1B(语言建模)与 Alpaca(指令遵循)。比较方法包括 Autoregressive Decoding(AR)、标准 Speculative Decoding(SD)、SpecTr 和 GBV。
评测同时报告两个指标:Block Efficiency(BE)表示每次 target model 串行调用平均能解码多少 token;Speedup Ratio(SR)直接用 AR 的 wall-clock time 除以当前方法耗时,衡量端到端实际加速。
主实验结果:在 DeepSeek-33B/1.3B 与 DeepSeek-6.7B/1.3B 两种 target-draft 配置下,SpecTr-GBV 在五个任务上均表现出更高的 block efficiency 与 speedup。
论文特别区分了算法层面的 block efficiency 与真实系统的 wall-clock speedup。BE 只关注每次串行 target call 能 “带走” 多少 token,而实际耗时还包括 draft model 生成候选的开销,以及 target model 在 batch verification 时产生的额外延迟。因此 SR 通常小于 BE,这是推测解码系统中一个必须面对的工程现实。
主题:推测解码|SpecTr-GBV|最优传输