
AdaRoboVLG:适用于不同机械手的任务自适应视觉语言抓取框架
同样是一只杯子,机器人到底应该抓哪里?
如果任务是把水倒进水槽,握住杯柄通常更合适;如果要把杯子递给别人,机器人最好把杯柄留给对方;如果杯子还在传送带上移动,抓取位置又必须随时间不断更新。周围堆放的杂物、目标遮挡和不同机械手的结构差异,又让一个看似简单的「伸手拿杯子」,变成空间、语义与动态控制交织的问题。
视觉 — 语言抓取(Vision-Language-Grasping,VLG)的目标,正是让机器人根据自然语言和具体情境,做出符合任务意图的抓取。这需要同时处理空间、认知、时序与本体四类挑战:找准目标并避开碰撞,理解物体用途,追踪持续变化的状态,还要适应不同机械手。
当前不少 VLG 方法采用端到端路线,直接将视觉观察和语言指令映射为抓取动作。这类策略的适应能力往往受训练数据与机械手配置限制;面对新的任务情境与本体,通常需要补充数据或重新训练。
来自华中科技大学、北京大学、擎朗智能等机构的研究者提出了 AdaRoboVLG 。该框架将「任务需要怎样抓」与「机械手如何稳定抓取」解耦,并用统一的抓取接口连接任务理解与物理抓取合成:上层把任务情境转化为抓取约束,下层据此为不同机械手生成稳定姿态。由此,新能力可以接入同一抓取底座,形成一条 可扩展的机器人抓取(scalable robotic grasping) 的路线。
 标题: Adaptive Vision-Language Grasping via Composable Foundation Priors and Generalizable Grasp Synthesis
作者: Sixu Yan, Shikang Wang, Binhua Huang, Xuanlai Tang, Guohua Fan, Fan Huang, Haoxuan Li, Yongkang Li, Yuhan Li, Bencheng Liao, Zeyu Zhang, Wenyu Liu, Hangxin Liu, Xinggang Wang
论文: https://arxiv.org/abs/2609.04096
主页:https://adarobovlg.github.io/
代码:https://github.com/AdaRoboVLG/AdaRoboVLG
仿真:https://github.com/AdaRoboVLG/AdaRoboVLG-Playground
01 把理解与抓取拆开,
让同一底座服务不同机械手
人类之所以能在遮挡、功能需求和目标运动等挑战同时出现时灵活调整抓取,并不是因为经历过每一种可能的情形,而是会调用由常识和过往经验形成的丰富先验,协同完成感知、推理与动作控制。基础模型在视觉识别、空间理解、功能推理和目标跟踪等方面展现出与这些先验相似的能力。受此启发,AdaRoboVLG 将基础模型提供的先验转化为可组合的抓取约束,再交给可跨机械手复用的基础策略,生成符合任务意图且物理可行的抓取姿态。
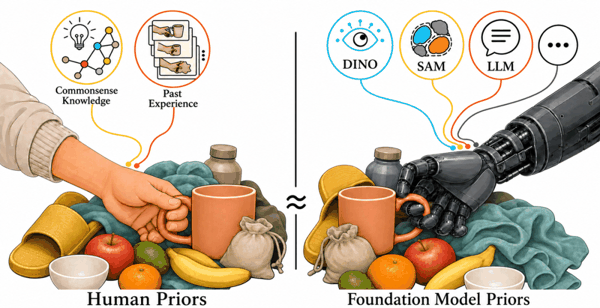 人类利用常识与经验调整抓取;机器人组合视觉、分割与语言模型先验 抓取约束被定义为一组 统一的抓取接口 ,它由目标物体几何、接触抓取表示(Contact Grasp Representation,CGR)和与机械手兼容的抓取类型组成。CGR 描述接触位置、概率、接近与闭合方向以及抓取宽度;抓取类型来自人类抓取分类,并依据机械手的运动能力进行筛选。
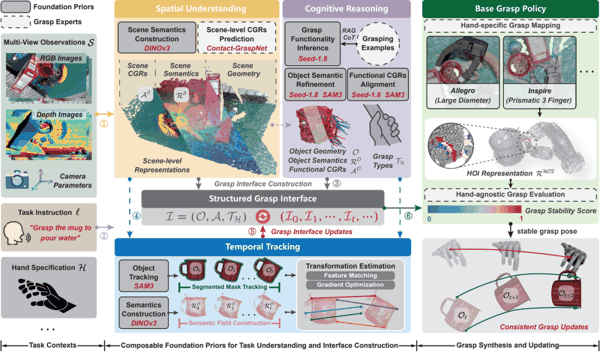 AdaRoboVLG 总体框架:可组合先验通过结构化接口连接基础抓取策略 基础策略先根据 CGR 和抓取类型,为具体机械手生成候选;再由共享模型进行稳定性评分。评分采用的手 — 物交互表示(Hand-Object Interaction Representation,HOI)编码接触点的位置、法向等局部几何信息,为力闭合相关的稳定性预测提供依据。不同机械手按自身结构生成候选,共享模型负责评分;接入新机械手时,只需配置对应的运动学映射和兼容抓取类型。
研究团队在 Isaac Sim 中使用 DH3、Allegro、Inspire 三种机械手,采集了 440 万次带标注的抓取试验, 用于训练基础抓取策略。
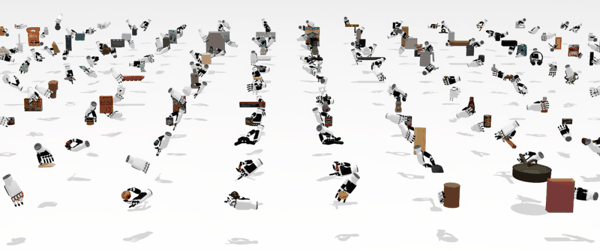 基础策略的仿真数据采集流程 实验一验证了学习效率与跨手预测能力。相比独立编码手与物体,HOI 收敛更快、训练损失更低;三手联合训练的模型在 DH3、Allegro、Inspire 上分别达到 82.95%、88.02%、91.07% 的抓取质量预测准确率。
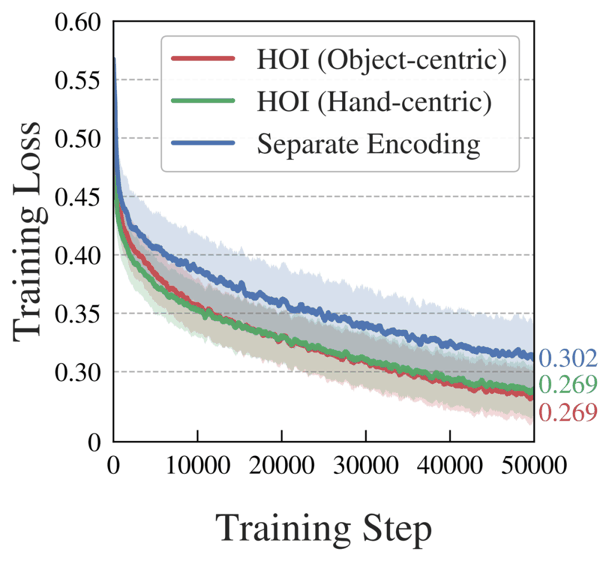
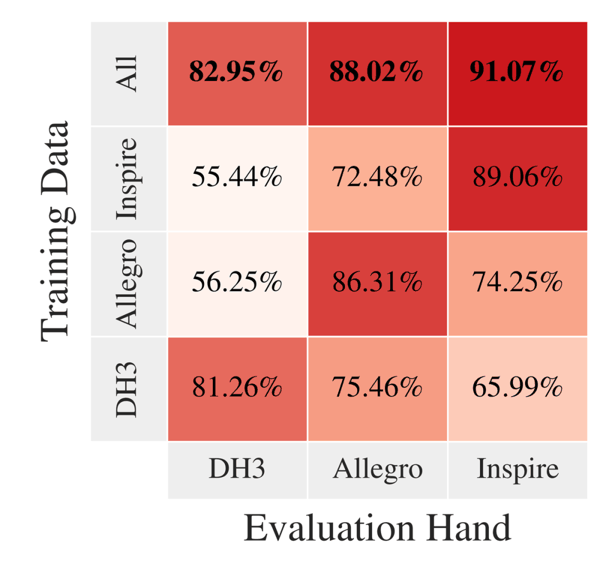 基础策略实验:训练收敛(左)与跨机械手预测准确率(右) 02 三类先验,分别回答
「能不能抓、该怎么抓、如何跟上」
在基础策略之上,空间、认知和时序先验负责把任务情境转成接口约束。实验二至四先分别检查每种能力,为后面的真实系统组合提供依据。
空间先验:杂物之间,机械手能否伸进去?
一个姿态即使能抓牢目标,也可能与周围物体发生碰撞。空间先验利用多视角彩色与深度(RGB-D)观察,将 DINOv3 提取的图像特征提升到三维,形成场景级语义表示;再结合点云,通过 Contact-GraspNet 预测场景级 CGR,为基础策略提供接触候选。
空间先验:DH3、Allegro、Inspire 在六个场景中的抓取可视化。
同一场景中的接触候选,可以根据不同机械手的结构映射为不同姿态。空间模块中的 Contact-GraspNet 在 GraspClutter6D 上训练,随后用于以下基准评测。
在 DexGraspNet 2.0 的三种杂乱程度与三种机械手上,AdaRoboVLG 平均成功率为 88.4% 。它在 Random、Loose 划分上取得表中最佳结果;Dense 划分则仍有对比方法更高。
DexGraspNet 2.0:多指抓取成功率
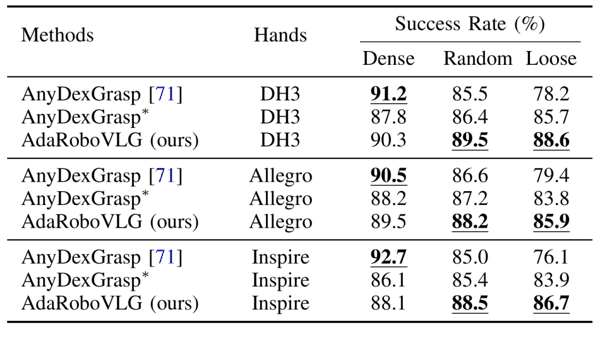
AnyDexGrasp* 保留原候选生成流程,使用本文的共享抓取判别模型评分。
认知先验:先推断功能,再验证目标抓取
功能性抓取既要理解任务需求,也要定位、分割对应部位,生成物理可行的抓取姿态。论文通过开放集功能推理与语言引导目标抓取两项互补实验,分别检查推理能力与抓取落地能力。
任务 A:开放集功能推理。 下面展示 16 个物品的功能推理结果:给定任务指令与输入图像,推理出相应的功能部位与抓取类型。
开放集功能推理:16 个物品的部位与手型选择
开放集评测包含 125 组图像 — 指令对、57 种操作任务与 80 类物体。基础 LLM 的功能部位、抓取类型准确率分别为 82% 和 63%;加入 RAG 与 CoT 后提升到 94% 和 87% 。在这组消融实验中,CoT 对功能部位判断的改善更明显,RAG 对抓取类型选择更有帮助。
开放集功能推理消融实验
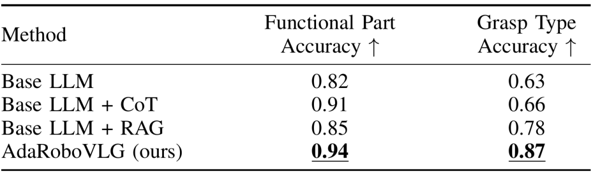
任务 B:语言引导的目标抓取。 在相同认知模块提供的目标定位与分割结果下,比较各方法能否生成成功抓起目标的姿态。
语言引导的目标抓取:Allegro 四指机械手。
AdaRoboVLG 在 GraspClutter6D 和 GraspNet-1Billion 上的三手平均成功率分别为 81.3% 和 86.0% ,在表中两组基准、三种机械手上均取得最高成功率。
语言引导目标抓取:两个数据集、三种机械手
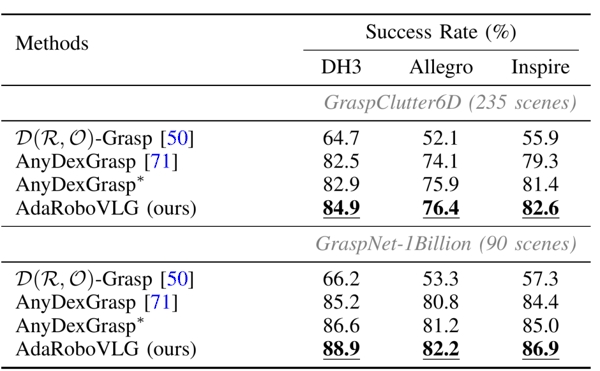
各方法使用相同的认知推理模块;AnyDexGrasp* 保留原候选生成流程,使用本文的共享抓取判别模型评分。
时序先验:目标移动后,抓取接口持续更新
静态场景中算出的好姿态,可能在目标移动后迅速失效。时序先验结合 SAM3 的掩码跟踪与 DINOv3 的跨帧特征一致性,估计目标刚体运动,并在线更新目标几何和 CGR。该模块本身不需要额外训练。
在 GraspNet-1Billion 的 Seen、Similar、Novel 划分上,AdaRoboVLG 在多抓取跟踪准确率、平移误差和旋转误差三项指标上均处于领先水平。
动态跟踪:Seen / Similar / Novel
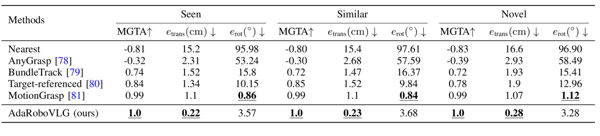 实验结果与长时可视化表明,AdaRoboVLG 在长程抓取跟踪中具有明显优势,能够在目标持续运动时保持稳定关联,并不断更新抓取约束。不过,对称物体仍可能出现旋转漂移,严重遮挡也可能导致跟踪丢失。
03 从静态杂乱到动态干扰:
真机验证组合能力
前面的实验检查了各个环节,真机实验进一步检验它们能否协同工作。实验五从静态杂乱场景出发,先组合空间与认知先验,再加入时序先验处理运动目标;实验六考察新增任务与感知模块后的能力扩展。
找对目标,还要抓对部位(实验五 A)
测试覆盖 102 件日常物体 ,包括食品、家居用品、工具、玩具、电子产品和纺织品。每次试验要求找对目标、满足功能意图、避免碰撞,并将物体抬高 10 cm、保持 5 秒不掉落。系统未进行真实世界微调。
在配备 ROHand 灵巧手的 XMAN-R1 与 TianJi Marvin 平台上,每件物体进行 5 次随机化试验,共 510 次真实抓取 ,总体成功率为 83.3% 。研究团队还将系统部署到平行夹爪,展示其跨末端执行器的适配能力。
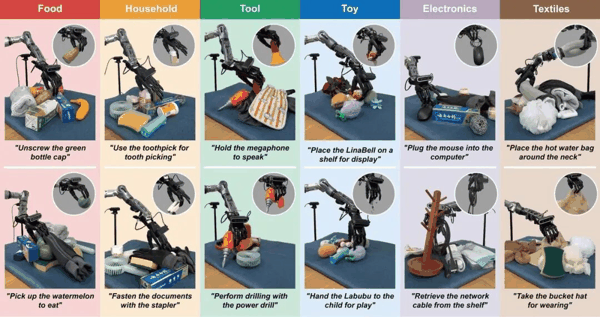 真实杂乱场景中的语言引导功能性抓取 XMAN-R1 + ROHand:真实杂乱场景中的功能性抓取。
TianJi Marvin + ROHand:真实杂乱场景中的功能性抓取。
目标动起来后,抓取如何跟上(实验五 B)
移动传送带让「抓哪里」成为一个随时间变化的问题。实验使用配备 ROHand 的 AgileX Piper,选择 16 件代表性物体,在速度为 2–5 cm/s 的传送带上演示功能性抓取。空间与认知先验构建初始抓取约束,时序先验根据目标运动持续更新,抓取姿态的在线更新频率为 5 Hz 。
下面的六组任务展示了系统如何在目标运动时,保持符合语言意图的抓取方式。
动态传送带:网球、拖鞋、红色麦克风、绿色玩具车、玫瑰、水壶六组任务同步展示。
随后,团队在同一机械臂上使用平行夹爪,测试人为干扰下动态抓取的鲁棒性。面对移出视野恢复、快速移动、连续遮挡、平移与旋转同时发生四类干扰,系统的总抓取成功率为 89.7% 。
四类人为干扰:移出视野恢复、快速移动、持续遮挡、平移与旋转。
接入新模块,扩展任务与感知能力(实验六)
加入任务分配模块后,AdaRoboVLG 能进行双臂分拣;接入深度补全模块后,还能处理透明物体。两种扩展分别改变任务组织与感知输入,均不需要重新训练基础抓取策略。
这两项演示让 scalable 有了具体含义:新能力不必全部写进同一个策略,而可以通过模块接入,由已有抓取底座承接,为扩展任务与感知能力提供了一条可行路径。
双臂协同分拣
04 不只做大模型,更要让抓取能力可扩展
AdaRoboVLG 的价值不仅在于单项成功率,更在于让 任务自适应、策略可复用、本体可适配 。结构化接口将任务约束与物理抓取衔接起来,也为后续接入更强的感知与推理模型留下了空间。
从更广义的系统视角看,机器人能力的 Scaling 不只取决于模型规模,更依赖感知、推理、技能与本体之间的协同。AdaRoboVLG 将基础模型先验、可复用抓取技能与不同机械手连接起来,展示了通过能力组合推动机器人能力扩展的思路。
模块化仍有边界。上层若识别错功能部位,底层可能生成稳定却不符合用途的抓取;多视角定位不一致、深度重建噪声和缺少触觉反馈,也会限制可靠性。触觉闭环,以及严重遮挡下的推、拨等预操作,仍是未来方向。
从不同机械手到静态、动态真实场景,AdaRoboVLG 为可扩展机器人抓取提供了一个具体范例。这种将任务理解与物理抓取解耦的设计,有望让基础模型的持续进步更高效地转化为机器人能力,为面向多样任务与本体的机器人系统开辟新的发展空间。
主题:抓取