
全球公开做预训练RSI的仅两家:一家在40亿美元公司,一家在801教室
超智能这场竞赛的胜负手不在后训练,而在谁先跑通 RSI 预训练。
负责人表示:预训练和后训练不是一个量级的事:算力、经验、工程,每一样都高出一个数量级。但很不幸,它也是最重要的事,是我们对智能进行加工的第一性基础。正因如此,RSI 必须落到预训练上,智能制造才开始复利:没跑通的一方只能眼看着代差一代代拉大。
一间教室,和一家 40 亿美元的公司
过去一年,「RSI」(Recursive Self-Improvement,递归自我改进)几乎成了大模型圈最热的词:让 AI 自己提出改进、自己执行、自己评估,再在结果之上继续改进,循环往复,越改越强。但如果追问一句:有谁把 RSI 用到了 从零开始的前沿预训练上 ,并且公开了出来?据我们所知,答案只有两个。
一个在美国。Recursive 是一家明星创业公司,创始团队来自 Google、Meta 和 OpenAI,《纽约时报》称其为一项「40 亿美元级」的项目。两周前,他们发布了从零训练的模型 Flint。
另一个在上海的一间教室里。门牌号是 801 ,也是这个模型的名字。
我们是唯一公开全部技术细节的一家。
今天,上海创智学院与新序智能联合 发布首份完整公开的预训练级 RSI 技术报告、base 模型(801-30B)、高质量 SFT 数据。
不只是一次试水:用时不到三个月,这间教室交出的模型,站进了同尺寸开源基座的第一梯队。
技术报告:https://github.com/GAIR-NLP/801-30B/blob/main/report.pdf
模型与数据:https://github.com/GAIR-NLP/801-30B
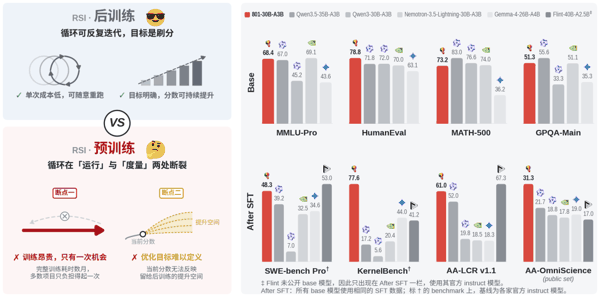 801(红色)与开源模型对比:上排为 base 模型评测,下排为 SFT 后评测(标 † 的评测中,对比模型为厂商发布的完整后训练版本)
为什么要用 RSI 做预训练?
为什么这件事为什么值得做?答案是:RSI 的终点不在后训练,而在预训练。
预训练决定一切能力的上限
一个大模型的知识和推理能力,绝大部分在预训练阶段形成。后训练做的是把这些能力「激发」出来,很难凭空创造出预训练没有给的东西。预训练因此是整条 AI 能力链的源头:之后所有的 agent、应用和产品,都建立在它之上。打个比方:后训练是装修,预训练是盖房子的地基和主体结构。装修再好,也改变不了房子能盖几层。
只有进入预训练,RSI 才真正「递归」
RSI 最根本的想象,是 AI 能够改进制造下一代 AI 的过程,而更强的下一代 AI 又能继续改进再下一代。这个闭环一旦转起来,进步会复利式地加速。但如果 RSI 只停留在后训练,它改进的只是「给一个现成的模型装修」;制造模型最根本的那道工序,仍然完全依赖人。闭环并没有真正闭合。
只有当 RSI 进入预训练,AI 才第一次参与「制造 AI」本身 。这是递归自我改进从「装修」走向「造房子」的一步,也是这条路上最关键、最难的一步。
它会改变基座模型的生产方式
今天,训练一个前沿基座是全世界最稀缺的能力之一:需要大规模的顶尖团队、多年积累却从不公开的踩坑经验、几个月的时间和海量算力。全球能做到的机构屈指可数。RSI 进入预训练,意味着这套高度依赖少数人才、靠人力堆出来的工艺,开始变成由 AI 驱动、可积累、可复制的流程。801 本身就是证据:一支新组建的团队,三个月从零训练出第一梯队的基座。
经验第一次可以复利,而不是随人流失
预训练最宝贵的资产,是「哪些路走不通、为什么走不通」。过去,这些经验存在少数人的脑子里,人一走就没了,这也是前沿实验室最深的护城河。我们把每一次尝试、每一次失败和失败的原因都沉淀进一套共享的「记忆」,让下一轮直接站在上一轮的肩膀上。预训练的 know-how,第一次可以复利增长。
对算力受限的一方尤其关键
在只有一次机会的预训练里,每一个 GPU 小时都不能浪费。让每一次训练、每一次失败都转化为可积累的经验,本质上是在提高单位算力的智能产出。对算力受限的一方来说,这不只是一条技术路线,而是一道必答题。