
为了理解而生成:他们用合成数据教会模型「视频通话」
一、什么是 OmniVChat?
从音视频问答到原生音视频对话
现有的音视频交互的研究中,对 “交互” 的定义往往其实是对音视频内容的问答,比如对于一个流式视频,用户输入一个文本问题,然后模型选择合适的时机回答。这样的交互和日常用户和 AI 的交互范式(比如和 AI 打视频电话)差别很大。
 在这篇文章中,我们把 OmniVChat(Omni Video Chat)定义为 原生的音视频对话:模型直接、同时接收用户音频和视频,无需额外的文本问题、外部字幕或语音识别转写,从而保留语气、停顿、表情和镜头朝向等线索 。比如,用户举着手机,一边拍一边问:“我左边会议室的门开着吗?”,问题藏在语音和画面里,模型需要结合两者理解用户的处境,再给出文本回复。
 作者单位:香港中文大学,Alibaba Token Hub,上海交通大学,上海创智学院,浙江大学
论文标题:
OMNIVCHAT: SYNTHESIZING, BENCHMARKING, AND TRAINING FOR NATIVE AUDIO-VISUAL DIALOGUE
论文链接 (arXiv):https://arxiv.org/abs/2609.21465
Hugging Face 数据集: https://huggingface.co/datasets/Harland/OmniVChat
GitHub 代码: https://github.com/HarlandZZC/OmniVChat
第一作者:何昊林,香港中文大学 DSP LAB 博士;楚云霏,Alibaba Token Hub(ATH)算法科学家,Qwen-Omni 系列核心贡献者;陈琦,上海交通大学 X-LANCE LAB 博士
通讯作者:徐进,Alibaba Token Hub(ATH)算法科学家,Qwen-Omni 系列项目负责人;孔秋强,香港中文大学助理教授
二、研究现状:
缺少的既是数据,也是评测标准
要研究这种能力,首先需要有用户真正面向模型提问的音视频数据,用于训练和评测。然而,用户用自己的设备与模型对话的录制数据仍然非常稀缺,难以覆盖不同环境和交互细节。特别是多轮的原生音视频对话数据,包含 AI 在前轮中对用户的回应,几乎无法找到。由于数据的稀缺性,现有的 Omni 模型的原生音视频对话能力其实有待提高,往往需要各种辅助模块(比如语音转文字)来辅助交互,但是语音转文字等等辅助模块,往往会带来额外的计算量和信息损失,拉低了交互体验的上限。
其次,一句好回复往往要同时顾及环境、物体和情绪,同一个意思又有多种表达,单靠关键词匹配难以可靠评判 AI 回复的质量。数据从哪里来、回复怎样算好,是待解决的两个问题。
三、为了理解而生成
音视频联合生成和 Agent 的进展,让我们认为「 为了理解而生成 」(generation for comprehension)成为了可行的路线:先明确要测试的能力,再合成对应对话,并依据实际音视频内容形成参考回复和评分标准。同一套标准既能用于评测,也能作为训练奖励。
由此,我们构建了 数据引擎 OmniVChat-Studio 、评测基准 OmniVChat-Bench 和强化学习奖励设计 OmniVChat-RL,把原生音视频对话的造数据、测能力和改进模型接在一起。
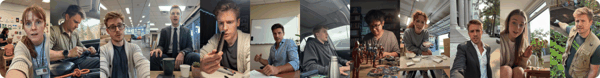 图 1:OmniVChat-Bench 一览。每张卡片取自一条合成对话里的用户画面。 四、OmniVChat-Studio:
单轮与多轮的原生音视频对话数据引擎
我们设计了 OmniVChat-Studio , 一个 Multi-Agent 的原生音视频对话数据引擎 ,输入是一份子类配置和文本语料(作为随机种子),输出是带参考回复和分层判分标准的单轮、多轮音视频对话。
在 OmniVChat-Studio 中, 包含四个智能体分工协作 。Director 负责场景构思、剧本与提示词、审核决策,以及参考回复和评分标准;Renderer 把通过审核的提示词及参考媒体渲染成音画同步的片段;Reviewer 观察实际音视频,写出内容描述和质量报告,并回答针对性的核验问题;Validator 则是确定性的规则校验器,检查结构化剧本或对话记录是否满足配置要求。
单轮对话数据的合成从采样开始 。系统按配置抽取语言、场景、镜头方式、音画干扰等属性,并默认随机抽取三段文本语料。Director 据此构思故事,再细化用户要问什么、目标物体怎样出现在画面里、何时说话和等待,最后写成带时间线的结构化剧本。属性控制交互条件,语料拓展内容,两者共同增加同一子类中的样本多样性。
渲染之前,Validator 检查格式、时间线、语速和配置中的规则,Director 结合上下文处理违规报告,并进一步检查剧本是否真正测到了目标能力。通过审核后,Director 组织镜头、连续拍摄、音画同步等渲染要求,交给 Renderer 合成片段。
渲染之后,Reviewer 检查实际说了什么、画面出现了什么,以及切镜、肢体等质量问题。Director 对照这些证据判断是否可用;门是开是关等关键细节不清楚时,就发起定向问答核实。参考回复和评分标准在音视频被接受后形成,并以实际证据为依据。
多轮对话数据的合成需要同时维护跨轮依赖 。系统先规划整段对话及媒体引用关系,再逐轮编写提示词,按需使用已通过审核的视频、音频或末帧。较早出现的物体、人物声音和场景状态因此可以成为后续轮次的依据;用户换地点或话题时,也能选择合适的历史参考。每轮的片段和回复进入历史,全部完成后再校验整段记录,必要的计划修复从受影响的轮次开始。
这套流程也为扩展能力留下了接口 。新增子类时,可以围绕它的配置、特定提示词和规则定制 Flexible 模块,复用 Fixed 模块及整体审核流程。最终交付的是音视频、参考回复和 rubric 配套的数据实例,可分别服务于后面的评测与训练。
主题:交互