
冻结模型权重,Agent还能持续进化:ModularRSI探索Harness自我改进
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
在基础模型全程冻结的情况下,经过 Harness 演化,系统在 Terminal-Bench 2.0 上的准确率从 47.57 提升至 52.43 。更关键的是,这些改进还能迁移到未参与演化的任务、不同领域乃至不同基础模型。
 arXiv: https://arxiv.org/abs/2609.14857
Code: https://github.com/IQuestLab/ModularRSI
Blog: https://recursive-self-improvement.notion.site/blog-1-modularrsi-toward-generalizable-harness-rsi
这项工作的核心问题很直接: 当模型本身不再变化,Agent 能否通过改造“模型如何工作”,获得持续的自我改进能力?
研究团队把一个 Agent 写成:
A=(M,H)
其中,(M) 是基础模型,(H) 是 Harness。
对于今天的 Agent 来说,最终表现已经越来越依赖模型外围的系统机制。模型能够看到哪些环境信息,怎样维护上下文,什么时候调用工具,失败后如何恢复,以及什么情况下可以宣布任务完成,都会影响最终结果。
这些机制共同构成了 Harness。
ModularRSI 进一步把变化对象放到了 Harness 上:
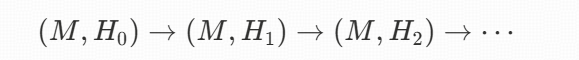 模型 (M) 始终冻结,Harness 则随着执行经验不断发生变化。
Agent 每完成一批任务,都会留下执行轨迹;系统从轨迹中寻找反复出现的缺陷,再修改自身运行代码,让下一轮执行建立在上一轮经验之上。
这构成了 Harness Recursive Self-Improvement,也就是 Harness RSI 。
视频 1|Performance of the harness across different evolution generations on Terminal-Bench 2.0
视频 1 展示的正是这一现象:基础模型保持冻结,外围 Harness 随着演化代次推进,Terminal-Bench 2.0 表现持续提高。作者据此提出,Agent 的迭代式能力提升并不必然伴随模型权重更新,改善智能被组织和调用的方式,同样可能带来性能增长。
不过,只看一条不断上涨的 benchmark 曲线,还很难证明真正的“自我改进”已经发生。
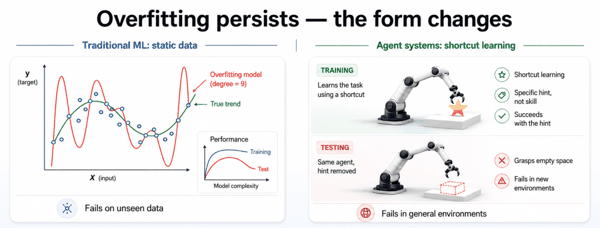 Figure 2|A case showing that the overfitting issue of modern agents is much more in disguise than traditional machine learning
如果一个 Agent 反复在同一类任务上执行,并不断针对失败修改代码,它很容易逐渐熟悉特定 benchmark 的任务结构、工具约定和常见失败模式。此时分数依然会上涨,但 Harness 学到的可能只是局部策略。因此,研究团队给 Harness RSI 设置了一个更严格的判断标准: 只有当改进能够泛化到产生这些改进的经验之外,自我改进才真正具有意义。
围绕这一标准,ModularRSI 将 Harness 演化与最终评测严格隔离。团队构建了一个包含 2000 个高质量实例的数据池,从中抽取两个互不重叠的演化集:120 个 Terminal-Bench 相关实例和 120 个 SWE-Bench 相关实例,并分别演化出 TB-evolved 和 SWE-evolved Harness。演化结束之后,Harness 被冻结,再放到 Terminal-Bench 2.0 和 SWE-Bench Verified 上进行评估。整个演化和模型选择过程中,都不会使用最终 benchmark 的评测数据或反馈。
研究关注的重点由此从“能不能把当前任务做得更高”,转向“Agent 究竟有没有学到可以重复利用的执行机制”。
先拆开 Harness,再让它学习
直接让一个 LLM 阅读完整 Agent 代码库,然后同时诊断、修改所有逻辑,搜索空间会迅速变大。一次失败也可能来自多个位置:工具调用错误、环境反馈处理不当、上下文丢失、循环逻辑异常,或者任务尚未完成时就提前退出。因此,ModularRSI 先将 Harness 拆成五个相对独立的模块:
Agent Loop : 负责“推理—行动—观测”的迭代过程;
Observation Management : 处理和筛选环境反馈;
Tool Use : 负责工具选择、调用和参数构造;
Context Management : 维护历史信息、任务约束和中间结果;
Task Completion Detection : 判断任务是否已经真正完成。
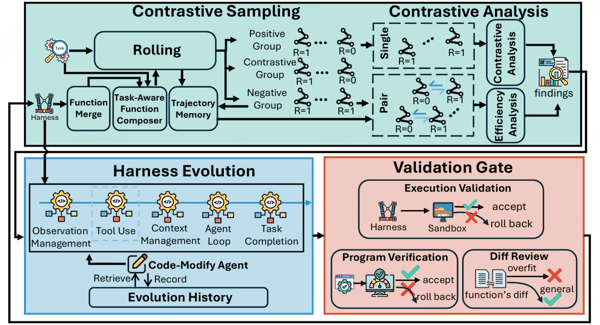 框架图|Overview of ModularRSI:五个 Harness 模块、轨迹分析、Harness Evolution 与 Validation Gate
每个模块从同一个初始 Harness 出发独立演化。一次任务执行结束后,ModularRSI 不会根据单条失败轨迹立即修改代码。对于同一个任务,它会进行多次 rollout,并根据执行结果形成几类不同的比较:
1、如果所有轨迹都成功,系统继续检查其中是否存在重复操作、多余工具调用或低效交互。
2、如果同一个任务同时出现成功和失败轨迹,价值更高。任务和环境保持一致,结果却不同,系统可以直接对比两条轨迹,判断究竟哪些决策改变了执行结果。
3、如果所有轨迹都失败,系统则进一步寻找历史迭代中有没有成功版本;如果依然找不到,再分析死循环、错误工具调用、薄弱的错误恢复或提前终止等问题。
之后,这些轨迹会被整理成结构化 findings:哪个 Harness 函数可能存在问题、证据来自哪里,以及应该进行怎样的修改。只有当类似缺陷在多个任务和多条轨迹中反复出现,它才会获得更高的修改优先级。因此,ModularRSI 的目的是把“某一次任务失败”逐渐抽象成“某一种系统性缺陷”。
此外,代码写回 Harness 之前,还要连续通过三道验证:第一道是 Program Check ,检查语法、import、接口契约等基本程序正确性;第二道是 Diff Review ,重点寻找任务特定常量、面向单个实例的解决方案,以及可能只对当前 batch 有效的启发式规则。出现明显特化倾向,修改会被回滚;第三道是 Execution Validation ,让修改后的 Harness 重新实际执行任务。出现新的运行时错误,同样无法保留。
最后,ModularRSI 会分别获得五个模块的独立进化结果,并通过 Cross-Module Integration 机制在进化集上进一步执行一个 epoch 的联合进化,将各模块的改进进行整合,从而得到最终的 evolved harness。与此同时,研究团队还引入了 Function Merge 和 Task-Aware Function Composition 两个机制:前者用于合并功能相近或存在冗余的 functions,以减少功能重复与潜在冲突;后者则根据不同任务的需求,从各模块中动态选择并组合合适的 functions,使最终 harness 能够针对具体任务调用更适配的执行能力。
这套机制让 Harness 的演化更接近一套受约束的软件迭代流程:执行产生经验,经验形成诊断,诊断进入代码;并且,代码只有经过验证才能成为下一代系统的一部分。
模型没变,能力还能迁移
最终实验验证了 Harness 本身具有相当大的优化空间。
在 Terminal-Bench 2.0 上,原始 Harness 的准确率为 47.57 ,经过 ModularRSI 演化后提高到 52.43 ,提升 4.86 个百分点 。
单独观察不同模块,还能看到明显的功能分工。其中,Agent Loop 带来的单模块准确率提升最大,约为 2.99 个百分点 ;Observation Management 对执行效率的改善更加明显,平均交互步数下降约 35% 。
值得注意的是,把所有模块直接放在一起联合演化,结果反而下降。Joint All-Module Evolution 的准确率只有 44.19 。而先让各模块独立演化,再将有效能力合并,最终可以达到 52.43。