
开普云姜全:真机数据是当前具身智能最大的数据缺口
开普云姜全:真机数据是当前具身智能最大的数据缺口
2026年11月20日 22:15
作者:
何治民
来源:
上海证券报·中国证券网
上证报中国证券网讯(记者何治民)当前,高质量真机交互数据积累不足,成为具身智能模型落地真实场景的核心卡点。近日, 开普云 战略投资部总经理姜全在接受上海证券报记者专访时表示:“预训练需要巨量数据,而真机数据过往几乎没有积累,这正是具身智能当下最大的数据缺口。谁能真正满足模型训练的本质需求,谁才有发展基础。”
300台真机爬坡满产双基地错位布局
开普云 依托20余年 大数据 积淀与自有大模型技术底座切入具身智能赛道,今年年内先后落子无锡、天津,构建起“真机+真实场景+高质量数据”的采集体系,形成真机数采-模型训练-应用验证-迭代补充数采的业务闭环。
今年年初, 开普云 启动无锡具身智能数据基地建设。该基地规划面积6000平方米,部署300台真机设备,主要采集高质量、真实场景数据。基地试采阶段,整体数据验收通过率达到95.6%。“9月单月内,基地日均产出从300余小时提升至约1000小时。”姜全告诉记者,无锡基地于7月投入运行,9月完成首批150台部署并基本推向满产,剩余150台目前正进入验收与部署阶段,计划第四季度将300台 机器人 的产能全部盘活。
“满产后,预计基地日均可以产出2000小时左右的有效真机数据,年产约50到60万小时。”姜全向记者解释,“有效数据”指的是对具身智能模型训练真正能产生训练效果、提升泛化能力的数据。
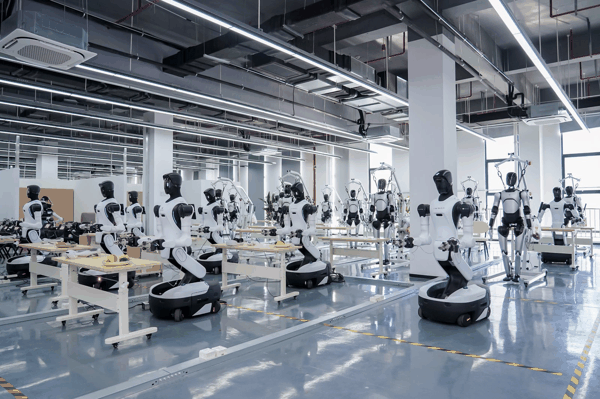 姜全称,300台的部署规模是目前业内单体规模较大的真机数据基地,无锡基地的整体投入已过亿元。目前,该基地的数据客户以主流 机器人 厂商和相关模型厂商为主。为满足旺盛的客户需求,该基地已实行双班制作业。
无锡基地覆盖科学实验、商务办公、 物流 、工业与日常生活等多元场景,并重点采集长程任务数据。“不只是 机器人 站在桌子前叠衣服——叠完还要装进袋子、用真空机抽成真空,这是一个连续多步骤的完整任务流程。”姜全说,这类多元化、非机械重复的数据,才是当前模型训练真正需要的。目前无锡基地已有一部分 机器人 实现模型驱动的自主执行任务,形成“采数据—训模型—真机验证—再迭代”的闭环。
在数采基地布局上,开普云采取差异化定位。无锡侧重全场景真机数据采集,采用“无锡国资建设并持有重资产、合资公司运营”的轻资产模式:惠山区国资完成建设与 机器人 采购,开普云与当地国企成立合资公司作为运营方,共同向客户提供具身智能数据。
在天津基地,开普云则承担“建设+运营”双重职能。姜全表示,天津在项目中类似工程总包(EPC)角色:一方面提供具身智能数据治理平台软件,承担数据全流程管理与控制;另一方面负责设备选型采购与组网联调,形成可大规模采集的完整软硬件系统。“天津基地规划部署约140至150台设备,侧重以灵巧手为末端执行器的操作类数据,与无锡形成互补。”姜全补充说。
姜全还透露,公司正推进其他区域基地的落地申请,倾向长三角、珠三角等制造业场景丰富、落地禀赋多元的地区,如东莞、佛山都是优选;后续基地还规划覆盖异构本体类数据采集。同时公司同步布局EGO、UMI无本体采集、仿真合成数据多技术路线,以真机遥操数据为核心,多类数据科学配比互补,兼顾模型训练精度与泛化能力提升。
真机高质量数据价值数倍于普通任务数据
对于行业普遍关注的具身智能数据缺口,姜全援引业内专家的估算:大语言模型达到GPT-3级泛化能力,大约需要上亿小时级的语料支撑。具身智能同样如此——“预训练需要巨量数据,而真机数据过往几乎没有积累,这正是具身智能当下最大的数据缺口。”姜全强调。
谈及具身智能数据的价值差异,姜全向记者介绍,经过深度加工标注的真机高质量数据,其价值可达简单任务数据的数倍。他强调,公司交付的是将原始数据经过基础清洗、分段与粗标注的“半成品”,具体价格属于框架协议保密信息。
针对“同类任务重复采集”导致数据无效的行业痛点,姜全直言,核心卡点在于采集方是否站在模型训练需求的角度工作。“同一个任务重复采10条,如果没有训练理念介入,10条高度重复,无法提供泛化价值。”开普云的做法是,由具身智能工程师、算法工程师和AI工程师引导采集,通过变换衣服材质、桌面环境、扰动因素等方式,生产多元化要素数据,“我们自身就是数据需求方”。姜全认为,这正是公司数据有效程度较高、获客户认可的原因。
对比传统数据标注厂商,开普云不局限于人力密集型标注,具备数据工程、自有大模型底座、产业场景理解、全链路服务能力,可以反向指导采集任务拆解,深度匹配模型预训练、强化学习、精度校准等不同阶段需求。
从数据到模型训练场终局是闭环迭代
姜全反复强调,数据采集和训练场运营并非开普云的终局。公司的主线是打通具身智能“数据—垂直模型—场景部署”全链条,对标大语言模型产业链中负责应用落地的角色。公司作为工信部具身智能数据标准工作组联席组长单位,深度参与行业数据标准制定,把 大数据 与大模型领域积累的能力延伸至 物理AI 领域。
“语言模型在数字世界落地,具身智能在物理世界落地,两者的底层能力是同构的。”姜全表示,开普云过去积累了大量大模型相关 大数据 工程能力,这套能力能自然延伸到具身智能领域。
公司何时能推出可交付商业场景的具身垂直模型?姜全给出的预期是:预计明年到后年,公司能在部分细分场景实现规模化部署。
“目前数据一部分交付客户,一部分用于自有模型迭代,双方还会在一定程度上共享数据。”姜全表示,公司不会向本体环节延伸,“大家要做专业化分工,本体厂商是躯干基础,我们做具体场景的模型和部署”。
当前,全国训练场快速扩张,但也有个别城市的场地已出现设备撤场出局的现象。对此,姜全并不担忧:“数据质量的标准就在于对模型训练是否有效。谁能真正满足本质需求,谁才有发展基础。训练场不应只定位在数据采集,而是兼具数据生产、具身智能验证与闭环迭代功能的基地。”仿真数据与真机数据属于互补而非替代,真机数据承担校准仿真输出、打通仿真-现实鸿沟的关键角色。
他透露,公司已在无锡与当地工业企业开展真实场景验证,按“数据—模型—落地—再数据”螺旋上升的方式推进,目标是让 机器人 进入真实生产环节并实现规模化上量。
(文章来源:上海证券报·中国证券网)