
PyTorch、JAX都被点名!Softmax曝出隐藏Bug,Gemini立功
深度学习中最基础、使用最广泛的两个函数,竟然藏着两个隐蔽的 Bug。
昨日,Google DeepMind 首席研究科学家 Jonathan T. Barron 在 X 上公布了一项新研究。
他指出,包括 PyTorch、JAX、TensorFlow 在内的主流深度学习框架,普遍采用的 Softmax 和交叉熵(Cross-Entropy)标准实现中,存在两个容易被忽视的数值精度 Bug。
这些 bug 平时很难察觉,却可能在模型训练的特定阶段悄悄改变梯度,造成损失突然飙升,甚至让模型已经学到的能力出现退化。
更有意思的是,研究团队发现,只需调整计算方式,就能修复这两个 bug,无须提高浮点精度,也不需要重新设计损失函数。
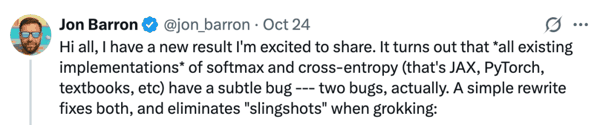
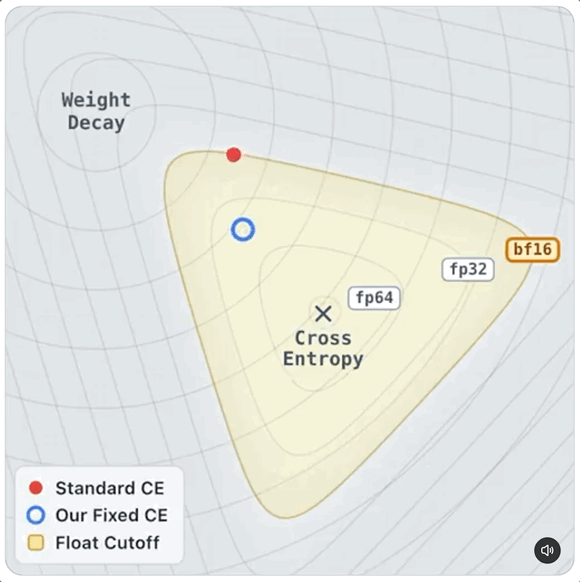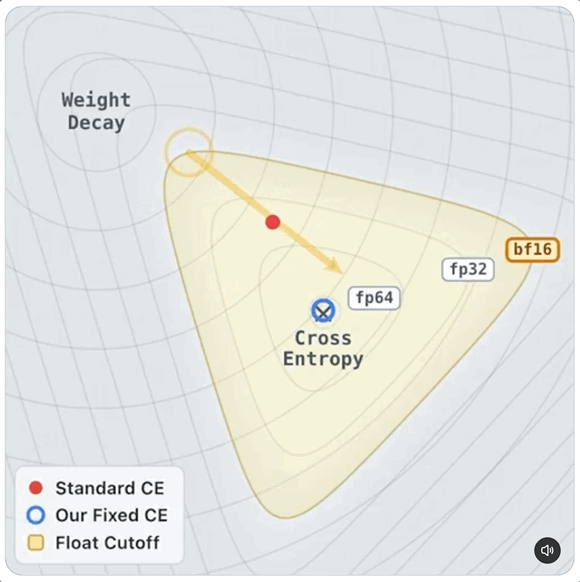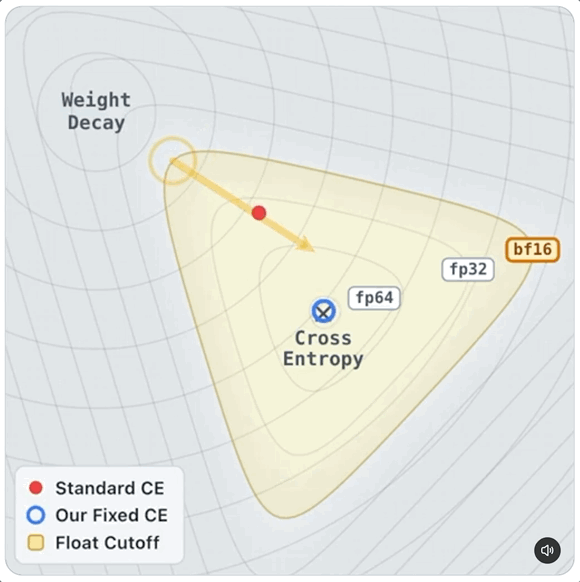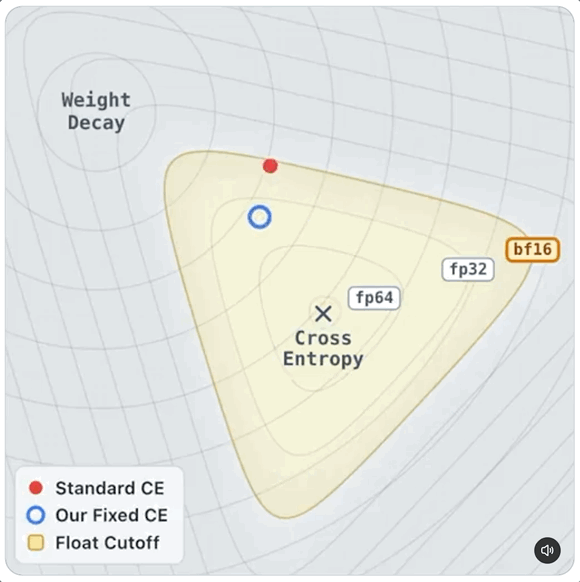
相关论文已于 10 月 22 日提交至 arXiv,除了 Jonathan T. Barron,还有另外两位研究工程师与研究科学家 Dan Gnanapragasam 和 Michael Tschannen。
论文标题:A Fix for Softmax and Cross-Entropy
论文地址:https://arxiv.org/pdf/2610.31642
并且按照 Barron 的说法, 从发现问题、开展实验到撰写论文,Gemini 在这项研究中承担了相当多的工作 。
模型越自信
梯度反而算错了
第一个 bug 叫做 Softmax Collapse(Softmax 坍缩) 。
要理解它,先得看看 Softmax 在做什么。
训练分类模型时,神经网络通常会为每个候选类别输出一个原始分数,也就是 Logit。Softmax 负责将这些分数转换成概率,再由交叉熵衡量模型的预测与正确答案之间的差距。比如,一张图片中有一只猫,模型给猫的分数远高于狗和鸟。经过 Softmax 转换,猫的预测概率可能达到 99.99%。
随着训练继续,模型对正确答案越来越有把握,正确类别的 Logit 与其他类别之间的差距也越来越大。问题就出在这里。
现有实现通常会先从所有 Logit 中减去最大值,再进行指数计算。这是一种经典的数值稳定性处理,可以防止指数运算发生溢出。但减去最大值后,最大 Logit 对应的指数值变成了 1,其他类别则是一些很小的正数。在正确类别分数最高的情况下,Softmax 的分母实际上变成了:
1 + 一个很小的数 。
浮点数的精度有限。当这个小数足够小时,计算机在执行加法时就会直接将其舍去,结果被四舍五入成 1。于是,正确类别的预测概率被计算为精确的 1,交叉熵损失变成 0,对应梯度也被算成 0。然而,其他错误类别的梯度仍然保留着微小的非零值。
按照交叉熵的数学定义,所有类别对应的 Logit 梯度之和应该为 0。现在,正确类别的梯度提前归零,其他类别的梯度却还存在,原本应当成立的关系被破坏。论文将这种突然失去精度的位置称为 精度悬崖(Precision Cliff) 。
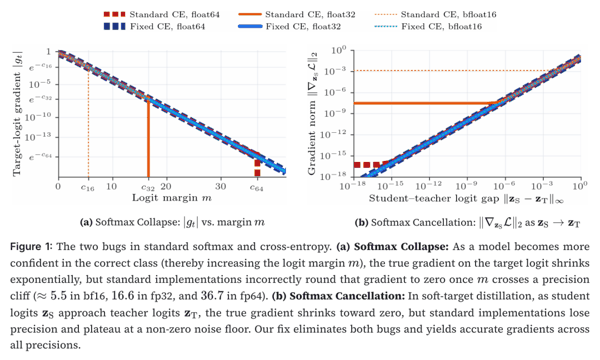 标准 Softmax 和交叉熵中的两个数值计算缺陷。(a)Softmax Collapse(Softmax 坍缩),(b)Softmax Cancellation(Softmax 相消误差)。
论文给出了不同浮点格式下的临界值:
bf16:Logit Margin 约为 5.5。
fp32:Logit Margin 约为 16.6。
fp64:Logit Margin 约为 36.7。
这里的 Logit Margin,衡量的是正确类别的 Logit 相对于其他类别合计得分的优势。以 fp32 为例,当这一差距超过约 16.6 时,标准实现就会遇到精度悬崖,错误地将正确类别的梯度归零。此时,对应的理论预测概率已经高达约 99.9999938%。
论文给出了一个非常直观的例子。假设三个 Logit 分别是 [9, -9, -9],第一个类别为正确答案。
标准 JAX 和 Optax 实现计算出的交叉熵损失为 0,正确类别的梯度也是 0。但按照修复后的计算方式,损失实际上约为 3.046×10⁻⁸,正确类别的梯度约为 -3.046×10⁻⁸,另外两个类别的梯度则分别约为 1.523×10⁻⁸。这些数字虽然很小,却直接影响了梯度是否满足数学上的约束。
这一问题并非完全无人发现。2025 年,Prieto 等研究者已经识别出相关现象,并提出 StableMax,通过替换 Softmax 中的指数函数来缓解问题。
Barron 团队这次选择了更直接的办法:保留原本的 Softmax 和交叉熵定义,重新组织计算过程。他们将最大 Logit 对应的项从指数求和中单独分离出来,再使用数值稳定的 softplus 函数完成计算。对于单一正确标签的交叉熵,修复后的公式还让自动微分直接得到:正确类别的梯度等于其他类别梯度之和的相反数。这样,极小的梯度就能继续保留下来,直到浮点数确实无法表示它为止。
论文同时给出了 JAX 参考实现,覆盖 Softmax、Log-Softmax 和交叉熵。
一个小小的精度问题
如何引发训练中的「弹弓」
这个 Bug 最有意思的地方,是它可能解释一种长期被观察到的神经网络训练现象: Slingshot Mechanism(弹弓机制) 。
2022 年,Thilak 等研究者在研究 Grokking 时观察到了这种现象。Grokking 通常被翻译为「顿悟」:模型很早就记住了训练数据,却要经过相当长时间的训练,才能突然在测试数据上获得较好的泛化能力。在这一过程中,研究者发现训练损失有时会长时间维持在接近 0 的位置,随后突然出现尖峰,再次回落。这样的变化可能反复发生,并伴随测试准确率的跃升。
为什么模型明明已经记住了训练数据,损失还会突然暴涨?论文给出了一种具体解释。
当模型记住训练集后,正确类别与其他类别的 Logit 差距不断扩大,逐渐接近精度悬崖。一旦越过临界值,标准交叉熵就会错误地将正确类别的梯度归零。此时,Adam 这类自适应优化器也会受到影响。Adam 会根据历史梯度及其平方的移动平均值,动态调整参数更新的幅度。
当训练梯度长期接近 0 时,优化器记录的梯度二阶矩估计也会逐渐衰减。随后,权重衰减或剩余梯度带来的参数变化,可能让一部分样本重新跌回精度悬崖以内。这些样本原本被舍去的梯度突然恢复。由于 Adam 用来归一化梯度的分母已经变得很小,一次正常的梯度恢复就可能造成异常大的参数更新。训练损失随之突然飙升。
这正是论文提出的 Slingshot 形成机制 。
主题:差距