
马斯克终于交卷:Grok 4.7跑分很强,实测却翻车了?
在头部大模型几乎迭代一轮后,马斯克的SpaceXAI终于也跟着“交卷”了。
北京时间9月22日,SpaceXAI正式发布新模型Grok 4.7,官方称这是目前旗下功能最强大的编程和知识处理模型。马斯克转发跟帖称“Grok 4.7 是智能、速度和低成本的强大组合”。
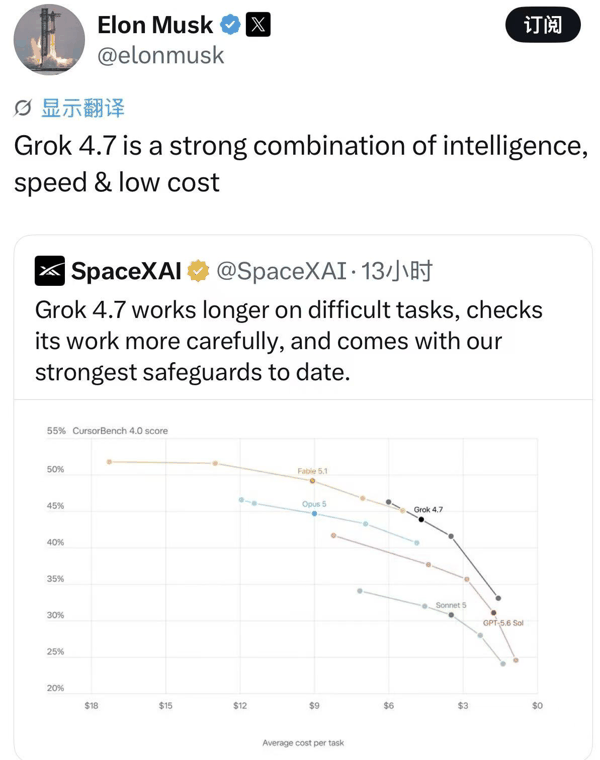 不过,从首批评测和用户反馈来看,Grok 4.7更像是一次补齐短板的追赶,而非全面领先的代际跃升。它在长时程智能体任务和编程测试中进步明显,但在网页、3D场景和可视化编程等实测中,也出现了不少“跑分很强、落地翻车”的样本。
根据AI评测机构Artificial Analysis的数据,Grok 4.7在智能指数上得分46,位列模型榜单第六,也让SpaceXAI进入全球排名前四的AI实验室之列。
官方在博客提到,Grok 4.7能更长时间地处理复杂任务,更仔细地检查自身运行结果,并配备了最完善的安全保障措施。“速度是同类模型的两倍,价格却只有一半。”
与Grok 4.6相比,Grok 4.7 使用了更大更新的基础模型,经过更长时间的强化学习训练,任务组合也更加复杂,尤其侧重于那些需要花费数小时才能完成的问题。因此,这一模型在验证自身工作和处理更长的上下文方面表现更佳。
从评测结果看,这次升级最明显的进步集中在智能体和编程场景。
Artificial Analysis发文提到,在AA-Briefcase这一长时程智能体知识工作基准中,Grok 4.7仅落后于Claude Opus 5和Claude Fable 5.1。该测试模拟数据分析、产品管理和企业战略等真实工作,需要模型处理大量文件,并最终交付文档、表格或演示文稿,比单轮问答更接近AI进入办公室后的实际任务。
编程能力也有明显提升。Grok 4.7搭配官方编程智能体Grok Build,在Artificial Analysis编程智能体指数中得分56,在各家模型搭配原生智能体工具的测试中,它排名第四,仅落后于Claude Fable 5.1、GPT-6 Astra和Claude Opus 5。
在价格上,Grok 4.7标准版为每百万输入token 2 美元、每百万输出token 6 美元,与 Grok 4.6 保持一致。官方还会提供速度更快的一版模型,其输出速度是标准版的两倍,价格也相应翻倍。
单看价格,Grok 4.7在前沿模型中确实不贵,但低单价并不必然等于低总成本,因为它完成任务时消耗的token更多。
Artificial Analysis的测试显示,Grok 4.7每个智能指数任务使用约 8.1万输出token,而 Grok 4.6为3.6万,GPT-6 Astra为2.7万 token,分别高出了125%和196%。
对于按量付费的开发者而言,真正需要比较的是完成同一项任务要花多少钱、等待多久,这还需要进一步的任务实测。
根据首批用户的案例测试,在网页、3D场景和可视化编程上,Grok 4.7的结果并不稳定。有用户对比Grok 4.7与Kimi 3在3D和前端任务上的表现,称Grok不仅生成效果翻车,消耗成本也达到后者的约三倍;在经典的“鹈鹕骑自行车”SVG网页动画测试中,它对角色与自行车运动关系的处理同样不及预期。