
测算显示DeepSeek Harness月度经常性收入或超1.92亿元
(来源:财经AI湃)
 近期DeepSeek接连发布技术报告和开源社区公告,侧面向外界传递其乐观的经营曲线 近一个月,DeepSeek频繁通过技术报告和开源社区公告,向外界侧面传递经营情况。
10月20日,DeepSeek曾披露其单个推理集群每天处理155万亿Token(词元)。
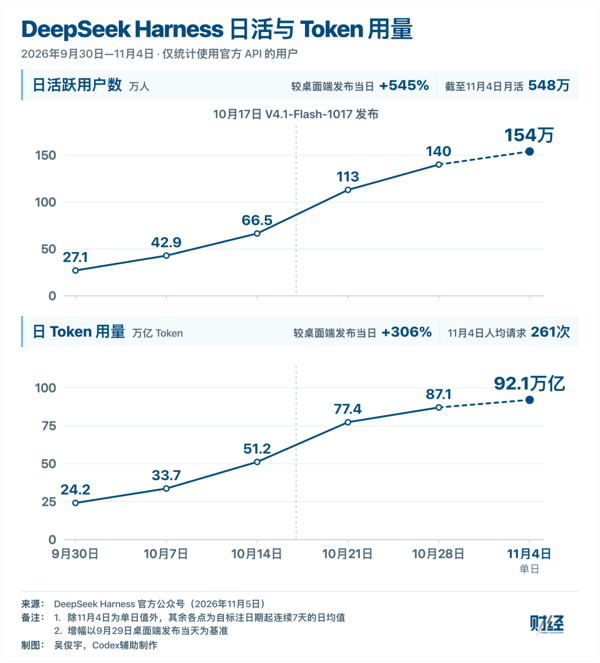
11月5日,DeepSeek在开源社区公告中披露了旗下智能体产品DeepSeek Harness的用户规模和Token消耗数据。 截至11月4日,DeepSeek Harness日活跃用户已达154万,月活跃用户达到548万,单日Token消耗量约92万亿。
这一数据仅统计通过DeepSeek官方API(应用程序编程接口)调用模型的用户,不包括在DeepSeek Harness中接入其他模型,或通过第三方云平台、私有化部署使用DeepSeek模型的用户。DeepSeek Harness的实际使用规模大于上述数字。
DeepSeek Harness是一款开源智能体产品,可用于编程和办公场景,定位与OpenAI的Codex、Anthropic的Claude Code类似。它于今年8月13日推出,上线不到三个月。
9月29日桌面端发布后,DeepSeek Harness的增长明显提速。截至11月4日,其日活跃用户较桌面端发布当日增长545%,日均Token用量增长306%。10月17日,DeepSeek发布V4.1-Flash-1017版本,此后一周日活从66.5万跃升至113万。
 月度经常性收入有望超过1.92亿元
154万日活、92万亿Token,DeepSeek没有直接披露DeepSeek Harness带来的收入,但根据公开的Token用量和API价格,可以进行估算。
DeepSeek Harness调用DeepSeek模型时,只能按官方API的高峰、闲时两档价格计费,因此可以根据公布的Token消耗量估算这部分收入。
API收入取决于Token的构成,即输入缓存命中、输入缓存未命中和输出各占多少。缓存命中率越高,收入越低。
这背后的技术逻辑是,大模型处理输入时,要先对每个Token做一遍计算。如果一段输入此前已经算过,结果缓存下来,再次请求时直接读取即可,不必重新计算。这省下的是最昂贵的GPU(图形处理器)算力,所以缓存命中Token的定价很低。
今年8月,《财经》曾实测DeepSeek-V4-Flash。测试中,缓存命中输入占全部Token的95.9%-97%,缓存未命中输入占1.6%-2%,输出占1.2%-2%,换算成输入内部的缓存命中率约为98%。
参照这一Token结构,并取更高的缓存命中率,若92万亿Token中,缓存命中输入占98%,缓存未命中输入占1%,输出占1%。 按DeepSeek-V4.1-Flash闲时价格计算,DeepSeek Harness当天对应的API收入约640万元,月度经常性收入(日收入×30)约1.92亿元,年度经常性收入(月收入×12)约23亿元。
需要注意的是,上述数字既不是DeepSeek Harness过去一个月带来的实际收入,也不是已经实现的年度收入,而是以截至11月4日的日均Token消耗量为基础,计算出的收入运行情况(Revenue Run Rate)。这是大模型公司常用的口径,OpenAI、Anthropic等公司对外披露收入时,也多采用年度经常性收入的运行情况。