
视频生成也能查资料、做模拟:8 B智能体学会自主调用工具
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
让视频模型生成一个人打太极,画面可能很流畅。但如果把要求具体到某个招式,手该怎么抬、重心该怎么移,模型还能做对吗?
再加一点难度:指定一个角色,让它完成这套动作;或者要求两个物体按给定条件碰撞,再把一段故事分成三个连续镜头。
这些要求把视频生成带到了更细的层面。动作需要知识,角色需要视觉参照,运动需要物理约束,多个镜头还要保持顺序与连续性。仅靠一句提示词,生成模型未必能把所有细节都处理好。
如果系统可以先查资料、找参考,必要时跑一次模拟,再决定怎样生成视频,会发生什么?
VideoGen-Agent 尝试把这些步骤交给一个可训练的多模态智能体 。它以 Qwen3-VL-8B-Instruct 为基础,在多轮交互中调用检索、生成和验证工具,并根据工具返回的结果继续作出决策。研究团队先用监督微调建立工具使用能力,再通过多任务强化学习改进这套决策过程。
在包含 600 条提示词、覆盖六类能力的 VABench 上,VideoGen-Agent 的 Toolset 1 配置取得 75.6 分 ,相较基础视频生成器的 56.5 分提高 19.1 分 。保持智能体参数不变、升级生成工具后,得分进一步达到 86.1 分 。在人类比较中,评估者在 84.3% 的判断中更偏好升级配置生成的视频,而非最强单模型基线的结果。
 论文:VideoGen-Agent: Reinforcing Video Generation Agents
论文链接:https://arxiv.org/abs/2609.24997
项目主页:https://andyca111.github.io/VideoGen_Agent/
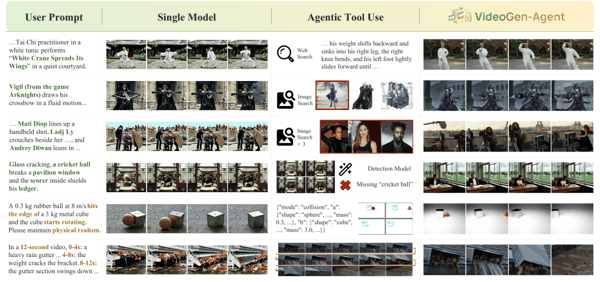 VideoGen-Agent 面向不同生成要求选择工具:检索动作知识、获取视觉参考、模拟物理运动、验证场景结构,以及逐段生成连续镜头。
看三个例子,工具具体补上了什么
第一个例子是太极招式「白鹤亮翅」 。 图 1 第一行中,单模型已经生成了白衣练习者和庭院,也表现出了武术动作,但展示的姿态更接近泛化的展臂、收手,未清楚体现指定招式的动作细节。Agent 先检索招式说明,将重心后移、右腿屈膝和左脚前移等信息补充到生成输入中。右侧关键帧呈现出逐步抬臂、形成一高一低手位的过程。这里需要补充的是动作知识:提示词中的招式名称被展开成了可供生成器使用的具体描述。
第二个例子是指定游戏角色持弩的场景 。 图 1 第二行中,单模型抓住了「人物」和「弩」,却生成了写实风格的兜帽持弩者,未呈现参考素材中的角色造型。Agent 通过图像检索获取视觉参考,再将其交给条件生成工具。右侧结果在发型、服饰和整体角色风格上更贴近图中选用的参考。这个对比说明,仅凭角色名字可能只生成一个语义上接近的人物,而视觉参考能够把身份要求落实到可见的外观特征。
第三个例子要求一段 12 秒视频按三个时间阶段展开 。 图 1 最后一行的提示分别规定了三个阶段的内容:先展示承受重压的雨槽,随后支架开裂,最后雨槽向下摆落。相比单模型一次性生成整段视频,Agent 根据 prompt 中的时间结构将视频拆成三组连续镜头,并分别按照对应时间段的子 prompt 进行生成,同时使用上一段的末帧作为下一段的视觉条件。右侧关键帧因此分别对应三个阶段,使不同时间段内要求的事件能够逐段得到满足,并在整体上形成与原始 prompt 一致的时序过程。
这三组样例分别对应动作知识、主体外观和事件顺序。它们展示的是图中这次生成的具体差异;关键帧无法独立证明整段视频的动作精度与时间对齐程度,整体效果还需要结合后面的 VABench 和人类评估来看。
先把生成这段视频需要的信息找齐
VideoGen-Agent 的工作从理解任务开始。
遇到带有专业知识的动作描述,智能体可以先检索文本资料,把动作步骤和关键细节补充到生成输入中。遇到指定角色、地标或品牌物体,则可以检索图片,选择参考素材,再调用图像或多参考图条件下的视频生成工具。
物理任务提供了另一种工具使用方式。对于给定初始条件的碰撞、下落场景,系统可以通过模拟得到运动条件,再把这些条件交给支持运动控制的视频生成器。这样,生成过程能够使用外部计算得到的运动信息。
工具也可以在视频生成之后发挥作用。例如,一段视频要求多个物体以特定位置关系出现,系统可以利用目标检测和深度估计检查主体与空间结构,并根据反馈决定是否重新生成。
多镜头任务则需要处理前后衔接。智能体可以先生成第一段,提取末帧作为下一段的条件,逐步完成后续镜头。前一段的实际输出,由此成为下一步决策的输入。
这些能力共用一个智能体策略。系统提示中提供工具约束和典型流程,具体执行时,策略根据用户要求和已有观察选择工具、组织参数,并决定是否继续验证或生成。每一步获得的信息,都能影响后续动作。
主题:生成|工具|智能体|VideoGen-Agent|视频生成