
开启智能眼镜新体验:构建边缘侧对话AI
数十年来,获取信息始终离不开注视屏幕、输入搜索词、浏览应用或点击菜单。如今,对话式AI正在引入一种全新的交互模式,改变着我们与技术的交互方式。用户不再需要通过按键检索信息,而是可以通过语音提出问题;不再需要操作界面,而是可以通过自然对话完成交互。 智能眼镜 正是这一演进趋势的具体体现之一。这类可穿戴设备融合了语音界面、边缘AI与可穿戴计算,让开发人员得以重新思考人与技术的交互方式,从而让信息获取更便捷,并减少对传统屏幕的依赖。
然而,打造这些体验远不止将麦克风连接至语言模型那般简单。开发人员必须应对语音处理、音频工程、AI、无线连接与低功耗系统设计等多方面的挑战,才能实现响应迅速且自然流畅的交互。
智能眼镜 带来的新工程挑战
可穿戴设备引入了与传统嵌入式系统截然不同的设计限制。板上的每一毫米空间都至关重要,每一毫瓦功耗也同样重要。麦克风、扬声器、处理器、电池、天线与传感器均需在轻量化外形规格中争得一席之地,而该外形设计还需确保用户全天佩戴舒适。
 打造无缝且隐形的AI助手体验,需要结合增强现实 (AR) 音频以及轻松、响应迅速且自然的语音交互。
与此同时,消费者期望也在持续演变。例如,用户期望语音交互能够快速响应,在嘈杂环境中准确理解语音,并输出清晰音频,同时保持足够的电池续航,以支持日常随身使用。要满足这些期望,开发人员必须将系统视为一个整体,而非孤立地考虑各项技术。
然而,对话式AI并非仅限于AI推理。整体体验取决于语音捕获、音频处理、AI、无线通信与播放能否作为一个完整系统协同运作。
基于毫秒级的精彩对话
人类对话模式为AI提供了可模仿的自然交流范式。
人们会自然地通过“是的”、“对”或“我明白”等简短语言提示回应对方。这些回应通常被称为“渠道返回” (back-channeling),有助于对话自然流畅地进行。
同样,人们也经常打断对方,以澄清观点或提出追问。支持这种被称为“插话” (barge-in) 的行为,是打造直觉式而非交易式对话式AI体验的关键要素。
这些交互对延迟同样高度敏感。处理流程的每个阶段都会影响整体响应时间,包括麦克风捕获、音频处理 (波束赋形)、AI推理、无线通信与播放。
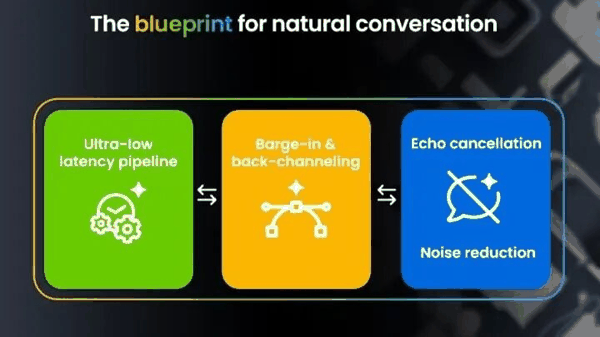 低延迟处理流程构成了自然对话的蓝图。
尽管每个阶段可能仅引入微小延迟,但叠加后的整体效应会影响交互的自然感。
对开发人员而言,优化对话式AI意味着不应局限于单个算法,而需考虑端到端系统延迟。
如何助力AI在现实世界中“听”懂
与受控的实验室环境不同, 智能眼镜 的设计初衷是融入人们的生活和工作场景——繁忙的街道、机场、会议现场、办公室以及制造工厂。然而,在这些条件下准确捕获用户语音,带来了重大的工程挑战。
波束赋形使麦克风阵列能够聚焦于特定声源 (例如佩戴者的语音),同时抑制干扰背景噪声。自适应波束赋形进一步扩展了这一能力,可动态适应其他说话人的声音,从而支持实时翻译或协作对话等应用场景。
回声消除和语音增强等其他技术有助于在音频进入语音识别引擎之前对其进行处理,从而支持在各种复杂的声学环境下实现可靠运行。
恩智浦 Conversa Voice Suite 将这些能力中的许多项整合到一个全面的语音处理软件平台上,助力实现免手动通信。它包含自适应多麦克风波束赋形、声学回声消除以及基于机器学习(ML)的降噪等技术,为开发人员提供所需的软件构建模块,以便为智能眼镜和其他支持语音的边缘设备打造稳健的语音体验。
语音识别性能远不止取决于AI模型本身。麦克风的放置、波束赋形、回声消除、降噪与系统延迟都会影响整体用户体验。
聆听只是对话的一半
对话是双向交互,但准确捕获语音只是体验的一部分。向用户返回清晰易懂的音频回应同样重要。
要在减少失真的同时保持音质稳定,需要精密的硬件设计结合先进的音频处理。因此,智能眼镜依赖于能够在极为严苛的机械约束下运行的微型扬声器。