
迈向通用游戏智能,清华、米哈游开源GameScaling系列模型
部分作者介绍:
张宽:清华大学人工智能学院博士生,研究游戏智能体。
苏悦:香港大学 MMLab 博士生,研究世界模型与具身智能。
罗润:新加坡国立大学博士生,研究全模态基础模型。
郑银河:米哈游崩坏系列 AI NPC & Gameplay 技术团队负责人。
李一鸣:清华大学人工智能学院助理教授,厘清智能创始人,前英伟达研究科学家。
近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型 ,权重与推理代码均以 Apache 2.0 协议发布。
项目主页: https://gamescaling.github.io
模型网址: https://huggingface.co/THUSI-Lab/GameScaling
代码仓库: https://github.com/THUSI-Lab/GameScaling
GameScaling 可以在《我的世界》中采矿、合成、打僵尸,在 Doom 中战斗、导航,在场景逃脱任务中寻找出路。它根据画面、任务提示和近期交互历史,生成键盘与鼠标操作,随着游戏的变化不断决定下一步。
图 1 GameScaling-2B-S3 在 Minecraft 中执行采集、合成与战斗任务的实时演示片段。来源: GameScaling 网站宣传视频
GameScaling 模型炫酷的操作背后也有扎实的评测分数:在《我的世界》MCU 基准的 30 项任务中,GameScaling-27B-S1 的平均成功率达到 63.3% 。据团队实测,其中的 0.8 - 9B 的 6 个模型在 单张 H200 或 RTX 5090 上,即可实现接近 每秒 5 次观测、每秒 30 步动作 的实时游戏交互。
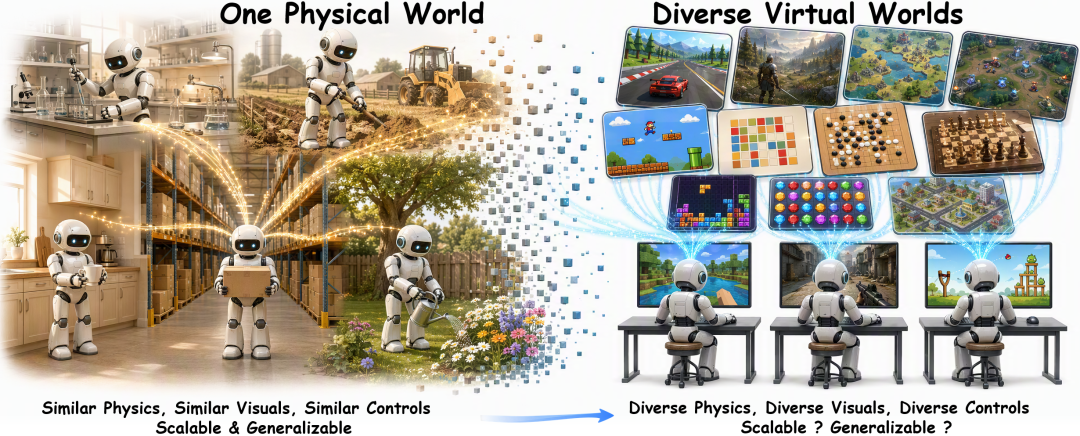
研究团队开源 GameScaling 模型,是希望能与社区一起研究: AI 怎样才能把在一个世界学到的经验,带到另一个世界? 这也是游戏与人工智能长期相伴之后,一道自然浮现的新考题。1997 年,深蓝击败国际象棋世界冠军;2012 年深度学习爆发以来,AlphaGo 和 AlphaStar 分别在围棋和《星际争霸 II》中战胜世界冠军,OpenAI Five 在 Dota 2 中展示了多智能体协作的能力;到了大模型时代,Voyager 又在《我的世界》里探索环境、积累技能。游戏见证并推动着 AI 从搜索、学习走向规划与行动。 但通用游戏智能还要面对另一层挑战 。在现实世界中,无论机器人走进工厂还是家庭,重力、碰撞等物理规律依然成立,共同的规律为经验积累与规模化学习提供了基础。虚拟世界却可以重新设定一切:画面风格、物理机制、动作空间和任务目标,换一款游戏就可能全部改变。同样是「向前走」,背后可能是第一人称视角下的三维移动,可能是上帝视角下的平面移动,也可能是横版世界中的平台跳跃。
图 2 现实世界遵循一套固定物理规律,为经验积累与规模化学习提供了基础;游戏的画面风格、物理机制、动作空间和任务目标都可以改变,能否维持 “Scaling Law” 还没有被系统研究。来源:GameScaling 论文图 1
当世界本身的规则不断变化,增加数据量、丰富多样性、扩大模型,曾经无往不利的 Scaling Law 还能继续奏效吗?
为了回答这个问题,GameScaling 团队基于 Qwen3.5 系列开展持续预训练,使用开源社区的游戏轨迹,将视觉语言模型的知识与可执行操作连接起来。模型根据游戏画面、任务提示和近期交互历史,输出接下来 200 毫秒的键盘与鼠标操作。看见画面、快速思考、做出动作、接收新画面,再决定下一步,构成了智能体在游戏中行动的基本循环。
实验将模型,数据时长,数据多样性三个变量分开考察:设计 0.8B 至 27B 的四档模型规模、50 至 1600 小时的六档游戏数据预算 ,以及游戏轨迹从 全部来自《我的世界》到多游戏混合的五种数据多样性配比 ,共形成 120 组受控配置 。评测也从训练覆盖的世界 MineCraft 和 Doom,延伸到未见过的相近 3D 世界,以及视角和操作机制差异更大的 2D 和 2.5D 世界,观察经验与智能究竟能迁移多远。
研究首先发现了一种有意思的学习节奏:模型早期像是在熟悉自己的「手」。经过初始训练,按键、鼠标和动作格式的预测迅速改善,收益也出现在训练未覆盖的世界。团队将其称为「接口阶段」;随后进入「世界阶段」,进一步提升越来越依赖模型经历过哪些游戏, 收益主要集中在训练覆盖和相近的世界,对遥远的世界的损失甚至会上升。