
清华博士携诺奖班底,跨模态降维破局RNA赛道
 2026 年 8 月,默沙东与莫德纳联合开发的个体化 mRNA 癌症疫苗在黑色素瘤 Ⅲ 期试验中达到主要终点。
消息传来时,马剑鹏难掩激动,徐罡的反应却慢了半拍。这位毕业于清华大学生命科学学院的博士、复旦大学复杂体系多尺度研究院副研究员,当时正埋头于技术细节,尚未立即意识到,这项临床进展恰好与团队过去三年的 RNA 研究发生了交汇: 如何借助 AI,把 mRNA 序列设计得更稳定、表达得更充分。
时间回到 2023 年,那时 RNA 模型远未像今天这般火热。徐罡和团队就开始思考一个“越界”的问题:蛋白质 AI 已经利用海量数据学习了丰富的物理化学规律和演化信息,这些知识中,有没有一部分可以直接“迁移”给 RNA?
这个问题后来催生了两个基于迁移算法的模型。
第一个是 ProtRNA,2025 年发表于 Cell Systems ;第二个是 ProtmRNA,专门用于优化 mRNA 的密码子区域,2026 年 5 月发布预印版。
在徐罡看来,这条路线最重要的地方是提供了一种处理 RNA 数据稀缺问题的新思路。他用了一个颇为大胆的类比来形容两者的区别: “如果说 AlphaFold 以算力攻克了蛋白质结构预测的 50 年难题,那么奥泊则以迁移学习突破了 RNA 领域数据稀缺的世界级瓶颈。一个正面攻坚,一个降维破局,都改写了各领域研究范式。”
徐罡在蛋白质结构预测与设计领域深耕了十余年。他表示,做出 RNA 模型本身不难,最难的是先打破一道思维上的墙:“大家做 RNA 就是 RNA,做蛋白质就是蛋白质。”
而他恰好想到了“跨模态迁移”这个选项。
一次偶然的课题,带出了“跨模态迁移”
ProtRNA 的起点颇为偶然。
2023 年,一名本科生听完马剑鹏的演讲后找到团队,希望加入做科研。徐罡需要为他设计一个课题,便选了 RNA。
这个方向存在一个看似矛盾的问题:公开数据库中的 RNA 序列数量不少,但结构难以测定,能够用于理解结构和功能的高质量数据,远没有蛋白质那么丰富,不同 RNA 家族之间的数据分布也极不均衡。如果完全从头训练,模型能学到的东西就会受到限制。
徐罡换了个思路:与其让一个新模型从头学起,不如利用一个已经在蛋白质数据中训练成熟的老模型,再让它转过来学习 RNA?
团队选择了 Meta 开发的蛋白质语言模型 ESM-2 作为起点。ESM-2 已经通过海量蛋白质序列训练,学习了氨基酸之间复杂的上下文关系。他们保留了这部分已有能力,再使用 RNA 数据继续训练,做出了 ProtRNA。这项成果于 2025 年发表于 Cell Systems 。
这正是迁移算法的思路——跨模态迁移: 把蛋白质 AI 已经学到的知识,带到数据更稀缺的 RNA 领域。
这个看似带有偶然性的探索,也在一定程度上验证了奥泊底层 AI 平台的灵活性:当团队掌握了跨模态迁移的底层算法框架,再向新的研发方向拓展时,前期试错和模型适配的成本有望进一步降低。
这种跨模态迁移,效果怎么样?
与 RNA 领域的专用 SOTA 模型 RiNALMo 相比,ProtRNA 在 RNA 训练阶段只需调整约八分之一的参数、使用六分之一的 RNA 数据,就在多项任务中取得相当甚至更好的结果。
在研究界常用的 bpRNA 公开测试集上,使用相同预测模块比较,ProtRNA 的结构预测 F1 分数为 0.646,RiNALMo 为 0.594。这个指标综合衡量 RNA 内部的碱基配对找得准不准、全不全。
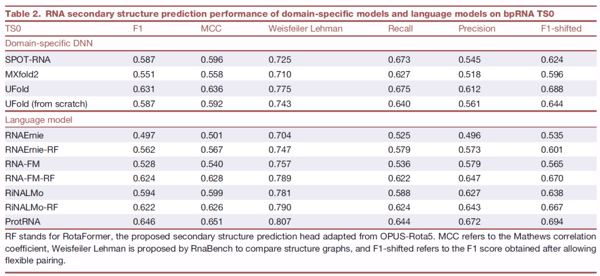 (来源:奥泊生科) 这意味着,借助蛋白质领域已有的知识积累,模型不必从头学一遍,就能与专门为 RNA 训练的模型竞争。
“确定用迁移算法来做以后,后面其实挺顺利的。”徐罡说,“方案设计出来,结果有点水到渠成。”
ProtRNA 最初只是一个研究课题,但这个结果带来了另一个问题:既然蛋白质和 RNA 之间的知识可以迁移,那么这种方法能不能进一步走向更加具体的应用场景?
2026 年,团队沿着这条路继续往前,开发了专门处理 mRNA 的 ProtmRNA。
mRNA 像制造蛋白质的一张“生产指令”。同一个蛋白质,可以对应多种 mRNA 写法,但指令写得不同,稳定性和表达量也可能不同。研究者需要找到更合适的那一种。
这一次,蛋白质和 mRNA 之间天然存在的遗传密码对应关系,恰好为迁移算法提供了一本“翻译词典”。
ProtmRNA 仍然以 ESM-2 为起点,但团队将原本的氨基酸词表扩展为密码子词表,使同义密码子继承相应氨基酸的初始表示,再通过训练形成专门的密码子表征。
从目前公布的结果看,这种方法在多项任务上带来了改善。
与 ESM-2 模型相比,ProtmRNA 在新冠疫苗相关 RNA 序列的降解预测上的相关系数由 0.540 升至 0.684,相对提升 26.7%;真菌表达预测的相对提升 14.6%;mRNA 稳定性预测的相对提升 7.6%。
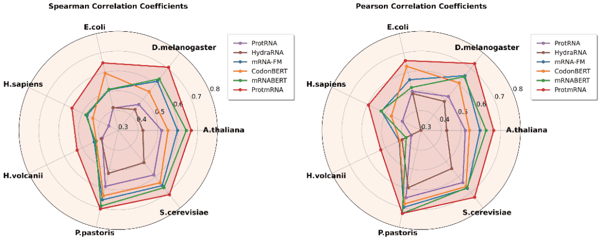 (来源:奥泊生科) 对于药物研发而言,这类预测能力的提升意味着,新抗原或抗体序列可以在进入实验前完成更充分的筛选,从而减少部分依赖反复实验的试错过程,缩短优化周期并降低实验成本。
从 ProtRNA 到 ProtmRNA,跨模态迁移不再只是一个设想:蛋白质 AI 积累的知识,确实可以帮助模型更快进入 RNA 领域。相比完全从头训练,这种方法提供了一条不同的路径——不是重新学习一遍已有规律,而是尽可能复用成熟领域中的知识,再补足新领域的数据。
这条路线也与默沙东、莫德纳正在推进的 mRNA 癌症疫苗产生了一个潜在交集:当新抗原确定之后,怎样把编码它的 mRNA 序列设计得更稳定、表达更充分。
目前,奥泊生科的主要业务仍集中在抗体研发,抗体本身属于蛋白质,也是 AI 蛋白质设计较接近产业应用的场景;mRNA 则是团队沿着跨模态迁移路线正在继续探索的另一个方向。
打破计算与实验的壁垒:懂前沿 AI,更懂商业算账
徐罡并不是 AI 或计算机科班出身。
他本科就读于武汉大学生物学基地班,大三、大四时进过多个实验室,也做过不少传统意义上的“湿实验”。其中一个课题,是利用微藻生产可以作为燃料的物质。
做了一段时间后,他没有继续沉浸在实验结果里,而是先算了一笔经济账:按照当时的生产成本,国际油价大概要达到每桶 120 美元,这条路线才可能盈利。而当时价格不过 100 美元。
徐罡判断,这件事短期内很难做成。事后证明,油价不但没有继续上涨,反而一度跌到四、五十美元。 这段早年的小插曲,让徐罡在日后主导前沿算法研发时,始终保持着一种难得的产业务实感:技术再酷炫,最终也要在真实的商业和工程成本里算得平账。
2014 年,他进入清华大学生命科学学院读博。当时博士生入学后需要先轮转,到不同实验室里跟着不同导师尝试,再决定自己的研究方向。
彼时马剑鹏仍在美国大学任教,同时在清华带组。徐罡轮转到马剑鹏组后就不想走了。但马剑鹏当年已经没有多余的博士名额。徐罡自己去找学院协调,一路争取到时任生命科学学院院长那里,最后才拿到一个名额。
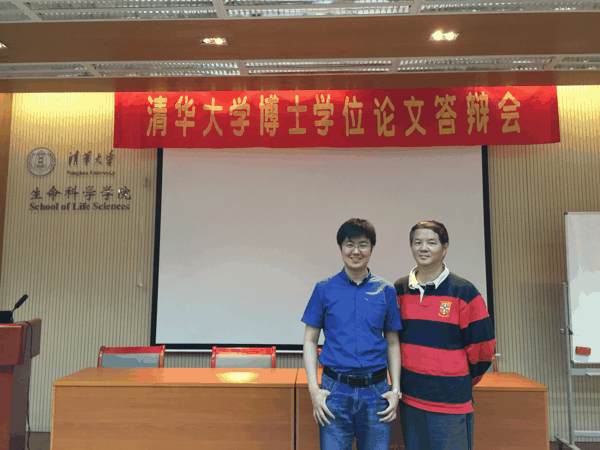 图 | 徐罡(左)和马剑鹏(来源:奥泊生科) 组内的学术自由极度吸引徐罡。“马老师只给一个大方向,剩下的就自己做。可以去查很多文献,发现哪些位置可能有机会,再和他交流。他不会把 protocol 全给你,让你三天五天汇报一次。”徐罡回忆道。
马剑鹏对徐罡的评价则更直接:“他确实有天赋。虽然不是学计算机出身,但 programming skill very good。做博士生时,不仅撑起了我在清华那个组的天,也把我美国组的天撑起来了。那段时间论文几乎都是他发的。”
2018 年,马剑鹏作为上海市高峰人才引进团队核心成员全职回国,回到母校复旦大学,与 Michael Levitt 共同创建复旦大学复杂体系多尺度研究院。
徐罡 2019 年博士毕业后进入该院做博士后,2021 年留任,现为副研究员,同时担任奥泊生科技术顾问。
跨越“结构预测”走向“成药”:干湿闭环才是终极决胜局
徐罡进入计算生物学的时间,也恰好赶上这个领域发生剧烈变化的十年。
早期,计算生物学主要依赖能量函数、分子动力学和结构计算,一点点逼近蛋白质的真实状态;2015 年前后,深度学习开始逐渐改变这一领域,AlphaGo 只是前奏。围棋规则明确,AI 可在既定规则中计算搜优,但换一个游戏便束手无策。
真正改变行业节奏的是 AlphaFold。蛋白质由一串氨基酸序列组成,但这串序列最终会折叠成怎样的三维结构,长期以来一直是生命科学中的核心难题之一。Michael Levitt、马剑鹏等科学家早在几十年前就已开始尝试,业界甚至曾悲观看待“有生之年能否解决”。
2020 年,AlphaFold2 在 CASP14 中取得突破,2021 年相关论文正式发表。
结构预测从此进入新阶段:过去,算法可以提出大量候选序列,却难以快速判断其折叠形态;AlphaFold 首次提供了足够好用的预测工具,让研究者在湿实验前就能筛掉明显不合理的候选。
但这不等于所有问题都已解决。2023 年前后,扩散模型将行业从“预测”推向“生成”。David Baker 团队的 RFdiffusion 借鉴图像生成思路,从随机噪声逐步生成满足特定条件的蛋白质骨架。研究者不再只问“这个蛋白会长什么样”,而是反问“如果我想要某种结构与功能,能否直接设计出来?”
2024 年诺贝尔化学奖同时奖励了这两条路线:David Baker 获奖部分对应计算蛋白质设计,Demis Hassabis 和 John Jumper 则因蛋白质结构预测获奖。
但在马剑鹏和徐罡看来,模型分数再高,蛋白质也得先做得出来,然后能成药。
“从计算角度看没问题,没准它(蛋白质候选序列)就是好的。”有时,徐罡会和马剑鹏争辩。
徐罡负责计算端产生候选。一些候选序列在模型中得分很高,但到了马剑鹏这里,很快就会被挑出问题:某个原子位置不合理、侧链碰撞,或突变虽符合统计规律却违背真实物理化学约束。
更直接的情况会出现在实验里。模型认为很好的蛋白,真正拿去做,可能根本不表达。用马剑鹏的话来说,“一个结构生物学的老法师,看得多了,一眼就知道这个东西在物理或者化学上不合理。”
计算与实验常被称为“干”“湿”两端。AI 最先加速的是干端。过去蛋白质设计如同老木匠手工打磨,一个位点一个位点调整,速度慢,也高度依赖经验;AI 则像给木匠换上了电动工具,大幅提高了预测和生成候选序列的效率。
但工具先进并不等于成品精良。AI 擅长学习数据分布,未必真正“懂”自然规律;生成不等于成立。模型扩大了探索空间,湿实验和专家经验则负责判断哪些候选真正可做。
AI4S 的灵魂仍然是 science,AI 只是是其中越来越重要的工具。
如今“干湿闭环”已是业内标准说法,真正的差别在于湿实验是否深度融入闭环。外包给 CRO 的实验很难将失败、中间状态和经验持续回传模型。而模型不仅需要成功,也需要知道为何失败。
奥泊把计算和实验放在同一个团队里。湿实验由马剑鹏直接领导,计算端则由徐罡负责。实验中的成功、失败和中间状态都会被全部保留,用于模型迭代。
“湿实验的经验回传,其实就是把实验团队的能力蒸馏到模型里,”徐罡说,“因为大家都在马老师团队,他们会毫无保留地分享。”团队把这个过程叫作“蒸馏老法师”。
长期来看,这套闭环真正可能沉淀下来的,是模型、实验和专家判断反复迭代后形成的数据资产。尤其是那些包含真实物理化学约束、记录“为什么失败”的负样本,正是纯计算大厂难以用资金砸出的护城河。数据飞轮一旦转起,AI 才会越来越懂真实的生物世界。
三个“老法师”和一个年轻算法研究者
这套闭环为什么有机会真正转起来?
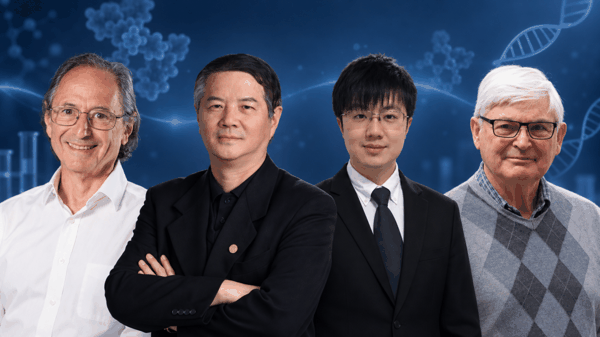
答案在于马剑鹏、Michael Levitt、Alan Fersht 和徐罡,他们分别站在计算生物学、结构生物学、蛋白质工程和 AI 模型的不同位置。