
刚刚,Anthropic开源FlashProve,给大模型办了一张「防伪身份证」
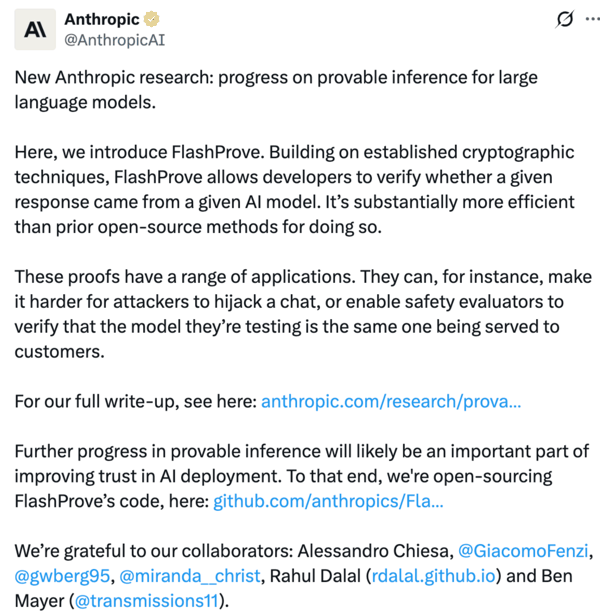
刚刚,Anthropic 发文宣称 「大型语言模型的可验证推理取得新进展」,并开源了一个名为 FlashProve 的系统。 它基于零知识密码学证明技术,让模型提供商能够在不公开模型权重的情况下,证明某个回答确实由指定模型生成。
 什么意思?
平时,你花钱调用的 AI 真的是服务商承诺的那个模型吗?假设一家企业购买了顶级大模型的 API 服务,服务商承诺使用的是能力最强的模型,却在后台悄悄换成一个成本更低的小模型,用户能发现吗?
又或者,第三方模型路由平台在转发请求时,偷偷替换了原本指定的模型,即使最终返回的回答质量不错,用户又有什么办法证明它确实来自自己付费购买的模型?
目前,用户通常只能相信服务商的承诺,很难从技术上独立验证。而 Anthropic 最新公布的这项研究,正试图解决这个问题。
更值得关注的是,这项技术已经在总参数量达到 400B 的混合专家模型上进行了测试:单张 NVIDIA H100 GPU 每秒可以生成约 110 个 Token 对应的推理证明,每 1024 Token 请求的证明文件约为 19 MB。
过去, 零知识机器学习的研究大多集中在规模较小的模型上,FlashProve 则进一步将可验证推理推进到了大型语言模型场景。
目前,Anthropic 已开源 FlashProve 的证明生成器、C++ 和 Lean 验证器,以及相关技术文档和形式化证明。
 官方博客:https://www.anthropic.com/research/provable-inference
github:https://github.com/anthropics/FlashProve
给 AI 回答一张「身份证明」
Anthropic 将这项技术称为 「可证明推理」(Provable Inference)。 在官方博客中,团队首先提出了四类 AI 服务面临的信任问题,试图解决这一类需求: 用户向某个 AI 服务发起请求,却无法确认返回的回答究竟来自哪个模型。
例如,第三方服务商可能为了降低成本,将用户指定的高性能模型替换成更便宜的模型;推理服务器也可能遭到攻击,导致模型权重或输出 Token 被篡改。对于正在进行安全评估的研究人员来说,如果无法确认测试对象与实际部署的模型一致,评估结果也就失去了可靠性。
这项技术的核心思路是,模型服务商先通过密码学方式,为一组确定的模型权重生成一个承诺(Commitment),相当于给模型版本建立一个加密指纹。之后,用户每次发起请求,服务商都可以附上一份零知识证明(zkSNARK),证明这次回答确实由此前承诺的模型根据对应输入生成。
这样一来,用户不需要获得模型权重,也不需要自己重新运行模型,就能通过模型承诺、输入、回答和证明文件,独立验证模型的身份。证明过程不会泄露模型权重,但可以确认输出是否来自指定模型。当然,它证明的是回答的来源,而不是回答内容是否正确。
4000 亿参数模型,证明速度达到 110 Token/s
为了验证方案的可行性,Anthropic 选择了 Meta 的 Llama 4 Maverick 进行测试。这是一个拥有 4000 亿参数的 MoE 模型,每个 Token 实际激活约 170 亿参数。
在单张 NVIDIA H100 GPU 上,FlashProve 的证明生成吞吐量达到约 110 Token/s,每份证明文件约 18.78 MB。 验证端不需要 GPU,使用 24 线程 CPU 验证一份证明约需 17 秒。需要注意,当前测试采用 1024 Token 的请求窗口,每份证明实际检查其中一个输出 Token。
这一效率提升,与 FlashProve 针对 MoE 架构所做的优化有关:证明计算主要围绕实际激活的专家展开,而不是每次都处理模型的全部参数。同时,系统采用批量事后证明,在推理完成后再统一生成证明,降低重复计算带来的开销。
不过,证明仍然需要付出额外成本。按照 Anthropic 的测试,生成证明所需的 GPU 时间约为普通 vLLM 推理的 70—95 倍。此外,目前系统主要支持 1024 Token 的上下文窗口,并针对整数模型和 Greedy Decoding 进行验证,还不能直接覆盖所有模型和推理方式。
为了进一步提高系统可信度,Anthropic 还使用 Lean 形式化验证语言,对协议的完整性、可靠性和零知识等核心安全性质进行了机器可检查的证明,并将代码、协议说明和相关证明以 Apache 2.0 许可证开源。不过,形式化验证并不意味着所有实际运行的代码都获得了同等保证,快速 C++ 验证器与形式化协议之间仍需要进一步审计。
有一类用户,可能很需要这张「身份证」
目前,不少用户会通过第三方 API 中转站或模型聚合平台调用不同厂商的模型。这类服务降低了模型调用门槛,但也带来了一个信息不对称:用户能够选择模型名称,却未必能够独立确认后台实际运行的模型。
例如,在多层转发的调用链路中,服务商理论上可能出于成本考虑,将原本应该交给高性能模型处理的请求,转发给调用价格更低的模型。对于用户来说,即使发现回答质量有所变化,也很难判断究竟是模型本身的随机性、服务状态变化,还是实际调用的模型发生了改变。
在缺少独立验证手段的情况下,用户很难仅凭返回结果确认自己究竟调用了什么模型。
一位网友就认为,普通用户通过第三方调用模型时,很难确认屏幕上的回答究竟来自宣传中的大模型,还是被服务商替换成了成本更低的模型,甚至可能遭遇中间人篡改。