
AI黑箱要被AI破解了?前OpenAI研究员发现,90%的神经元功能可以解释
 10 月 15 日,前 OpenAI 研究员、现任 Goodfire 研究员 Nick Cammarata 在社交平台上分享了一项引发 AI 研究界关注的发现—— 大型神经网络的内部结构,可能远比过去认为的更容易理解。
几乎同时,他发表了题为《Neural Networks Are Already Clean》(神经网络原本就很清晰)的长文,详细解释了自己为何改变过去的研究判断。
这篇文章很快登上各大技术社区并引发讨论。关注的原因之一,是 Cammarata 本人的研究背景。他曾深度参与 OpenAI 早期的机制可解释性研究,也是推动用大模型自动解释神经元的核心成员之一。过去,他曾认为复杂神经网络内部存在大量难以拆解的特征纠缠,如今却提出了一个几近相反的判断。
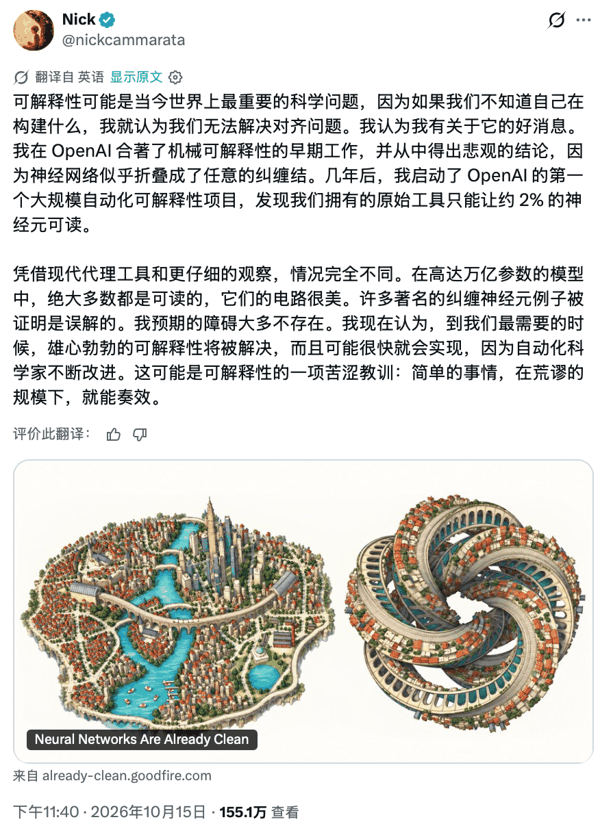 (来源:X) 所谓机制可解释性(Mechanistic Interpretability),就是尝试厘清 AI 模型内部负责不同任务的神经元及其连接回路,弄清楚模型究竟如何从输入一步步推导出输出。 这项研究有助于识别模型潜在的错误、偏见乃至欺骗性行为,一直是 AI 安全与对齐研究的重要方向。今年初, 《麻省理工科技评论》还将机制可解释性评为 2026 年“十大突破性技术”之一 。
不过,过去几年,这一领域始终面临一个难题。由于神经网络内部的运作机制远比研究人员预想的复杂,大量神经元似乎会同时响应多个毫不相关的概念,很难找到清晰、独立的功能。随着模型规模扩大,这种现象也愈发明显。研究人员因此不得不借助额外的特征分解工具,尝试从混杂的神经元活动中还原模型的内部结构。
在这篇长文中,Cammarata 首次提出了不同的判断。他认为,过去被视为神经网络内部结构混乱的许多证据,可能源于观察工具的局限,以及研究人员对模型学习规律的误判。 借助新的分析方法和 AI Agent,他发现主流大语言模型中的大多数神经元,实际上都能找到相对清晰的功能解释。
这一发现让他相信,真正理解 AI 的内部运作机制,或许没有此前预想的那么遥不可及。
 图|Nick Cammarata(来源:Facebook) 90% 的神经元功能,开始被破解
2023 年,OpenAI 公布了一项具有代表性的自动可解释性研究。团队利用 GPT-4 观察规模较小的 GPT-2,分析其神经元的响应规律,并生成自然语言解释,再检验这些解释能否准确预测神经元的激活情况。
这项研究首次展示了大规模自动化分析神经元的可能,但实际效果并不理想。 按照 Cammarata 在此次文章中的回顾,即使采用相对宽松的评估标准,当时的工具也只能可靠解释大约 1.7% 的神经元。 绝大部分神经元似乎都在同时处理多个互不相关的概念,而且模型越复杂,内部的混乱程度似乎就越高。
针对这种现象,学界逐渐形成了一种具有广泛影响力的假说,即“叠加”(Superposition)。
这一假说认为,神经网络的物理神经元数量有限,却需要表达数量庞大的现实特征。为了利用有限的空间存储更多信息,模型可能将互不相关的概念编码在相互重叠的方向上,导致单个神经元对多种不同特征产生响应。
基于这一认识,稀疏自编码器(Sparse Autoencoder,简称 SAE)等特征拆解技术在过去几年迅速发展。研究人员尝试训练额外的辅助模型,将原始网络中混杂的激活状态分解成更容易命名和理解的独立特征。包括 Anthropic 和谷歌 DeepMind 在内的研究团队,近年来都在这一方向上投入了大量资源。
但在 Cammarata 看来,研究人员可能过早地接受了神经网络中存在大量无关概念叠加的判断。
在对 Qwen3-32B 模型的初步审查中,他的团队估算,大约 90% 的神经元响应方向都对应着一个明确的主导功能,另有约 7% 表现为两个高度相关的功能,只有大约 2% 至 4% 的神经元暂时还无法找到清晰规律。 团队还表示,在包括 Kimi K3 在内的万亿参数级模型中,也观察到了类似现象。
当然,这些数据无法直接与 2023 年 1.7% 的结果比较。两项研究使用的模型架构、分析工具和评估标准均有差异,对于“单一功能”的具体定义也会影响统计结果。
但它至少提出了一种值得重新审视的可能性。过去大量神经元之所以看起来难以解释,或许与研究人员观察和理解它们的方式有关。
猫脸与汽车前脸,可能被研究人员看错了
最能直接体现这种认知变化的 ,是 机制 可解释性领域 一个常被引用的经典案例。
在早期视觉模型 InceptionV1 中,有一个神经元会同时对“猫脸”和“汽车前脸”产生强烈反应。按照人类的常识分类,猫和汽车完全是两类事物,因此,这个案例长期以来被用来说明,神经网络可能将毫不相关的概念编码在同一个神经元中。
然而,当 Cammarata 重新检查该神经元的激活样本,以及它与上下游神经元之间的连接时,却发现了一个此前被忽略的共同特征:这个神经元真正敏感的,是一种“尖锐且向外展开的 V 形几何结构”。
除了猫脸和汽车前脸,狐狸的面部轮廓、某些向上升腾的火焰或水柱,同样能够触发这个神经元的强烈反应;相反,柔和、圆润的形状通常会抑制它的激活。
换句话说,这个神经元识别的始终是一种跨越物体类别的基础视觉形状。它看起来同时理解了猫和汽车,实际上是因为这两种事物具有某些相似的几何结构。
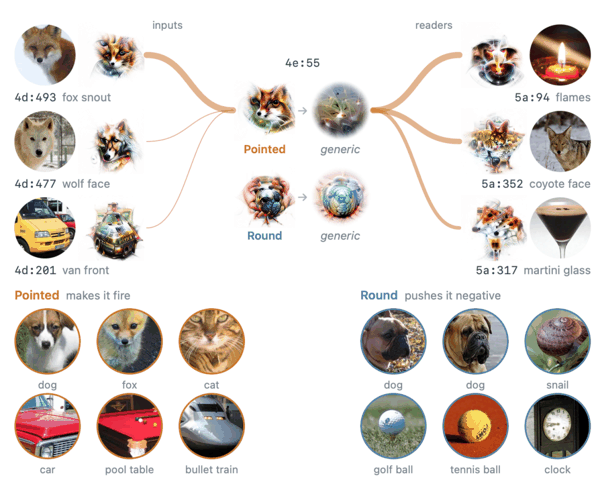 图|InceptionV1 中的神经元 4e:55 会对猫、狐狸、汽车等具有尖锐 V 形结构的图像产生响应,而圆润的形状则会抑制其激活(来源:Nick Cammarata)
另一些看似混乱的激活现象,则可能来自观察工具本身的偏差。早期用于分析神经元特征的可视化方法,有时会在生成图像中引入额外的纹理和伪影,让研究人员误判神经元的功能。在调整可视化方法并追踪相关连接后,一些此前令人困惑的响应,也能够通过不同物体共享的姿态和几何结构得到解释。
除了观察方法,模型架构也会影响神经元功能的清晰程度。
Cammarata 重新训练并比较了早期的 InceptionV1 和采用现代架构设计的 ConvNeXt 视觉网络。在训练数据相同、参数规模相近的条件下,采用残差连接等设计的 ConvNeXt,其最后一层约 99% 的神经元都具有相对清晰的功能;而结构较老的 InceptionV1,其末层神经元过去曾被认为普遍难以解释。
 图|ConvNeXt 视觉模型中的神经元及其高激活图像,展示了神经元对特定视觉概念的响应(来源:Nick Cammarata)
为了进一步验证神经网络如何分配有限的计算资源,他还设计了一项极端压缩实验。在实验中,他将 InceptionV1 某一层的神经元数量从 480 个减少到 10 个,再重新训练模型。
结果显示,原本分别负责识别特定角度曲线的神经元,在数量大幅减少后,没有变成由各种无关概念随机混合的结构,而是逐渐形成了对“连续曲线”“闭合环形”等更宽泛几何模式的响应。
这些实验让 Cammarata 提出了另一种解释:神经网络可能通过不断概括已有特征,逐步形成更复杂的认知结构。
当模型容量有限时,单个神经元需要负责范围更广的特征;随着模型容量增加,不同神经元又能够进一步分化,分别处理更细致的概念。他将这一过程称为“递归泛化”(Recursive Generalization)。
在语言模型中,也能观察到类似的现象。例如,一个对字母组合 “iy” 产生反应的神经元,可能同时响应包含相关字母组合的 “diy”,并进一步延伸到语义相关、却不包含相同字母的 “do it yourself”。
如果只观察最终的激活结果,这些响应可能显得缺乏关联。但沿着它们的特征联系继续分析,就有可能找到一条从字母组合到词汇、再到语义概念的解释路径。
这也意味着,研究人员如果只是孤立地统计某个神经元会被哪些词语或图像激活,很容易忽略不同响应之间的联系。要理解它真正承担的功能,还需要结合它在整套计算回路中的位置,分析它接收了哪些信息,又向下游传递了什么。
让 AI 研究 AI,可解释性会走向哪里?
除了对神经网络结构提出新的解释,Cammarata 这项研究的另一个重要变化,是引入具备自主分析能力的 AI Agent,将原本高度依赖人工的研究过程逐步自动化。
2023 年,GPT-4 已经能够为神经元生成自然语言解释,但主要依靠归纳已有的激活样本。如今,AI Agent 能够连续完成更复杂的研究任务:观察激活数据、提出功能假说、检查上下游连接,并设计新的实验进行验证。如果某个假说无法解释全部现象, Agent 还可以主动寻找反例,帮助研究人员修正原有判断。
Cammarata 在文中介绍了一套十分有说服力的“盲测”机制。
首先,让一个 AI Agent 根据神经元的激活规律,写出详细的功能解释。随后,将这份解释交给另一个独立 Agent。后者无法接触目标神经元的参数和激活数据,只能根据文字描述,自行构造出最有可能激活该神经元的新文本。
在部分实验中,这些由 AI Agent 生成的测试文本,激活强度甚至超过了研究人员此前从上百亿 Token(词元)的语料库中筛选出的所有真实样本。
这一结果的重要性在于,一份可靠的神经元解释应该具有预测能力。研究人员不仅需要解释它过去为什么被激活,还需要预测什么样的新输入能够再次触发它。
在一项涉及 200 个随机抽取神经元的测试中,研究人员要求 AI Agent 根据已有解释,分别生成预测能够激活神经元的正向样本,以及语义相近、但不应产生明显激活的反例。 结果显示,在能够有效评估的正向解释中,76% 的新生成正向样本引发了强烈的神经元激活,而反例的误激活率仅为 11%。
这些结果为神经元解释的预测能力提供了定量证据。不过,即使一份解释能够准确预测大量新样本,也无法保证它已经覆盖该神经元的所有功能。
在更大规模的分析中,团队还利用 AI Agent 检查了多达 10 万张归因图,尝试沿着神经元之间的信息传递路径,追踪不同计算环节如何共同影响模型的输出。
Cammarata 认为,这类研究具有明显的累积效应。随着越来越多神经元的功能得到解释,研究人员可以利用已有的连接关系,进一步推断那些尚未理解的部分,逐步构建更加完整的神经网络功能地图。